摘要
- reCAPTCHA 将已知答案的单词与尚待辨认的扫描词配对,让网站入口同时承担身份测试和文字转录。
- 2008 年论文规定,前三个人的答案一致且都不同于两套 OCR 的猜测时,这个词才会进入后续考题;抄录入库另有较低门槛。
一道考题也能升职。先让人皱眉头,等三个人给出一致答案,它便有机会坐到桌子另一边,判断后来的人有没有答对。早期 reCAPTCHA 的这套人事制度,管的是旧书里的单词。
Carnegie Mellon University 的2007 年项目介绍描述了一个务实交换:访客想进入网站,系统借机请他认一认光学字符识别程序没读懂的印刷文字。模糊的旧字于是搭上网页表单,等待一双新的眼睛。
具体怎样判卷,写在团队的2008 年原论文里。系统先让两套 OCR 读取扫描页,比较输出和英语词典。两套结果不同,或词不在词典里,都会触发人工辨认。题目放两个词,一个答案已知,一个待解,位置随机,再加上图像扰动。
访客答对已知词,另一项输入就成为待解词的候选答案。同一个待解词还会交给别人看,每回采用不同的扰动。一次成功通关,留下的是一张票;后台还得数票。
抄进书里,与拿去考人
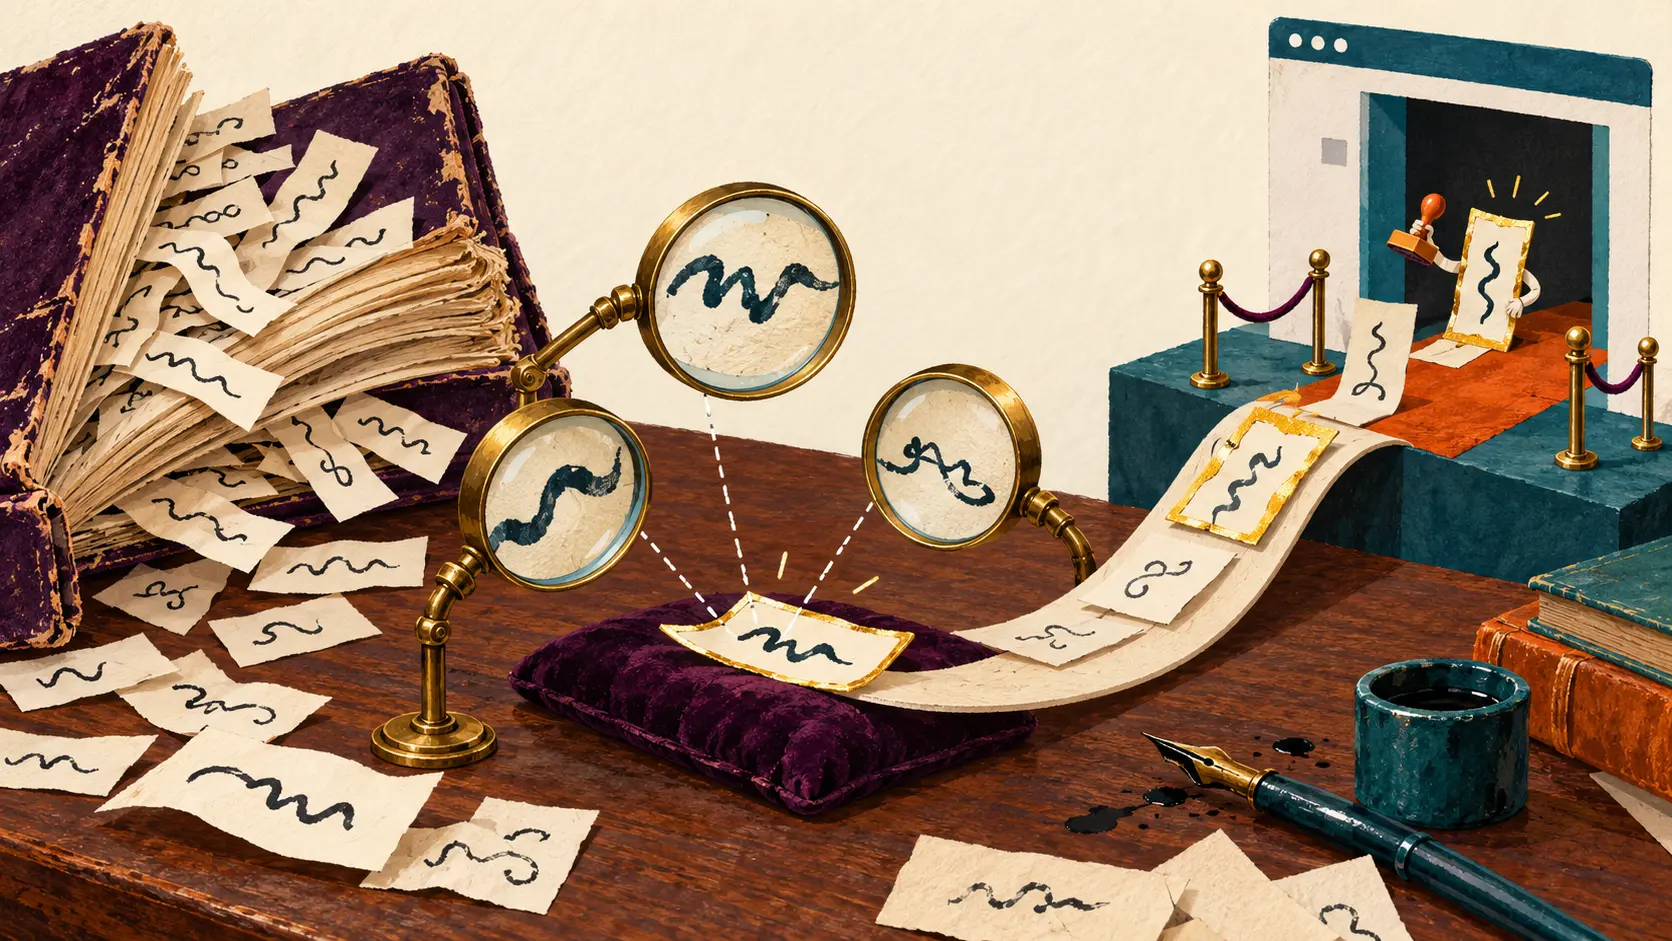
计票规则颇有意思:人的答案一票,OCR 的答案半票;转录采用的拼写至少要拿到 2.5 票。因此,两个人意见一致,再得到一套 OCR 的支持,就可以达到抄录门槛。
升格为考官,要求更高。最先三个人必须答得一样,而且与两套 OCR 的答案都不同,这个词才能变成以后使用的已知词。原本让机器犯难的地方,由人确认后,成为机器用来检查人的材料。考生帮忙印了下一场考试的卷子。
当然,印刷品也有实在看不清的地方。若一个词在得到认可拼写前被六名用户拒绝,系统就把它按无法辨认处理。换一组题的按钮,也在替档案清理悬案。
这件事的起点很具体:学校在 2009 年的原始公告记载,reCAPTCHA 于 2007 年推出,相关公司在 2008 年成立,2009 年被 Google 收购。回看早期设计,网页入口获得了一种生产能力:它收集答案,也生产将来用来验收答案的标准。看起来只是填了两个词,后台已经办完一场小型晋升。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance