요약
- 2007년에 등장한 reCAPTCHA는 답을 아는 단어와 아직 읽지 못한 단어를 묶어, 방문자 확인과 옛 인쇄물의 문자화를 함께 수행했다.
- 2008년 설계에서 모르는 단어가 검사용 단어가 되려면 처음 세 사람의 답이 일치하고 두 OCR의 추정과 모두 달라야 했다.
컴퓨터가 못 읽는다고 사람에게 물어본 단어가, 얼마 뒤 사람의 답을 검사한다. 초기 reCAPTCHA의 승진 속도는 제법 빨랐다. 낡은 책의 흐릿한 글자에도 관리직으로 가는 길이 있었던 셈이다.
Carnegie Mellon University의 2007년 프로젝트 소개는 이 거래를 설명한다. 사이트에 들어가려는 이용자가 광학 문자 인식 프로그램, 즉 OCR이 읽지 못한 인쇄물을 판독한다. 입력창 앞에서 들인 짧은 수고가 오래된 자료를 문자로 옮기는 작업에 보태졌다.
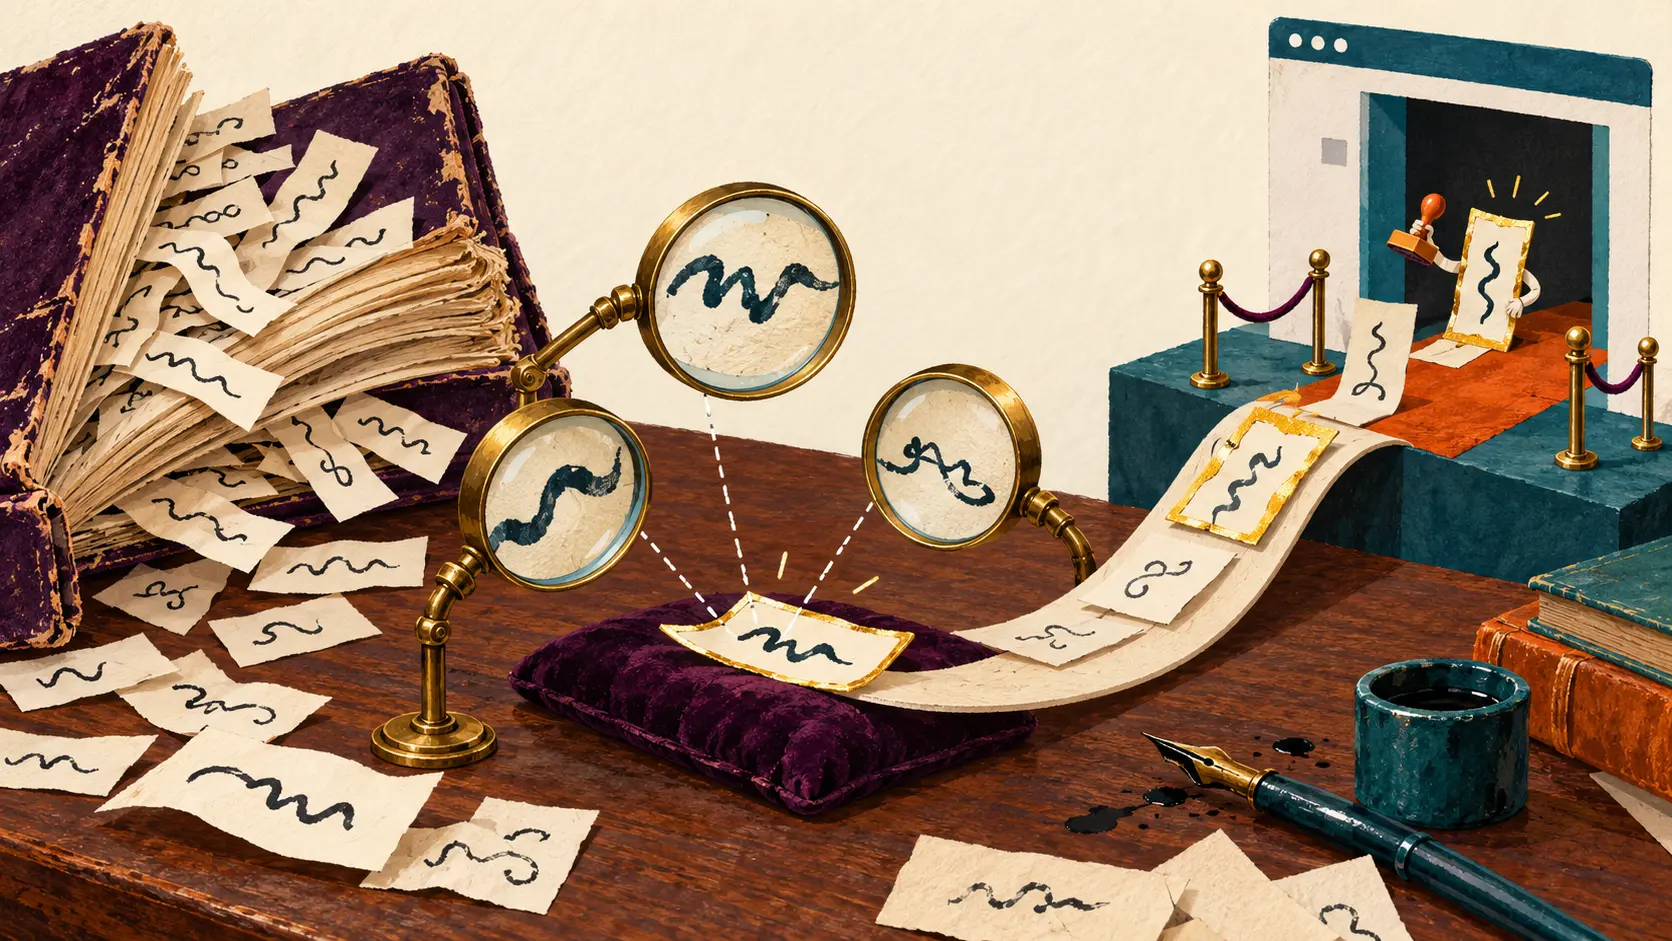
답도 모르는 문제를 내고 어떻게 채점했을까. 연구진의 2008년 원논문에 나온 방법은 두 단어를 한 조로 만드는 것이었다. 하나는 답을 아는 검사용 단어, 다른 하나는 미해독 단어다. 순서를 무작위로 바꾸고 이미지를 더 일그러뜨렸다. 검사용 단어를 맞힌 사람의 다른 답은 미해독 단어에 대한 유력한 후보로 기록했다. 같은 단어를 다른 사람에게 보여줄 때는 왜곡 방식도 바꿨다.
글로 남길 답과 남을 시험할 답
문자를 확정할 때는 사람의 답에 1표, OCR의 답에 0.5표를 부여하고 최소 2.5표를 요구했다. 두 사람과 OCR 하나가 같은 답을 내면 판독을 확정할 수 있었다.
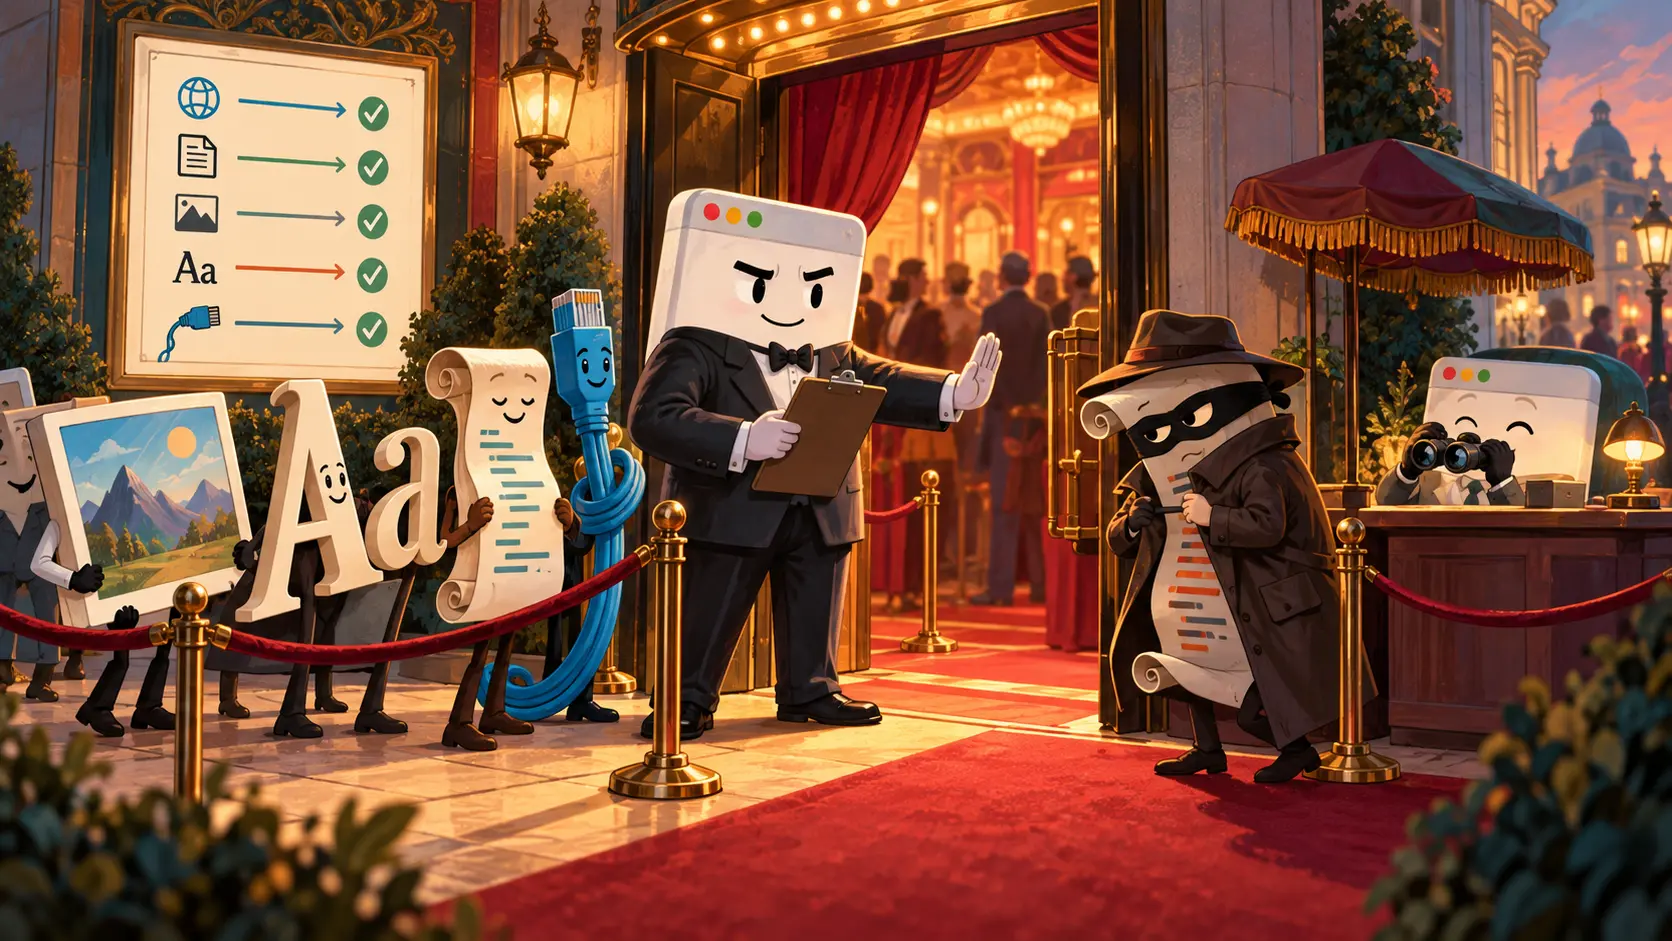
검사용 단어로 승격되는 조건은 더 까다로웠다. 처음 세 사람의 답이 서로 같으면서 두 OCR의 답과 모두 달라야 했다. 이 조건을 통과한 단어는 다음 방문자를 시험할 수 있었다. 앞사람이 푼 문제가 뒷사람의 시험지 제작에 투입되는 구조다.
처음부터 모든 단어를 사람에게 맡기지도 않았다. 두 OCR의 출력이 다르거나 영어 사전에 없는 단어를 추려 질문했다. 반대로 판독이 확정되기 전에 여섯 사람이 거부한 단어는 읽을 수 없는 것으로 제외했다. 다른 문제를 요청하는 버튼까지 자료 정리에 쓰인 것이다.
학교의 2009년 발표에 따르면 서비스는 2007년에 등장했고, 회사는 2008년에 설립됐으며, 2009년에 Google이 인수했다. 초창기 설계의 재미는 단어의 두 번째 직업에 있다. 방문자는 옛 글을 복원하는 동시에, 일정한 조건 아래 다음 방문자를 검사할 기준도 만들었다. 입력창은 답을 받아 두는 데서 그치지 않고 다음 시험을 준비했다.
회원 브리핑
프로필 심층 컨텍스트
올바른 멤버십 등급으로 로그인하면 전체 브리핑과 출처 노트를 볼 수 있습니다.
Strategic Circle 전용
Strategic Circle
모든 독자에게 공개됩니다. 가입 후 로그인하면 프로필 브리핑를 열람할 수 있습니다.
Strategic Circle 가입하기Leadership Alliance 전용
Leadership Alliance
자격을 갖춘 IP 자산 소유자 및 운영진을 위한 콘텐츠입니다. 로그인하면 Leadership Alliance 브리핑을 열람할 수 있습니다.
Leadership Alliance 가입하기