Resumen
- reCAPTCHA apareció en 2007 con una doble tarea: comprobar al visitante de una web y aprovechar su lectura para transcribir material impreso.
- El diseño de 2008 exigía más para convertir una palabra en pregunta de control que para aceptar su transcripción.
Hay palabras que hacen carrera. En el primer reCAPTCHA, una que los programas no conseguían leer podía terminar examinando a las personas. Bastaba con superar una selección bastante más seria que muchas promociones de oficina.
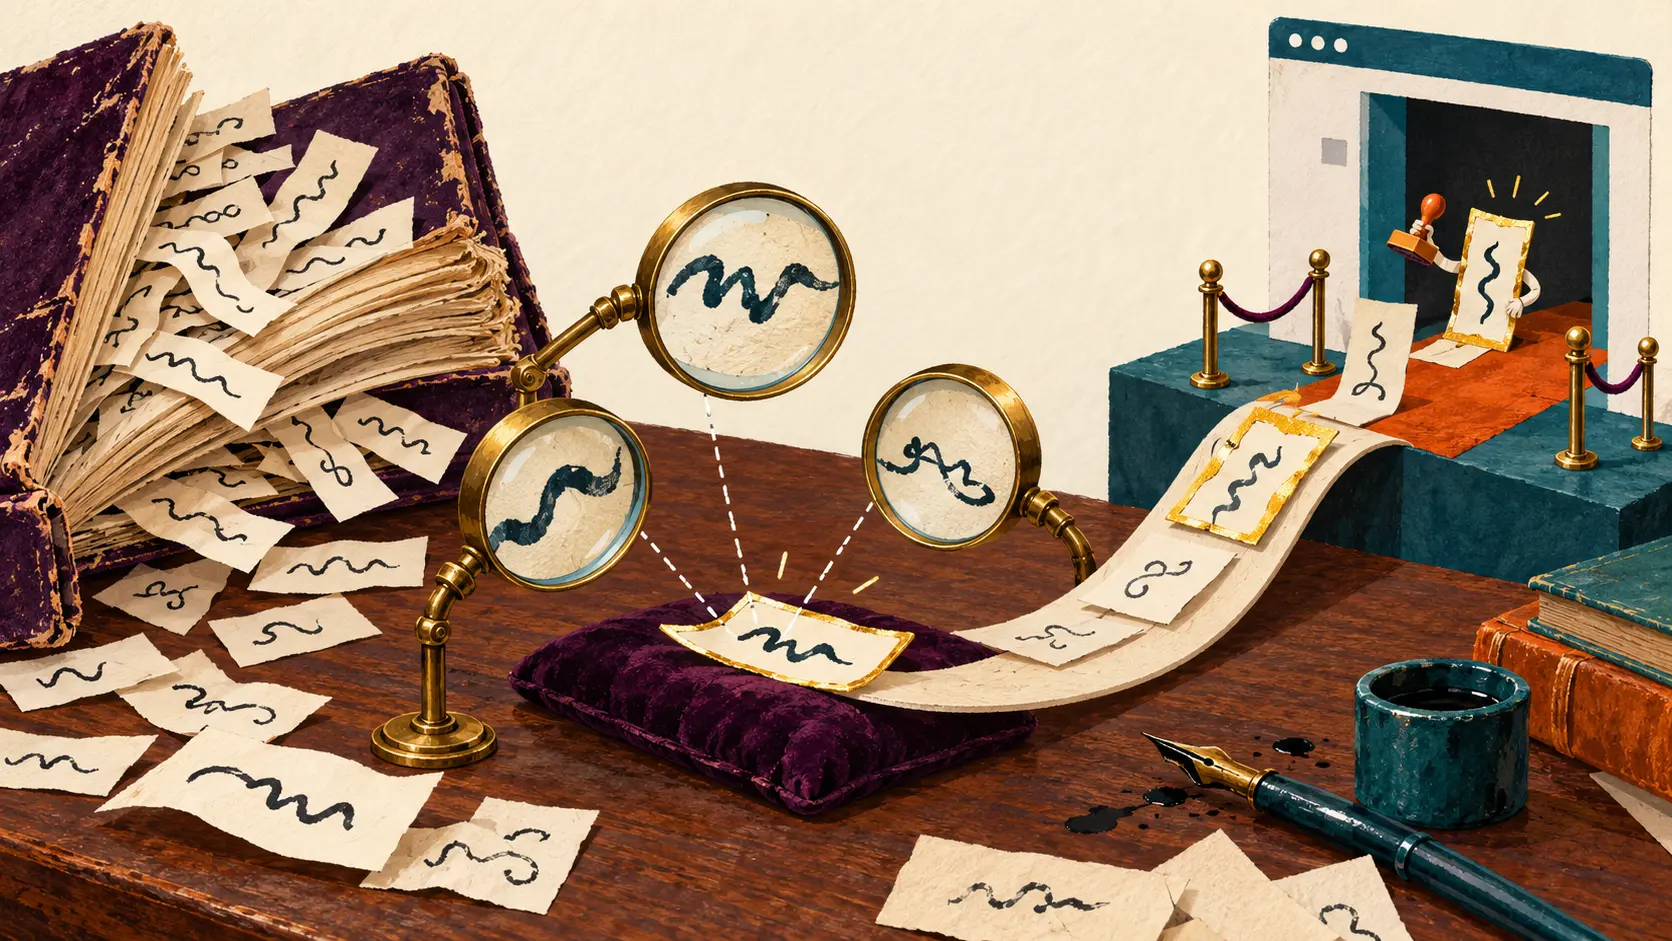
El artículo original de 2008 describe la condición: las primeras tres respuestas humanas debían coincidir entre sí y diferir de las dos propuestas de los programas de reconocimiento óptico de caracteres, u OCR. Entonces la palabra desconocida podía convertirse en palabra de control. Lo que había necesitado ayuda humana pasaba a comprobar las respuestas de otros humanos.
La operación empezaba con dos palabras en pantalla, una conocida y otra pendiente de lectura. Se alteraban las imágenes y se cambiaba aleatoriamente el orden. Acertar la conocida daba valor a la otra respuesta como propuesta de transcripción. Esa palabra se presentaba también a otros visitantes, con distintas deformaciones.
El archivo llevaba su propia contabilidad
Para aceptar una lectura, cada respuesta humana valía un voto y cada propuesta de OCR medio voto; el mínimo era 2,5. Dos personas y un OCR de acuerdo podían completar la transcripción. Convertirse en pregunta para futuros visitantes requería cumplir la condición más exigente de las primeras tres respuestas. El archivo y la mesa del examinador tenían distintas puertas de entrada.
Había filtros al principio y al final. El sistema comparaba dos lecturas automáticas y un diccionario inglés para localizar palabras sospechosas. Si seis usuarios rechazaban una palabra antes de que se aceptara una lectura, se descartaba como ilegible. Pedir otras palabras también producía información sobre los límites del material.
La presentación de Carnegie Mellon University de 2007 explica la apuesta práctica: el esfuerzo para entrar en una web ayudaba a recuperar textos impresos que la máquina no lograba descifrar. La entrada al sitio se había convertido en un pequeño taller de transcripción, abastecido por gente que venía a hacer otra cosa.
Según la cronología institucional publicada en 2009, el servicio se introdujo en 2007, la empresa se fundó en 2008 y Google la adquirió en 2009. El detalle revelador de aquella primera etapa está en el ascenso de la palabra: los participantes producían texto recuperado y, bajo reglas específicas, nuevas pruebas. Al entregar el examen, ayudaban a preparar el siguiente.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance