要約
- 2007年に登場した reCAPTCHA は、答えが分かっている単語と未解読の単語を組み合わせ、認証への入力を文字起こしにも使った。
- 2008年の設計では、最初の3人の回答が一致し、両方のOCRの回答と異なる場合に、その単語を次の認証問題へ採用した。
字が読めないので人に教わる。教わったら、今度は別の人を採点する。初期 reCAPTCHA に登場した単語の出世は、なかなか早い。もちろん昇格には条件があった。
Carnegie Mellon University の2007年の紹介では、古い印刷物で機械が読み取れない文字を、ウェブの利用者に読んでもらう仕組みが説明されている。サイトへ進みたい人の手間を、資料の文字起こしに結び付けた。
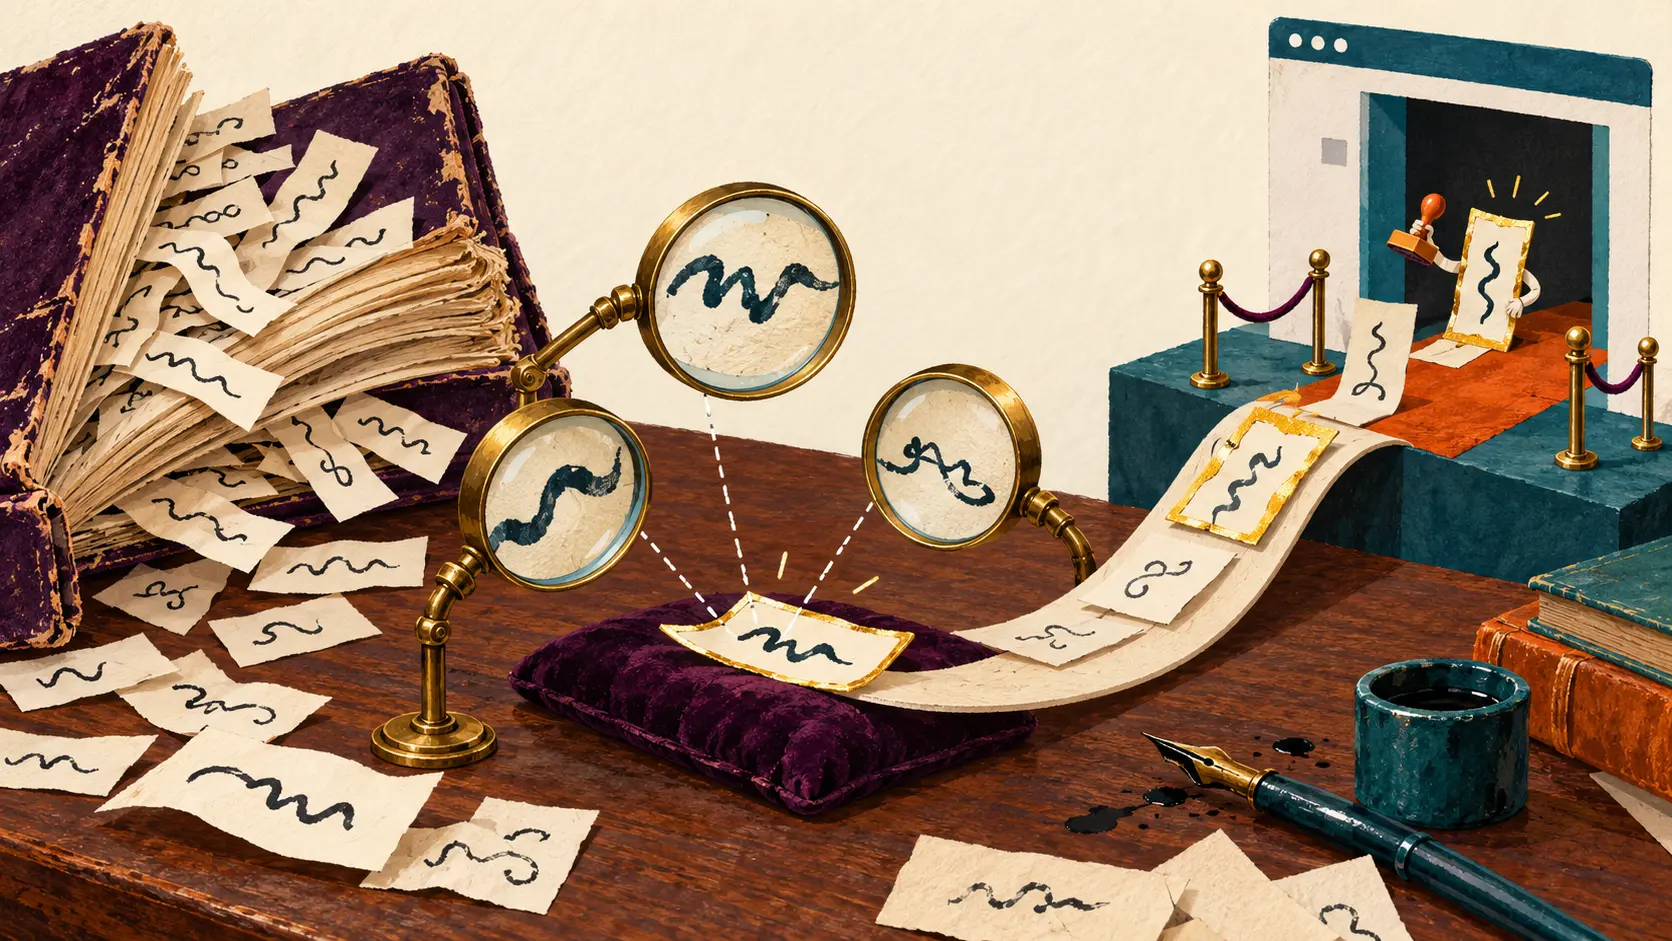
ただし、答えが不明な問題だけを出しては採点できない。そこで研究チームの2008年の論文に登場するのが、既知と未知の2語を並べる方法だ。既知の語に正しく答えた人のもう一方の入力を、未知の語の候補として記録する。順序はランダムで、同じ未知語を別の人に出す際には画像のゆがみも変えた。
正解欄に入るための審査
最初の3人の答えが一致し、しかも2種類の光学文字認識ソフト、OCRの答えのどちらとも違う。その条件を満たすと、未知語が既知の確認用単語に昇格する。機械を困らせた古い文字が、今度は機械の側で利用者を試すわけだ。
文字起こしとして採用する条件は別にある。人の答えを1票、OCRの答えを0.5票と数え、2.5票以上を必要とした。2人の答えが一致し、片方のOCRも同じなら、その読みを採用できる。しかし、これだけでは確認用単語への昇格条件を満たさない。資料に書き込める答えと、他人の答案を測る物差しには、違う審査がある。
出題候補もあらかじめ選んだ。2種類のOCRの結果が食い違う、あるいは英語辞書に載っていない語を拾う。一方、読みが確定する前に6人が拒否した語は、判読不能として除外した。新しい問題を求める操作も、資料の選別に一役買っていた。
2009年の大学発表によれば、サービス開始は2007年、会社設立は2008年、Googleによる買収は2009年。初期の仕掛けを見ると、ウェブの入口に集まった人は古い文章を読むだけでなく、次の入口で使う問題も育てていた。試験を受けたつもりが、問題集の改訂まで手伝っている。ずいぶん働き者の入力欄である。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加