Résumé
- Lancé en 2007, reCAPTCHA associait un mot connu à un mot encore indéchiffré pour faire travailler la vérification d'accès au service des archives.
- Le dispositif décrit en 2008 distinguait la validation d'une transcription de la promotion d'un mot au rang de future question de contrôle.
Les vieux livres avaient trouvé un petit emploi à l'entrée des sites web. Leurs mots les plus récalcitrants y examinaient les visiteurs, après avoir eux-mêmes passé un examen. La paperasse, pour une fois, se recyclait admirablement.
Le portrait du projet publié en 2007 par Carnegie Mellon University explique l'échange : en déchiffrant une épreuve, l'internaute aidait à convertir en texte des imprimés que la reconnaissance optique de caractères, ou OCR, n'arrivait pas à lire. La démarche ordinaire d'accès à un site apportait du travail à un chantier documentaire.
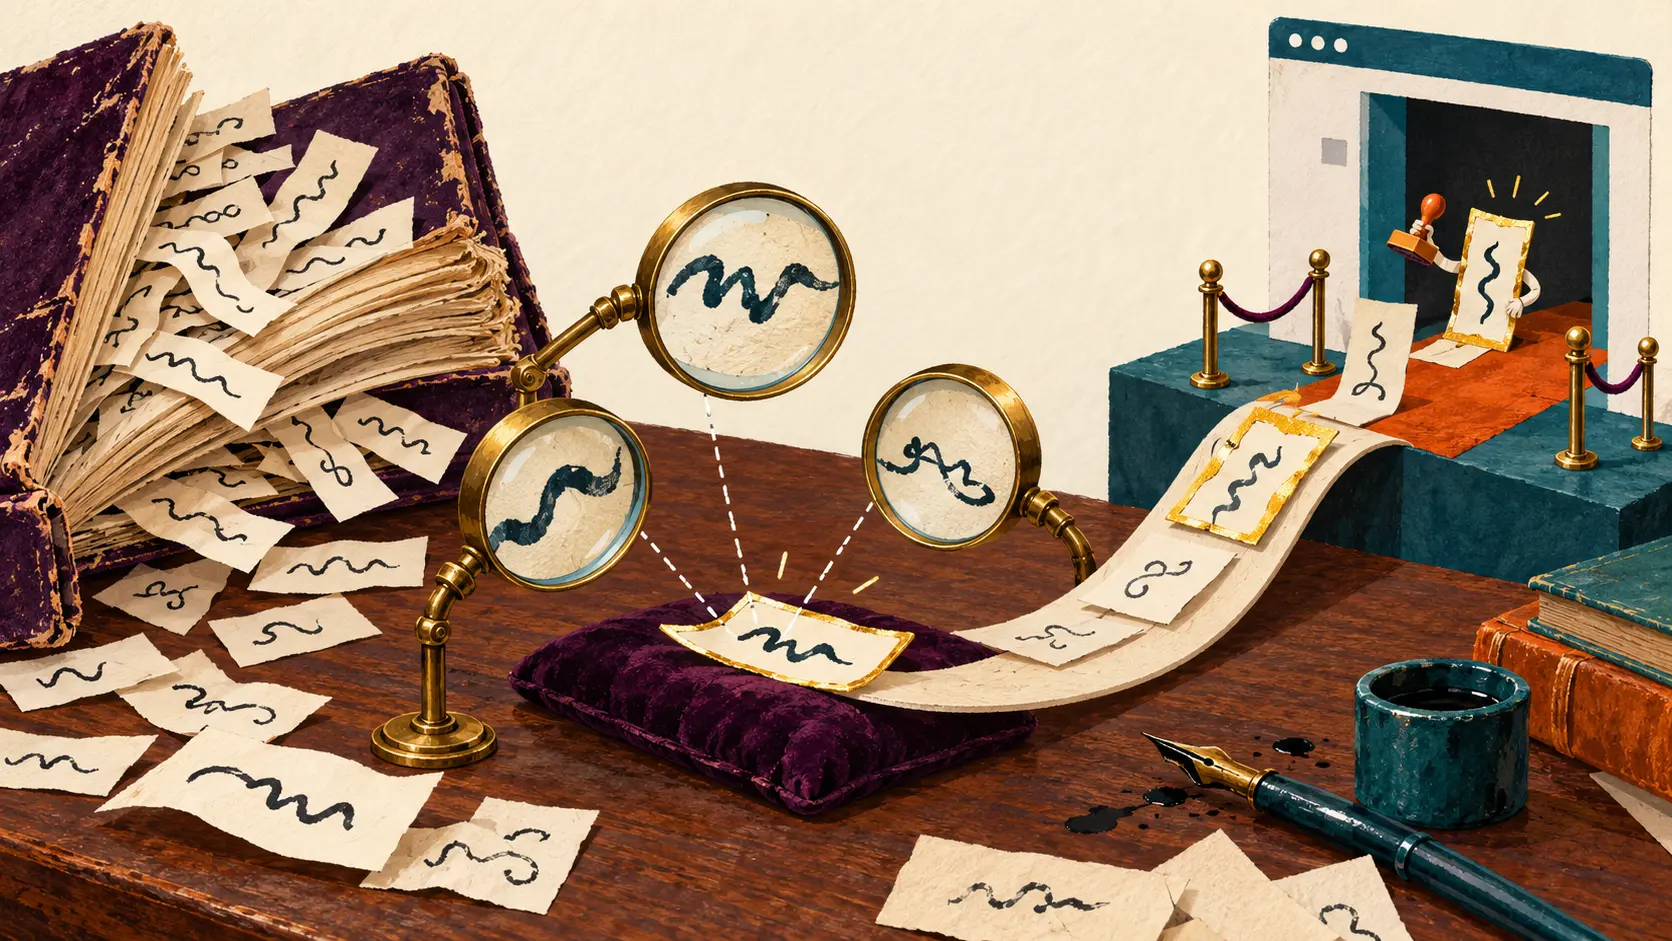
Restait une difficulté savoureuse : comment noter quelqu'un sur un mot dont on ignore la réponse ? Le papier original de 2008 détaille le montage. Un mot connu accompagnait le mot à déchiffrer, dans un ordre aléatoire. Une réponse correcte au premier rendait la seconde recevable comme proposition de lecture. Plusieurs visiteurs recevaient le même inconnu, déformé différemment.
Le candidat passe derrière le bureau
Pour recruter un mot de contrôle, les trois premières réponses humaines devaient coïncider et différer des réponses des deux logiciels d'OCR. Le mot pouvait alors examiner d'autres visiteurs. Une difficulté de lecture, résolue collectivement, devenait un instrument de vérification.
Pour simplement retenir une transcription, le barème était différent : une réponse humaine valait un point, celle d'un OCR un demi-point, et il fallait atteindre 2,5. Deux humains d'accord avec un logiciel pouvaient donc fournir la lecture retenue. Accéder au texte d'archive et accéder au jury constituaient deux promotions distinctes.
Le recrutement commençait avant le navigateur. Les deux OCR étaient comparés entre eux et à un dictionnaire anglais ; une divergence ou une absence du dictionnaire signalait un mot suspect. À l'autre bout, six refus d'utilisateurs avant validation d'une lecture faisaient sortir le mot comme illisible. Même le bouton permettant de changer d'épreuve participait au tri.
La chronologie conservée par l'université en 2009 situe le lancement en 2007, la création de l'entreprise en 2008 et son acquisition par Google en 2009. L'ingéniosité de cette première période tient à ce circuit : les visiteurs alimentaient le texte à conserver, mais aussi les questions destinées à leurs successeurs. À peine votre copie rendue, un bout pouvait servir au prochain examen.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance