Resumo
- Apresentado em 2007, o reCAPTCHA usava uma palavra conhecida e outra desconhecida para combinar a verificação de visitantes com a transcrição de impressos.
- Na descrição de 2008, uma palavra só virava questão de controle se as três primeiras leituras humanas coincidissem e fossem diferentes das duas respostas de OCR.
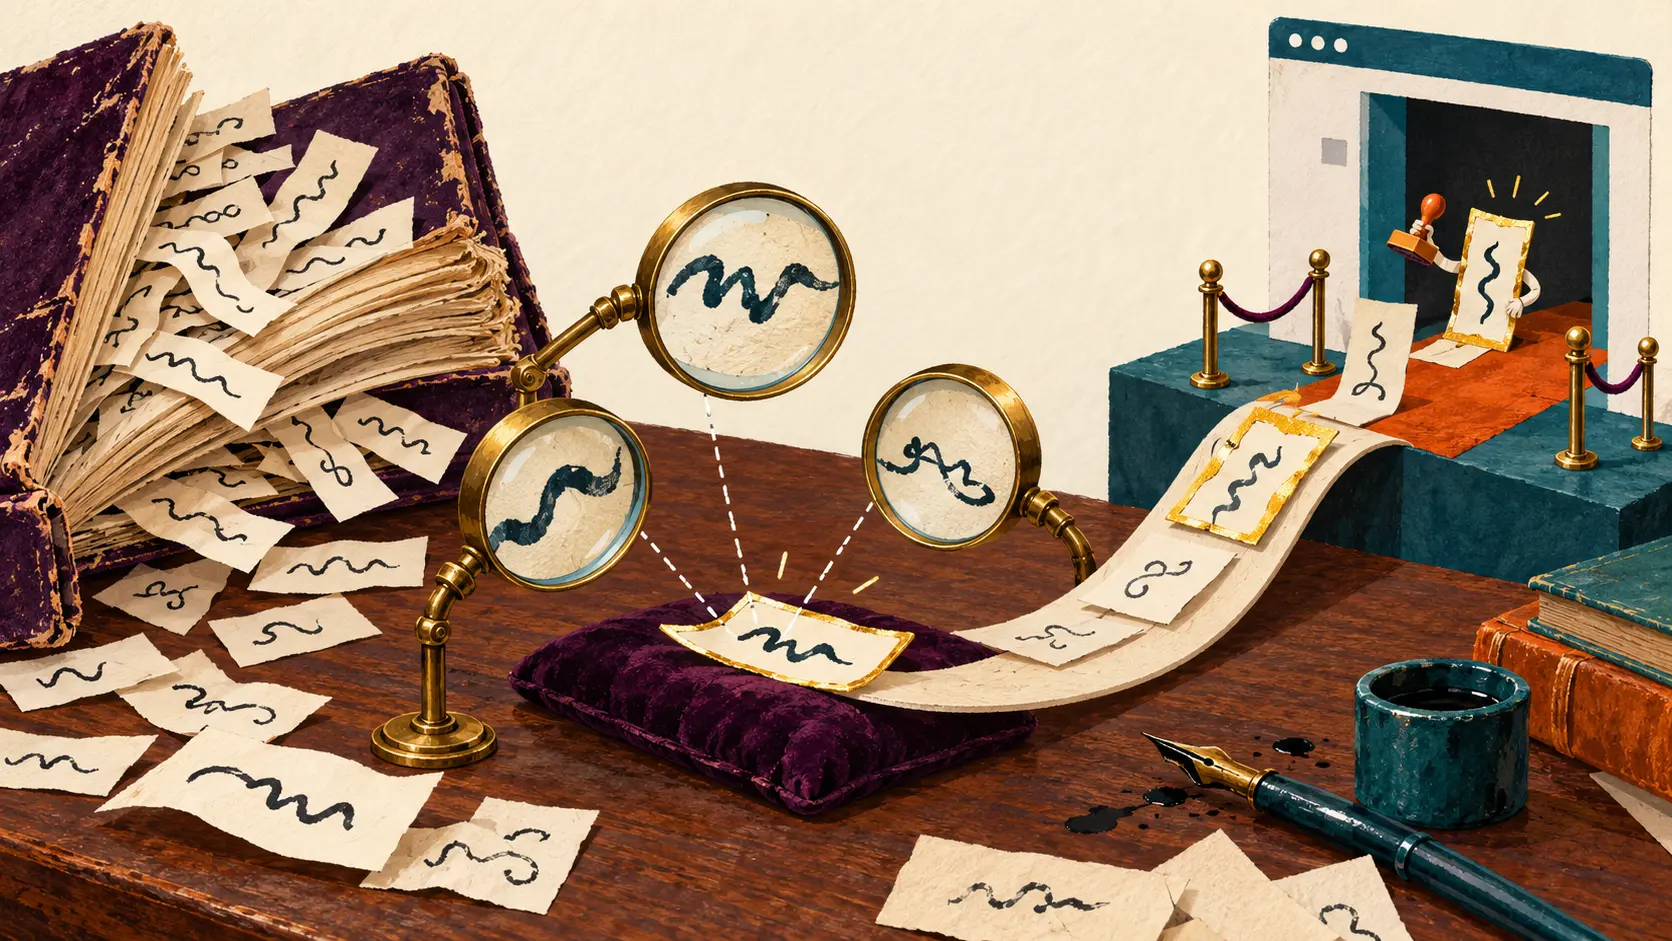
A burocracia encontrou uma boa candidata: uma palavra de livro velho que o computador não conseguia ler. Depois de receber ajuda de três pessoas, ela podia assumir a fiscalização das próximas. Era uma ascensão respeitável para quem começara como borrão.
O reCAPTCHA apareceu em 2007. A apresentação daquele ano por Carnegie Mellon University descreve o acordo: enquanto tentava acessar um site, o visitante lia trechos que o reconhecimento óptico de caracteres, ou OCR, não havia resolvido. A vontade de passar pelo formulário fornecia trabalho para recuperar o texto de páginas impressas.
O artigo da equipe publicado em 2008 abre a caixa da correção. Uma palavra com resposta conhecida acompanhava outra ainda sem leitura aceita. A ordem era aleatória e as imagens recebiam distorções. Ao acertar a conhecida, o usuário fornecia uma resposta plausível para a desconhecida, que também seria mostrada a outras pessoas com novas distorções.
A promoção exigia outra nota
Para entrar no conjunto das palavras de controle, as três primeiras respostas humanas precisavam ser iguais entre si e diferentes das respostas dos dois programas de OCR. O resultado passava, então, a servir de prova para novos visitantes. A ajuda recebida virava capacidade de fiscalizar.
Transcrever tinha um cálculo próprio. A resposta de uma pessoa valia um voto; a de um OCR, meio. A leitura precisava somar pelo menos 2,5 votos. Assim, duas pessoas de acordo com um OCR podiam resolver a transcrição, sem preencher o requisito para transformar aquela palavra em controle. O livro e a portaria usavam critérios diferentes para aceitar o mesmo material.
Antes de tudo isso, o sistema comparava os dois OCRs e um dicionário inglês para selecionar palavras suspeitas. No fim da fila havia outra saída: seis recusas antes da escolha de uma grafia faziam a palavra ser descartada como ilegível. Até pedir um novo desafio ajudava a organizar o acervo de dúvidas.
A nota institucional de 2009 registra a sequência: lançamento em 2007, criação da empresa em 2008 e aquisição pelo Google em 2009. O desenho inicial já reunia duas entregas. Os visitantes recuperavam texto e ajudavam a montar o próximo teste. O formulário cobrava poucos segundos, mas sabia dar mais de um destino ao serviço.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance