摘要
- Creative Commons 的 2002 年发布公告把许可分为通俗摘要、法律文本和数字代码,后者供搜索引擎等程序识别使用条件。
- 2008 年 4 月 8 日的 ccREL 1.0 原文记载,早期方案建议在 HTML 注释内写 RDF/XML;新版改用可扩展的属性模型,并以 RDFa 等方式发布。
授权要让三种读者都找得到
创作者可以提前允许别人使用作品,但如果每个后来者仍得先找人、再问一遍条件,公开授权的效率就打了折。2002 年的发布公告给一份许可安排三项工作:Commons Deed 用简单语言解释,Legal Code 承担法律文本,Digital Code 帮程序按使用条件识别作品。这不是给合同换一个漂亮图标,而是要降低发现已获许可作品的成本。
Creative Commons 对许可层级的说明确认,真正起法律作用的是法律文本。数字标签负责指出决定属于哪件作品、适用哪份许可、署名应指向何处。页面上人眼可见的许可徽章,不会自动把这些关系告诉搜索工具。标签若缺少清楚的挂靠位置,机器就只能在网页源码里摸索。
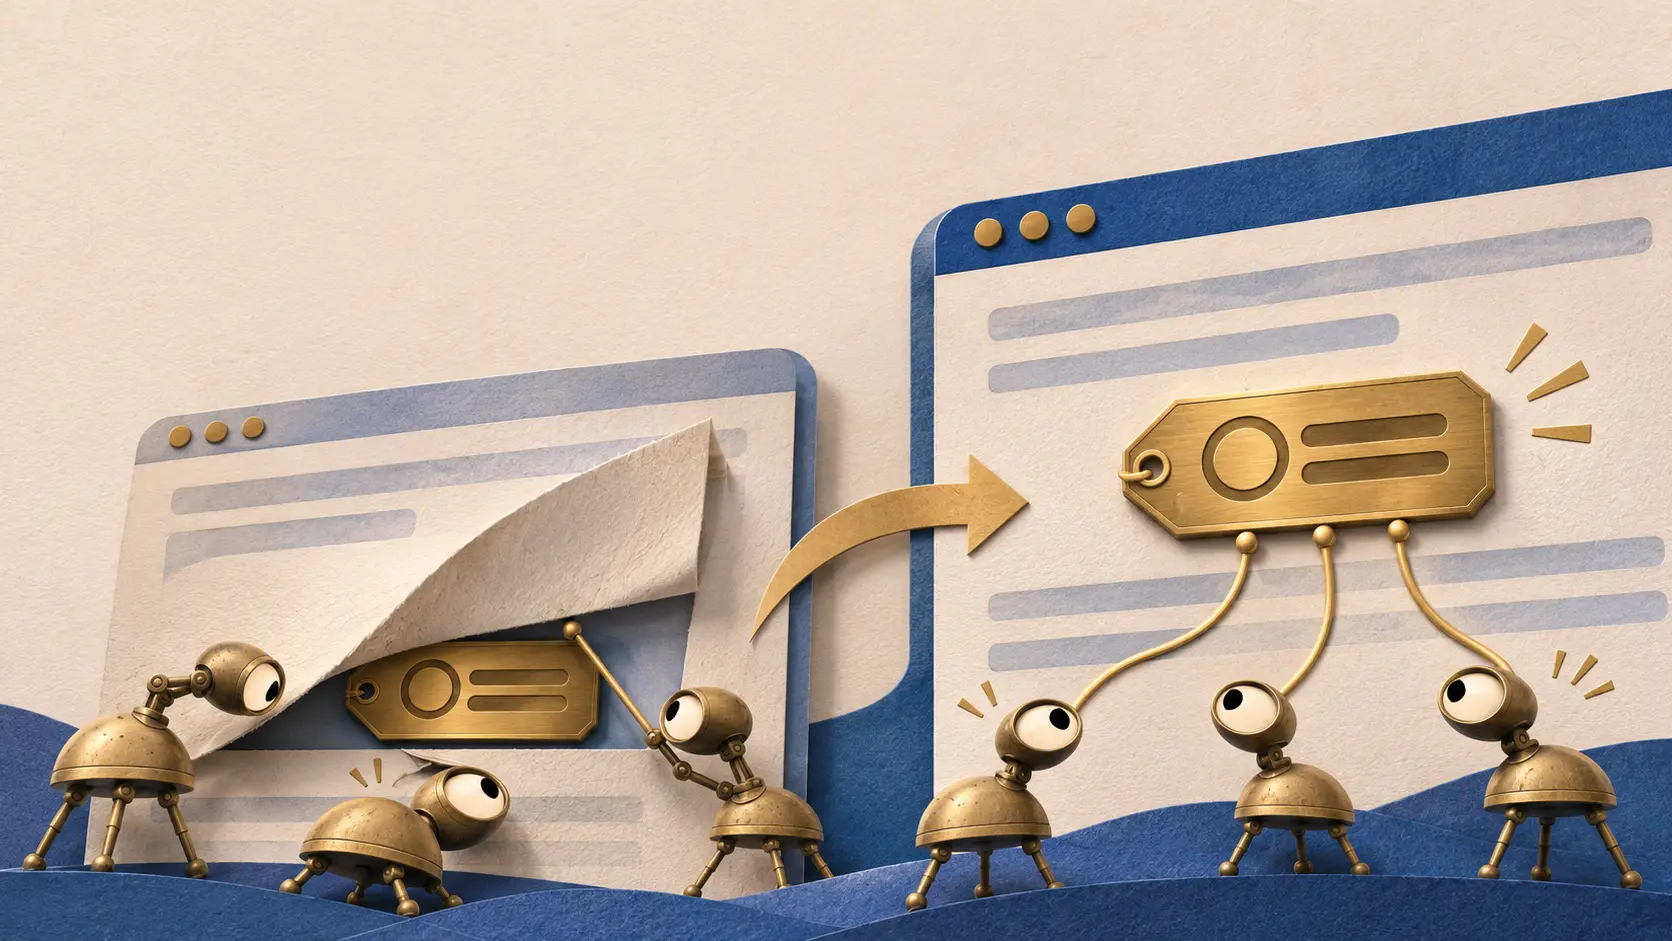
最初的挂法很别扭。ccREL 作者在 2008 年回顾,早期在线生成器会给发布者一段 RDF/XML,让其贴在 HTML 注释中。程序确实能读取源码中的数据;只是它得先找出注释,再解析内容,最后判断标签对应页面上的哪项作品。作者承认当时就知道这方法笨重。RDF/XML 是可用的 RDF 标准语法,结构化资料与可见 HTML 混写却尚无成熟的共同方法。
标签藏起来,找标签的人就得加班
网页越来越多,接口债也越来越贵。2008 年 ccREL 文件指出,已有数以百万计的页面包含许可与元数据,工具开发者却没有统一且可扩展的读取办法,只能各自写提取技巧。人看着网页上的许可声明觉得一清二楚;软件则要猜注释在哪、指向哪件作品、哪一段是署名信息。机器可读四个字,替机器省下的工作并不多。
ccREL 调整了分工。它把作品属性和许可属性定义为可扩展的 RDF 模型,不再把某一种具体编码格式当成全部答案;发布者必须让提取路径可发现。文件推荐网页使用 RDFa,独立媒体使用 XMP。在网页示例里,许可关系和署名信息连在可见的元素上。W3C 2008 年的 RDFa 建议书提供了这类 HTML 属性的规范背景。
这次变化更新的是元数据包装。ccREL 原文说,它取代了以前表达许可元数据的建议,同时第一代许可证仍可由新的属性模型解释。创作者原有的授权决定不因注释方案退场而被改写。发布者负责把信息贴到正确作品上;工具作者可以沿共同路径读取,不必为每家网页设计侦探故事。
标签是路标,不是门锁
权利元数据告诉程序,权利人宣告了什么。Creative Commons 2009 年的说明把权利表达与监控、阻止文件使用分开。法律文本决定许可条件;数字代码帮助别人找到它。改好标签的收益在于减少搜索和理解的摩擦,让已经愿意分享的作品更容易被按其条件使用。
这段历史藏在网页源码的一个小角落。2002 年,Creative Commons 把机器可读纳入许可证设计,却把标签放在注释的折页后。2008 年,ccREL 让作品、许可和署名的关系更容易被工具看见。授权决定依旧来自权利人;互联网只是学会了把决定贴在不必猜的位置。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限战略圈层会员
战略圈层
所有读者均可浏览。加入并登录后可解锁档案简报。
加入战略圈层仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance