要約
- 2002年12月のCreative Commons発表は、ライセンスを平易な要約、法的な本文、ソフトウェア向けのデジタルコードに分けていた。
- 2008年4月8日付のccREL 1.0は、当初のRDF/XMLをHTMLコメントへ置く方法を記録し、作品とライセンスの属性モデルやRDFaなどの掲載方法に置き換えた。
許可しただけでは見つからない
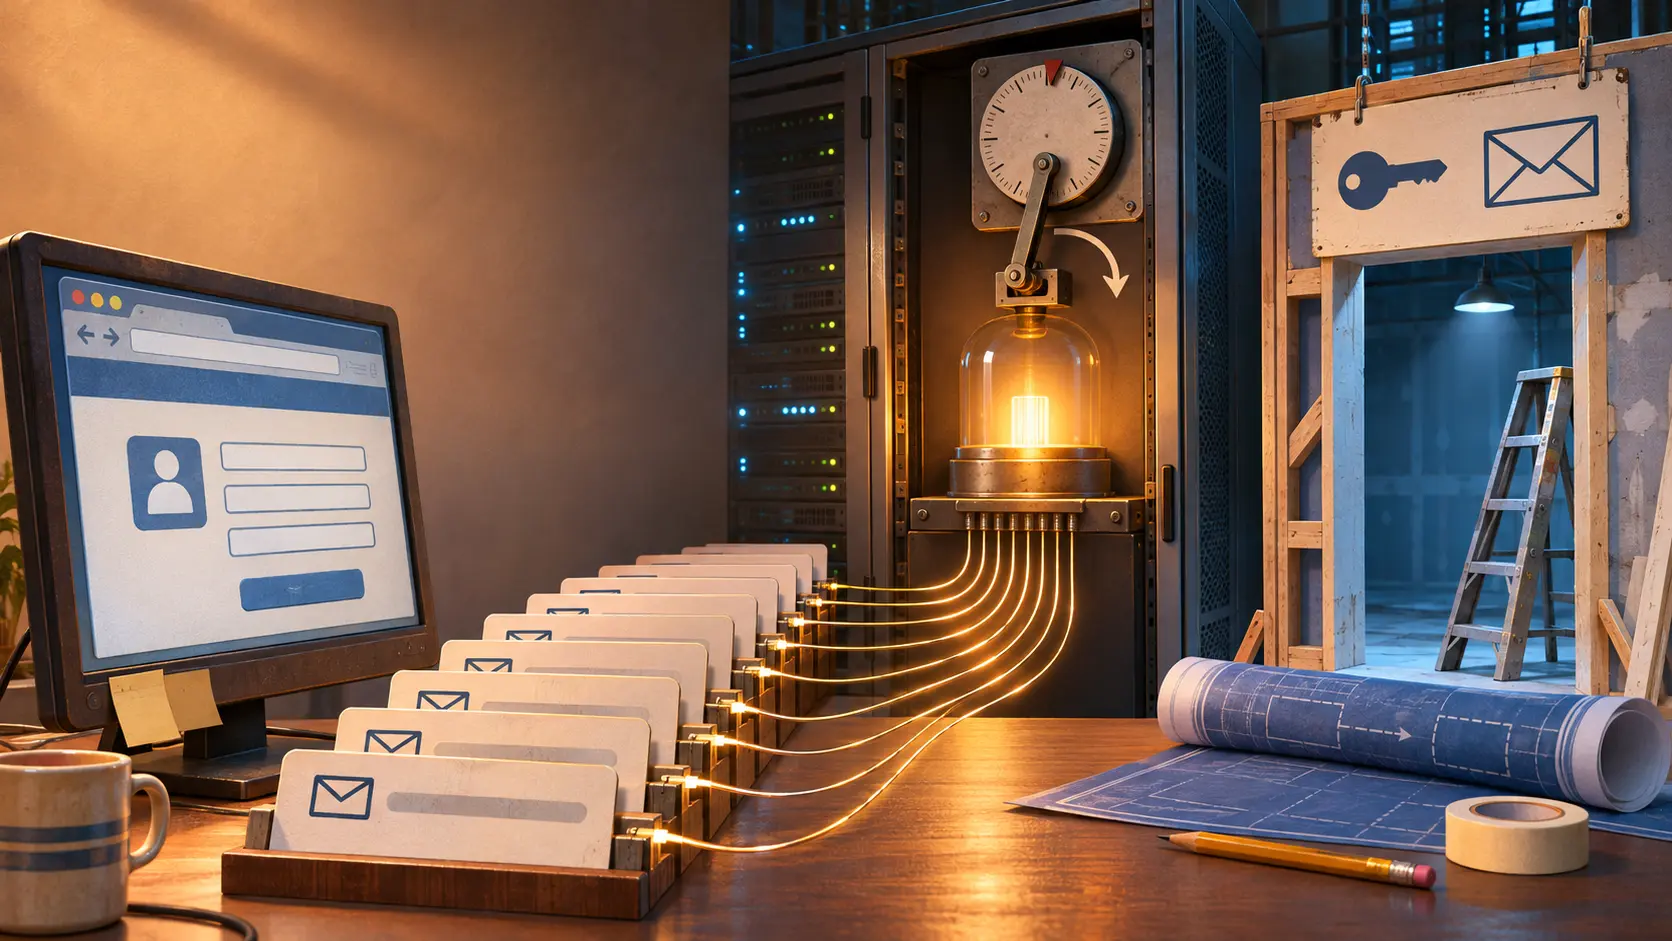
作者が再利用を認めても、その作品を見つける人が毎回権利者を探して条件を聞き直すなら、事前の許諾の価値は小さくなる。Creative Commonsの発表資料は役割を三つに分けた。Commons Deedは普通の読者に条件を説明し、Legal Codeは法的に働く文章を担い、Digital Codeは作品の利用条件を検索サービスやアプリケーションに知らせる。狙いは、許可の発見と確認にかかる費用を減らすことだった。
Creative Commons自身の説明では、法的効力を持つのはLegal Codeだ。機械向けの札には別の役割がある。どの作品にどのライセンスが付き、誰をどう表示するかを示す。人にはページ上のライセンス表示が明らかでも、ソフトウェアにはその表示と作品を結び付ける情報が必要になる。
初期の方法は、その結び付けを面倒にした。ccRELの著者らの回顧によると、ライセンス生成器はHTMLコメント内に貼り込むRDF/XMLを出力していた。プログラムはソースを開けば読める。ただしコメントを探し、内容を解析し、表示されるどの作品に対応するのか判断しなければならない。著者らは当時から使いにくさを認識していたと書く。RDF/XMLは利用可能な標準構文で、構造化情報を普通のHTMLと混ぜる安定した方法はまだ整っていなかった。
コメントを探す仕事が増えた
利用が広がると、その手間は個々のツールに積み上がった。2008年の論文は、数百万のウェブページがライセンス情報を含んでいた一方、開発者がその属性を一様かつ拡張可能な形で取り出す方法を持たず、独自の抽出技法に頼ったと述べる。人間が読む許諾は明瞭でも、機械が読む道順はページごとに謎解きになった。
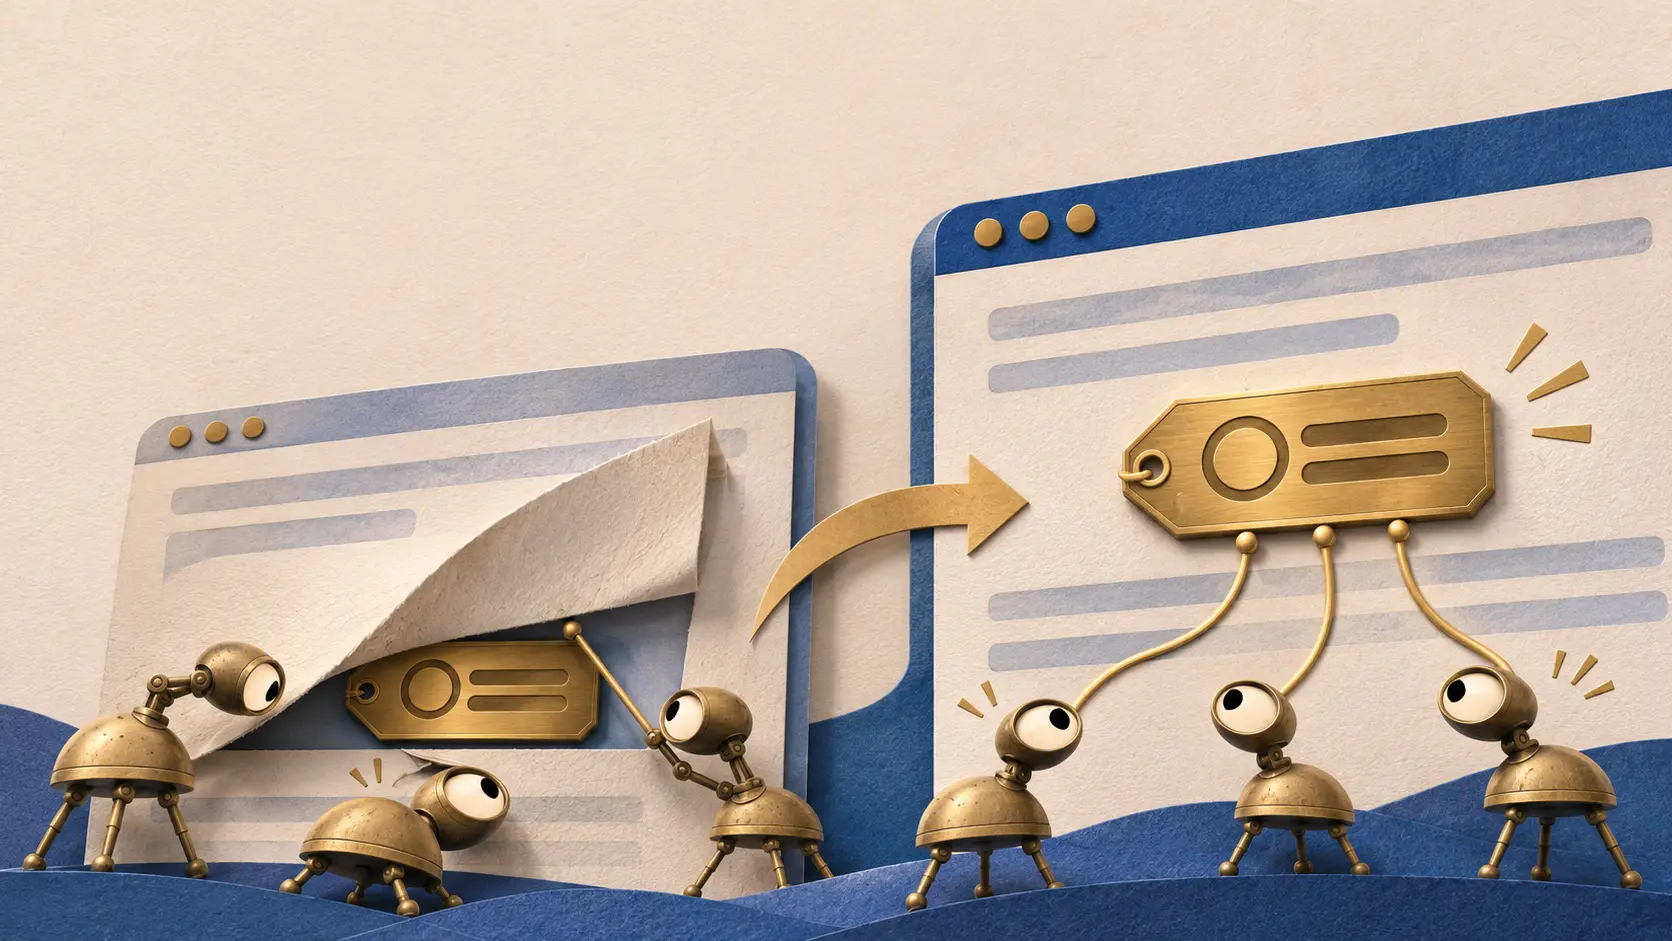
ccRELは境界を引き直した。作品に関する属性とライセンスに関する属性をRDFの拡張可能なモデルで定め、特定の書式だけに依存しない。抽出方法は発見可能でなければならない。HTMLページにはRDFa、独立したメディアにはXMPを標準的な掲載方法として勧めた。論文の例では、ライセンスと帰属の情報が見えるHTML要素に結び付いている。W3Cの2008年RDFa勧告が、この属性を使うための技術的な背景を与える。
変えたのは許諾を掲示する方法だった。ccRELは以前のライセンス・メタデータの推奨方式を置き換えると明記し、初期世代のライセンスも新しい属性モデルで解釈できると説明した。作者が与えた権利はそのままに、掲載者と読み取り側の仕事の境界を整えた。掲載者は札を正しい作品へ結び、ツールは発見可能な経路をたどれる。
札は鍵ではない
機械可読の権利情報は、権利者が選んだ条件を伝える。2009年のCreative Commonsの説明は、ccRELが利用を監視したりファイルを閉じたりする仕組みではないと明確にした。条件を担うのは法的文章で、デジタルコードはそれを見つけやすくする。良い札は、すでに許されている利用へたどり着く費用を下げる。
2002年から2008年への変化は、ウェブページの小さな場所に表れた。最初の機械向け札はコメントの折り目の下にあった。ccRELは作品、ライセンス、帰属情報の関係を読み取れる位置に結び直した。権利者の判断を変えたのではない。判断を見つけるための道を作り直した。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
ストラテジックサークル限定
ストラテジックサークル
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
ストラテジックサークルに参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加