Resumen
- El anuncio original de Creative Commons dividió cada licencia en resumen sencillo, código legal y código digital para buscadores y otras aplicaciones.
- El documento ccREL 1.0 del 8 de abril de 2008 explica que la primera recomendación usaba RDF/XML dentro de comentarios HTML; el nuevo modelo describió propiedades y formas de incrustarlas, como RDFa.
Tres versiones para tres trabajos distintos
Una persona puede ofrecer su obra para ciertos usos y aun así dejar a los posibles usuarios buscando al titular y preguntando lo que ya decidió. La nota de lanzamiento de 2002 intentó recortar ese coste. El Commons Deed explicaba las condiciones de forma sencilla; el Legal Code contenía el texto que operaba jurídicamente; el Digital Code dejaba que un buscador identificara obras por permiso. La capa para máquinas era una apuesta por encontrar, no solo por declarar.
La explicación actual de Creative Commons distingue el código legal de las otras capas. El programa necesita datos que indiquen qué obra lleva qué licencia y a quién atribuirla. Sin esa relación, una insignia visible para un lector puede quedarse fuera de los índices automáticos. El permiso existe, pero encontrarlo sigue costando trabajo.
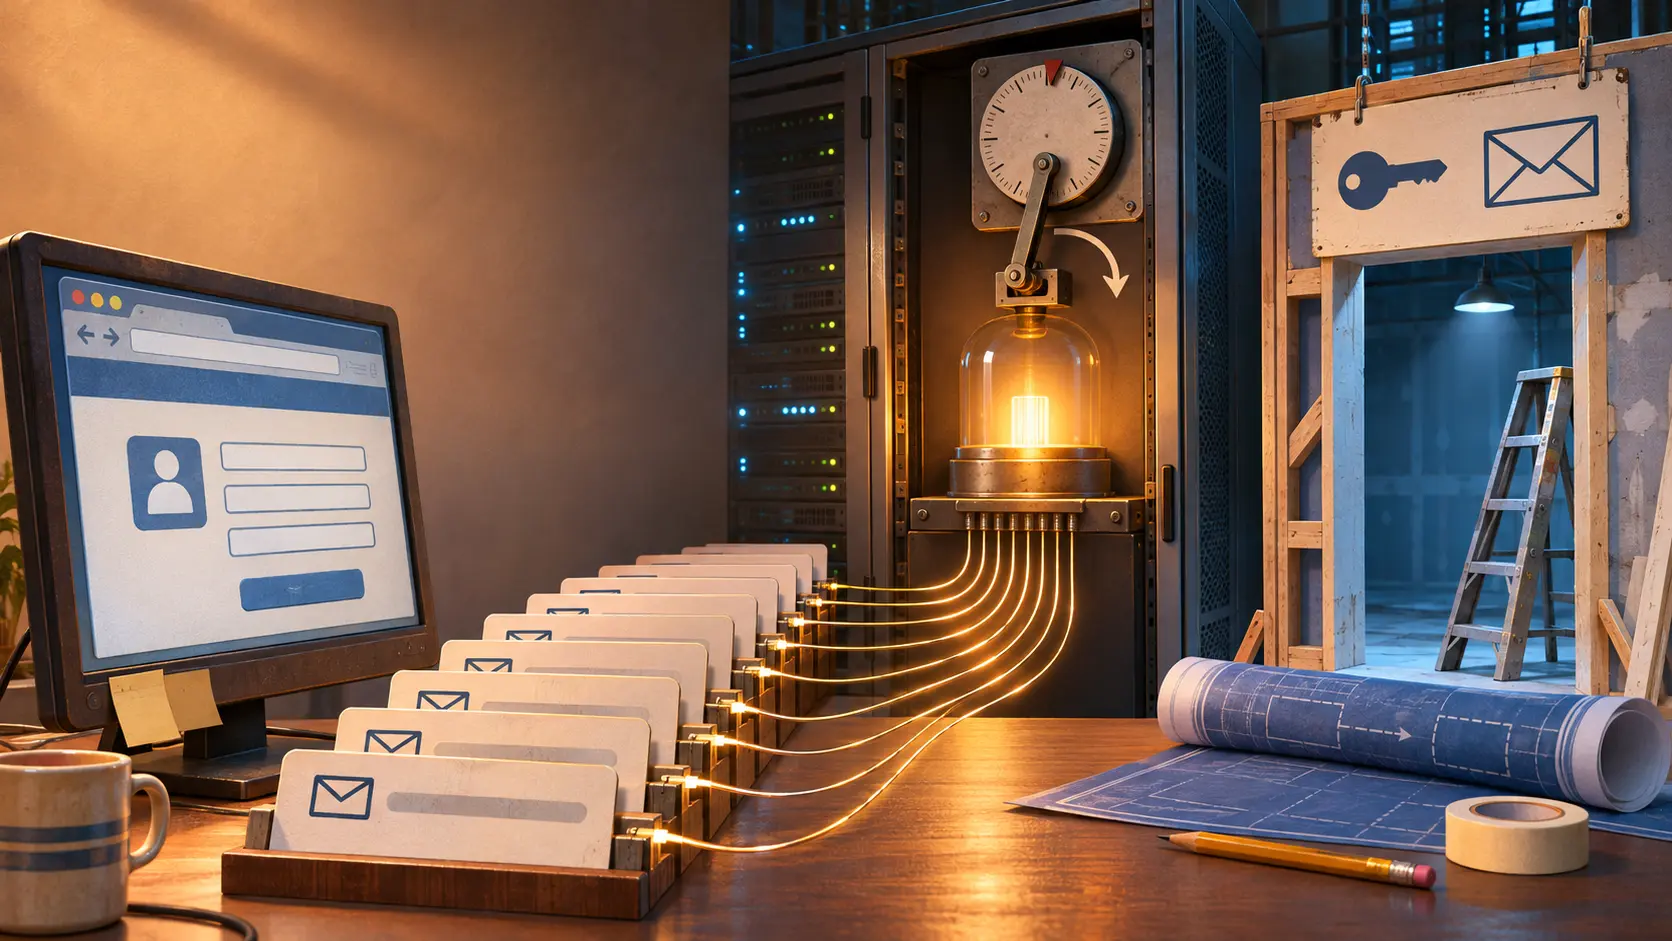
La primera solución venía con una trampa de interfaz. Según el relato técnico de ccREL, el generador de licencias entregaba al editor un bloque RDF/XML para meterlo en un comentario HTML. Una máquina podía leer el código fuente; el comentario quedaba separado de los elementos visibles. Había que localizarlo, interpretar sus propiedades y decidir a qué recurso correspondía. Los autores admiten que sabían lo incómodo del diseño. RDF/XML era entonces la sintaxis estándar de RDF disponible, mientras que la mezcla de datos estructurados con HTML aún no tenía una salida asentada.
La factura de buscar debajo del pliegue
En 2008, el mismo equipo describió el resultado acumulado: millones de páginas con licencias y metadatos, pero sin un modo uniforme y extensible de acceder a ellas. Los constructores de herramientas recurrieron a técnicas particulares de extracción. Para el visitante, la licencia podía parecer obvia. Para el programa, cada página era otra ocasión de preguntar dónde habían escondido la etiqueta y qué obra señalaba.
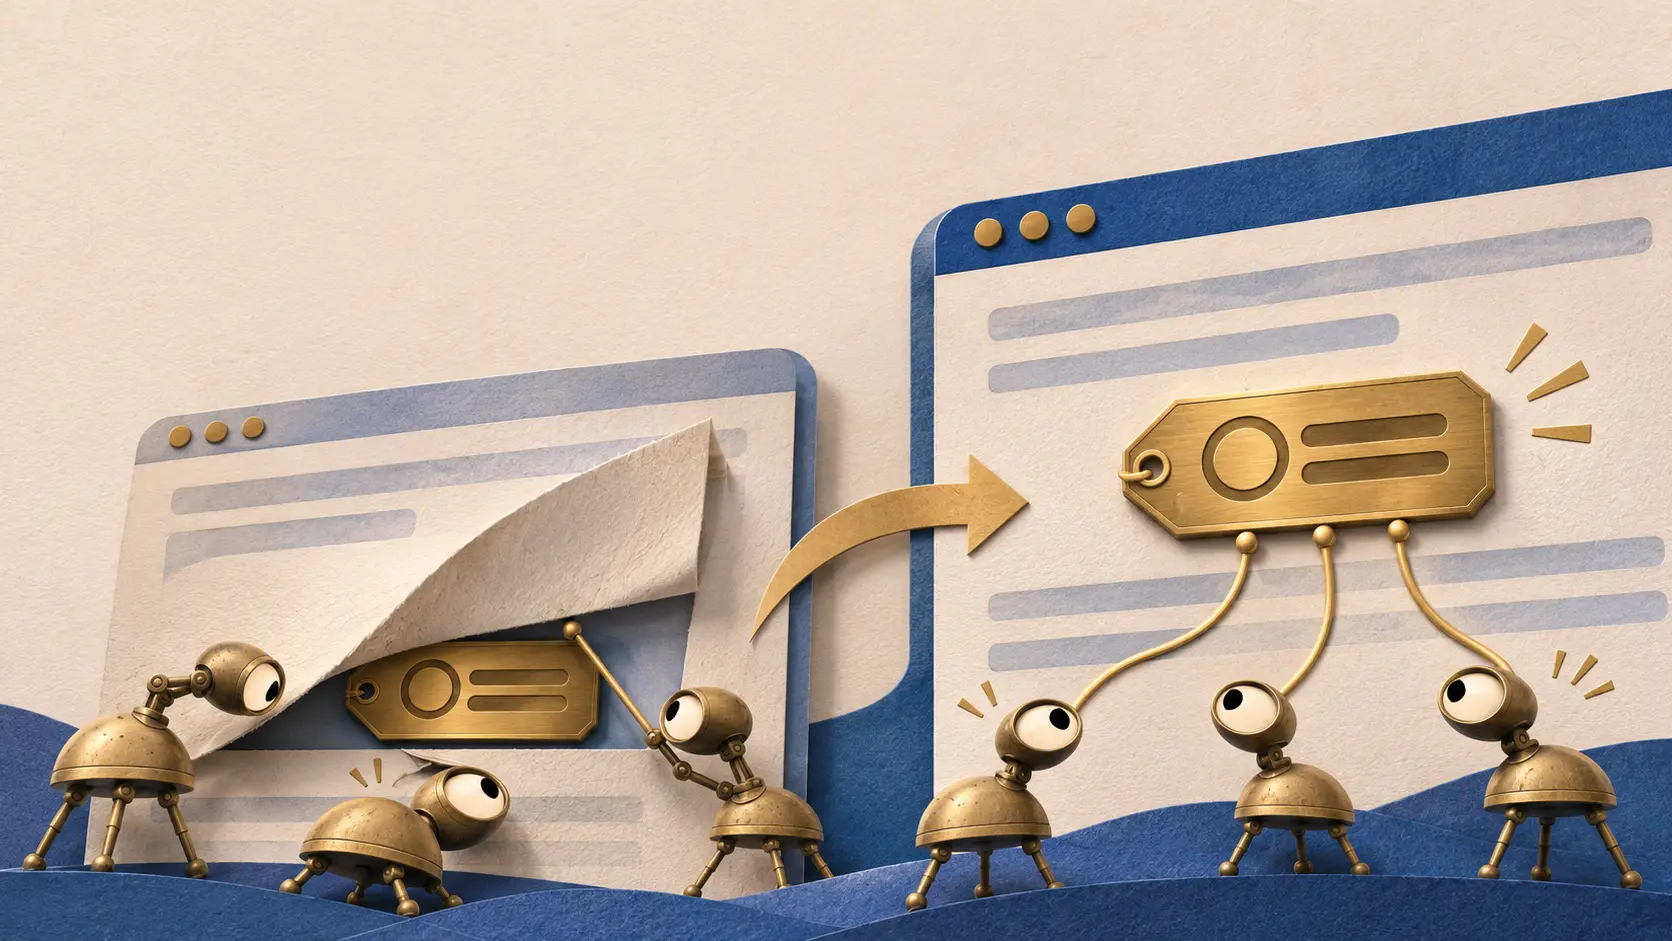
ccREL cambió ese contrato. Definió propiedades RDF para las obras y para las licencias, independientemente de una única sintaxis de escritura. Exigió que el camino para extraerlas pudiera descubrirse y recomendó RDFa como opción ordinaria para páginas HTML y XMP para medios independientes. En el ejemplo del documento, la relación de licencia y la información de atribución se apoyan en elementos visibles de la página. La Recomendación RDFa del W3C de 2008 da el contexto técnico de esa forma de anotación.
El cambio fue de metadatos, no una anulación de las licencias anteriores. Los autores dicen que ccREL sustituía las recomendaciones previas para expresar información de licencia y que las primeras licencias seguían siendo interpretables en el nuevo modelo de propiedades. El editor de una página tenía que sujetar la etiqueta al recurso correcto; las aplicaciones podían seguir una señal más estable en lugar de coleccionar excepciones privadas.
La etiqueta avisa; no cierra el archivo
El lenguaje de derechos para máquinas expresa una decisión del titular. En una aclaración de 2009, Creative Commons separó esa expresión del control técnico de acceso o la vigilancia. El código digital ayuda a descubrir condiciones; el texto jurídico sigue siendo la capa operativa. Un mejor punto de unión entre obra y licencia reduce el coste de búsqueda sin convertirse en un cerrojo.
La peripecia de seis años se resume en una posición dentro del documento. Creative Commons quiso que el permiso viajara con la obra y que un programa pudiera reconocerlo. Primero lo puso bajo la tapa de un comentario. Después diseñó propiedades y rutas de extracción más claras. Una licencia podía conservar su valor mientras la web aprendía a señalarla mejor.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para el Círculo Estratégico
Círculo Estratégico
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete al Círculo EstratégicoSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance