摘要
- Project Honey Pot 将独一份的诱饵邮箱与一次网页访问绑定,后来的来信可以接回当时的采集记录。
- 志愿网站提供页面,中央服务器分发地址、接收邮件并保留关联;这套分工也为研究采集者与发信服务器提供了材料。
2009 年 12 月 9 日,一封冒充税务通知的邮件进了收件箱。收件人根本不存在,收件系统却很高兴:等的就是这种信。
Project Honey Pot 当月的报告把它记为项目收到的第十亿封垃圾邮件。这个诱饵地址早在 2007 年 11 月 4 日就被爬虫从网页上采集走了。两年多后,冒充 Internal Revenue Service 的来信仍能通过收件地址,接回那次访问。
这门生意的尴尬之处在于,收信一方比发信一方更想把信留下来。
一个地址,只给一次访问
项目创建者的 2005 年论文记载,服务于 2004 年 10 月 14 日向公众志愿者开放。站长安装诱饵页面,让采集邮箱地址的程序有东西可拿。页面背后还连着一套记账系统。
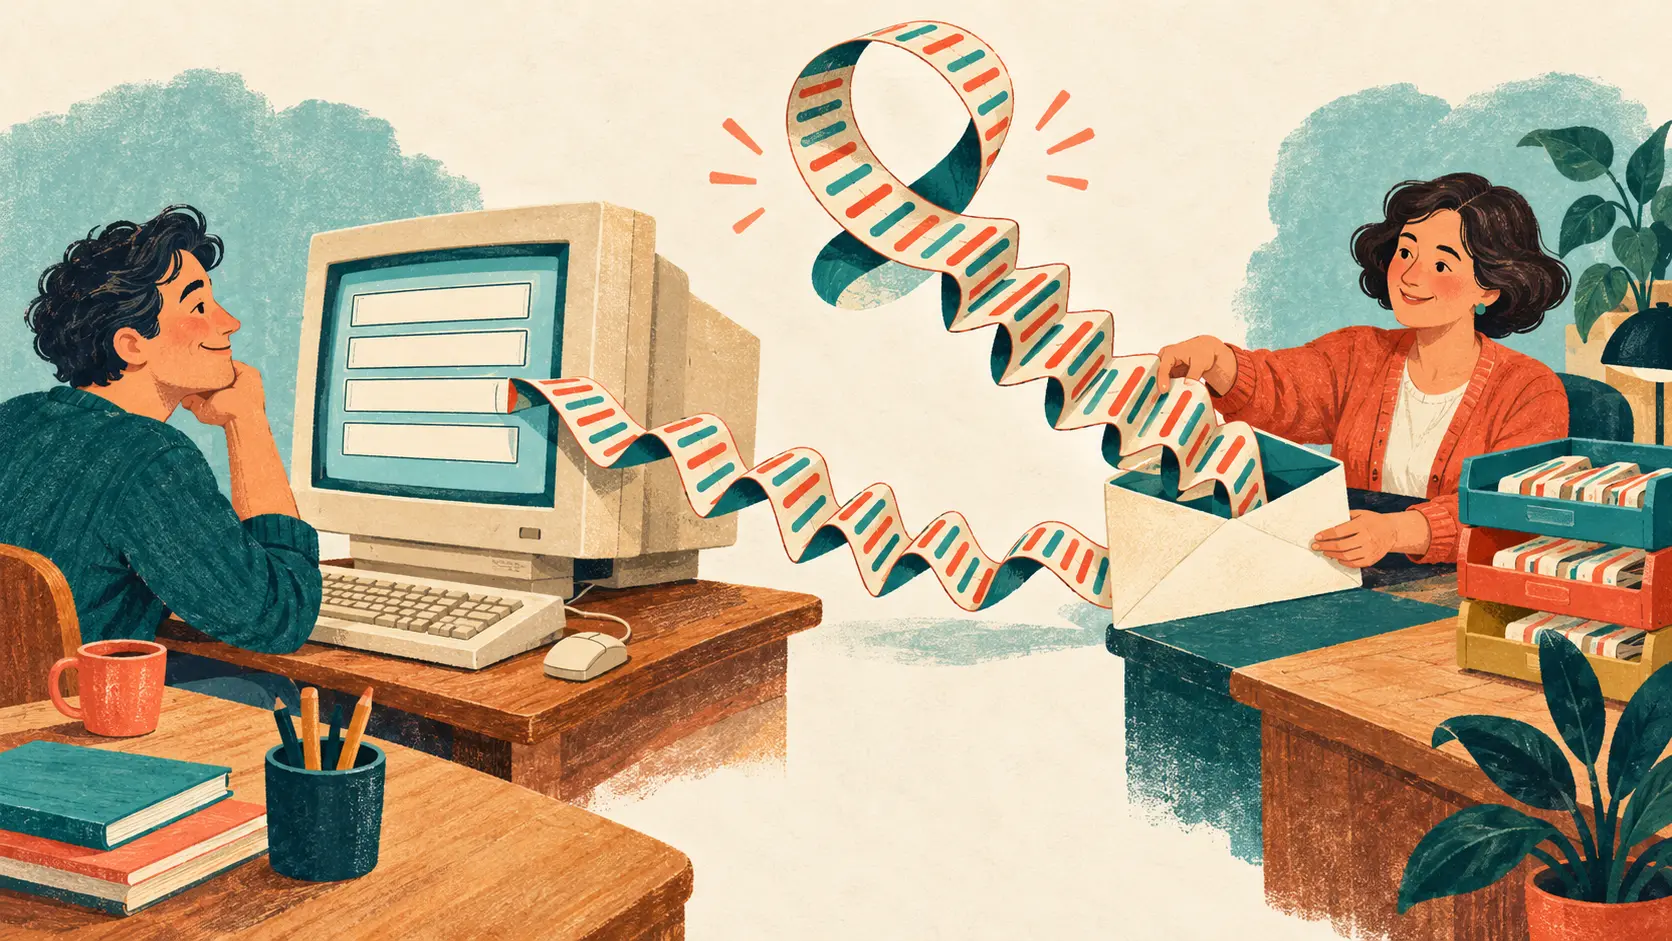
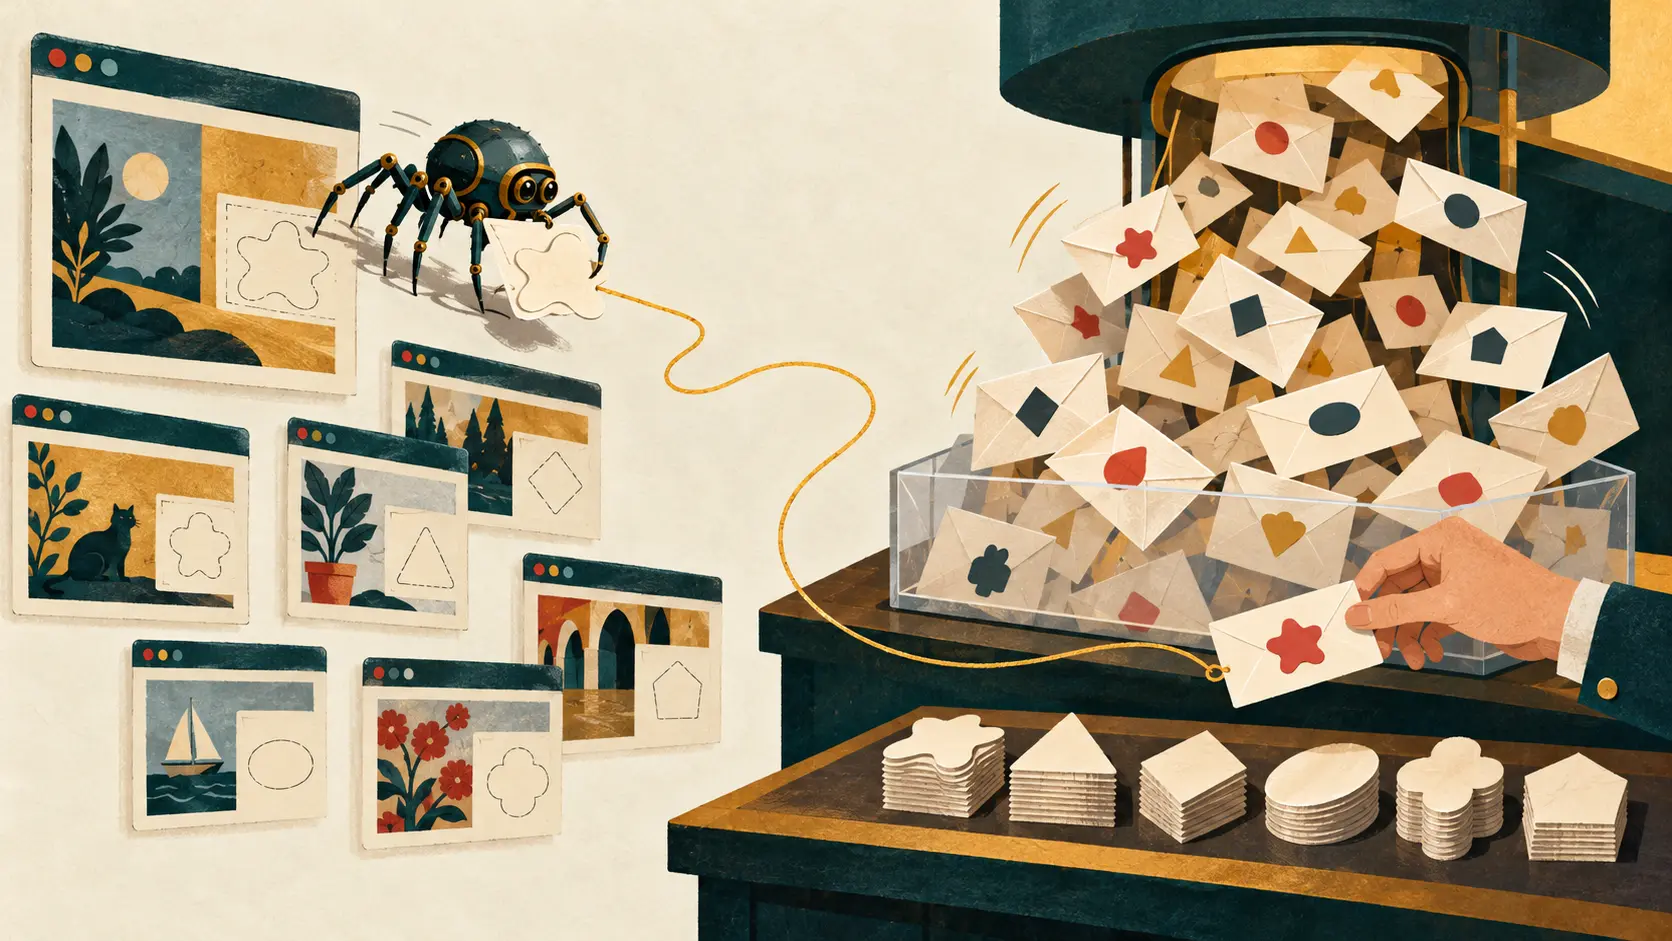
访客到达时,本地脚本联系项目的中央服务器,传送访问者的 IP 地址、浏览器标识和来源页面信息。中央端记下时间与访问资料,再返回一个独一份的邮箱地址。
这个地址只展示一次。外表可以像普通邮箱,底下已经绑好了这次访问。以后有人往它寄信,接收系统就能把两个动作连起来:先有人在这里拿到地址,后来有人用这个地址投递邮件。
普通人看到垃圾邮件,往往只能问一句“你从哪儿弄到我的邮箱”。这个假邮箱手里有一张记录。发信过程带来的信息之外,它还保留着地址被展示、被采集的入口。
志愿网站承担的是摆饵。地址由中央端分发,信也由中央端接收。参与者贡献的域名把邮件路由指向项目,为诱饵提供更多像样的收件地址。摊位分散在各家网站,收信处集中在后台。
拿走地址的人,未必亲自按发送
Kevin S. Xu 等人的 2009 年研究利用这些关联,分析行为相近的采集程序群组。论文区分了采集邮箱的机器与发送邮件的服务器:一个采集者可以给多个发送者供货,一个发送者也可以使用多个采集者。
这样一来,收件地址成了研究工具。不同机器完成的几个环节,可以借它连接起来。那封 2009 年的假税务邮件也说明,旧访问记录有继续保存的价值:2007 年流出去的地址,后来仍带着能追溯的来路。
机关巧妙,水电仍得有人管。项目现行常见问题说明解释,寄给诱饵地址的信直接进入项目服务器,参与者也可以贡献子域名;撤回域名后,已经散出去的那些地址会退信。想让诱饵继续报信,后面的收件通路就得继续工作。
Project Honey Pot 把网页变成了一场通信实验的起点。爬虫拿走地址,项目留住底单。发送者热情推销、故作威严或者冒充税务机关时,也顺便交回了一点它原本没打算提供的东西:这个地址后来去了哪里。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance