Resumo
- Cada endereço-isca era associado aos dados e ao horário de uma visita, permitindo ligar mensagens posteriores à coleta registrada.
- Os sites voluntários exibiam os endereços; o serviço central os distribuía, recebia as mensagens e preservava as relações entre os eventos.
Uma falsa cobrança fiscal chegou em 9 de dezembro de 2009 a uma caixa de entrada que gostou da visita. O contribuinte era fictício. A caixa, por sua vez, estava trabalhando.
No balanço publicado naquele mês, o Project Honey Pot registrou a mensagem como seu bilionésimo e-mail de spam. O endereço destinatário havia sido coletado na web em 4 de novembro de 2007. A mensagem que fingia representar o Internal Revenue Service trazia uma ligação com aquele acesso antigo.
O endereço vinha com memória
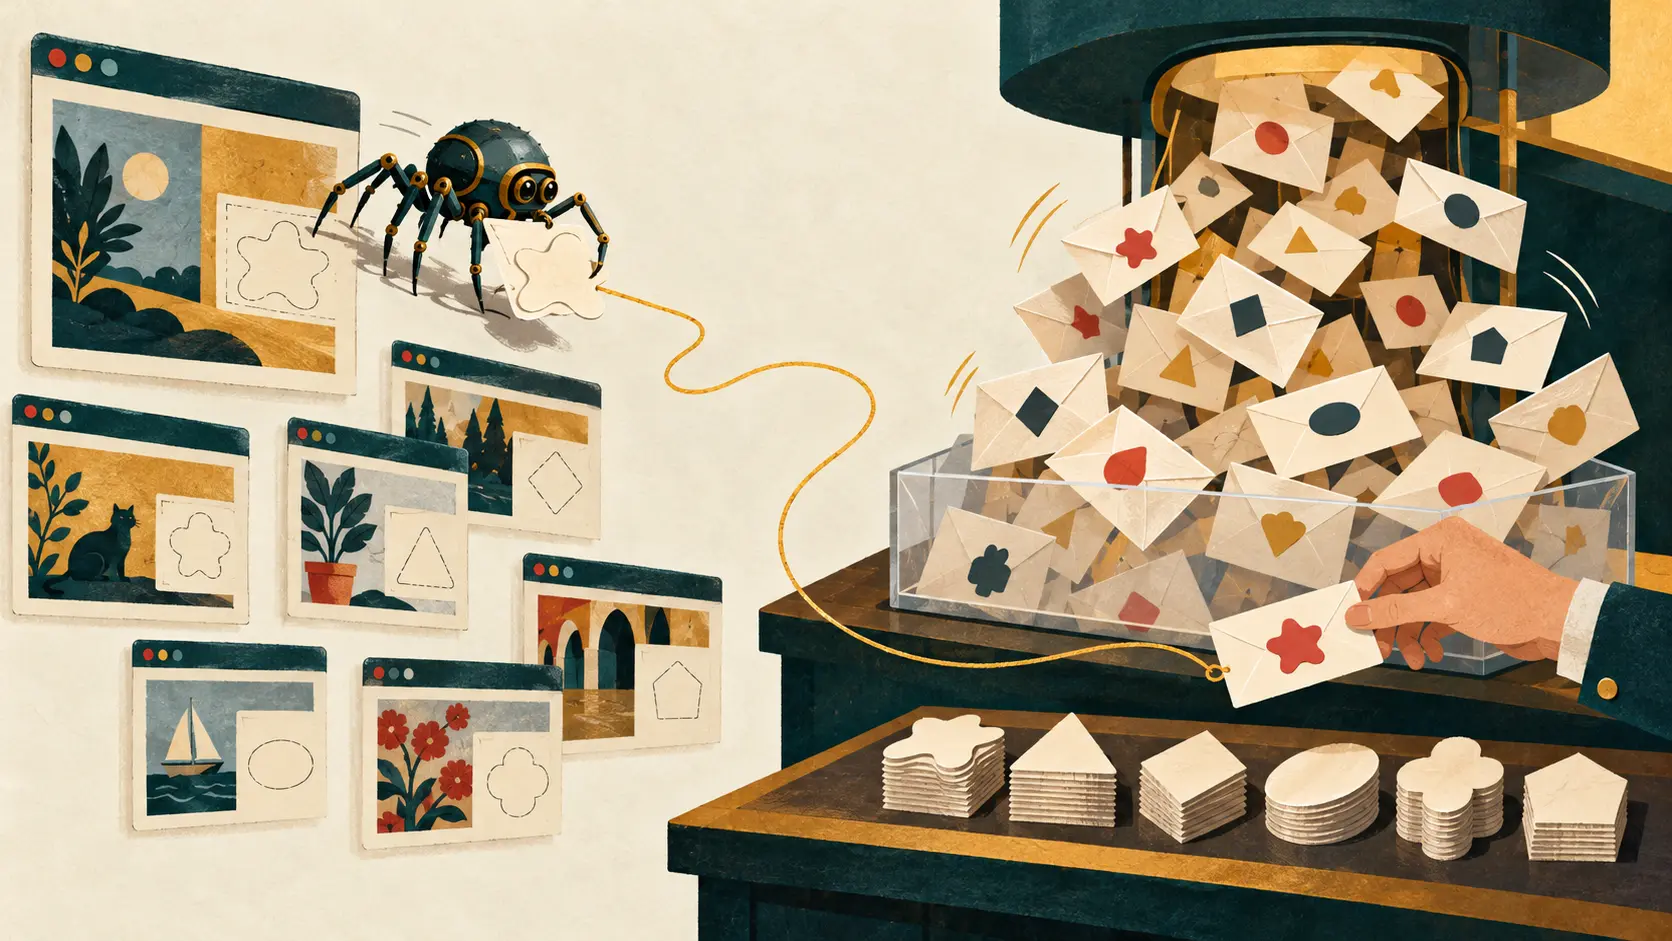
O artigo dos criadores, publicado em 2005, informa que o projeto abriu a participação pública em 14 de outubro de 2004. Administradores instalavam uma página para oferecer endereços aos robôs que percorriam a web atrás deles. Quem entrava encontrava algo para levar.
A visita acionava uma consulta aos servidores centrais. O programa no site enviava o IP do visitante, a identificação de navegador e as informações de referência da página de origem. O serviço guardava os dados e o horário, então devolvia um endereço de e-mail único.
Esse endereço era exibido uma só vez. Podia parecer perfeitamente comum, mas já tinha uma ligação com aquela visita. Se recebesse mensagens depois, o sistema conseguiria conectar a exposição e o uso posterior.
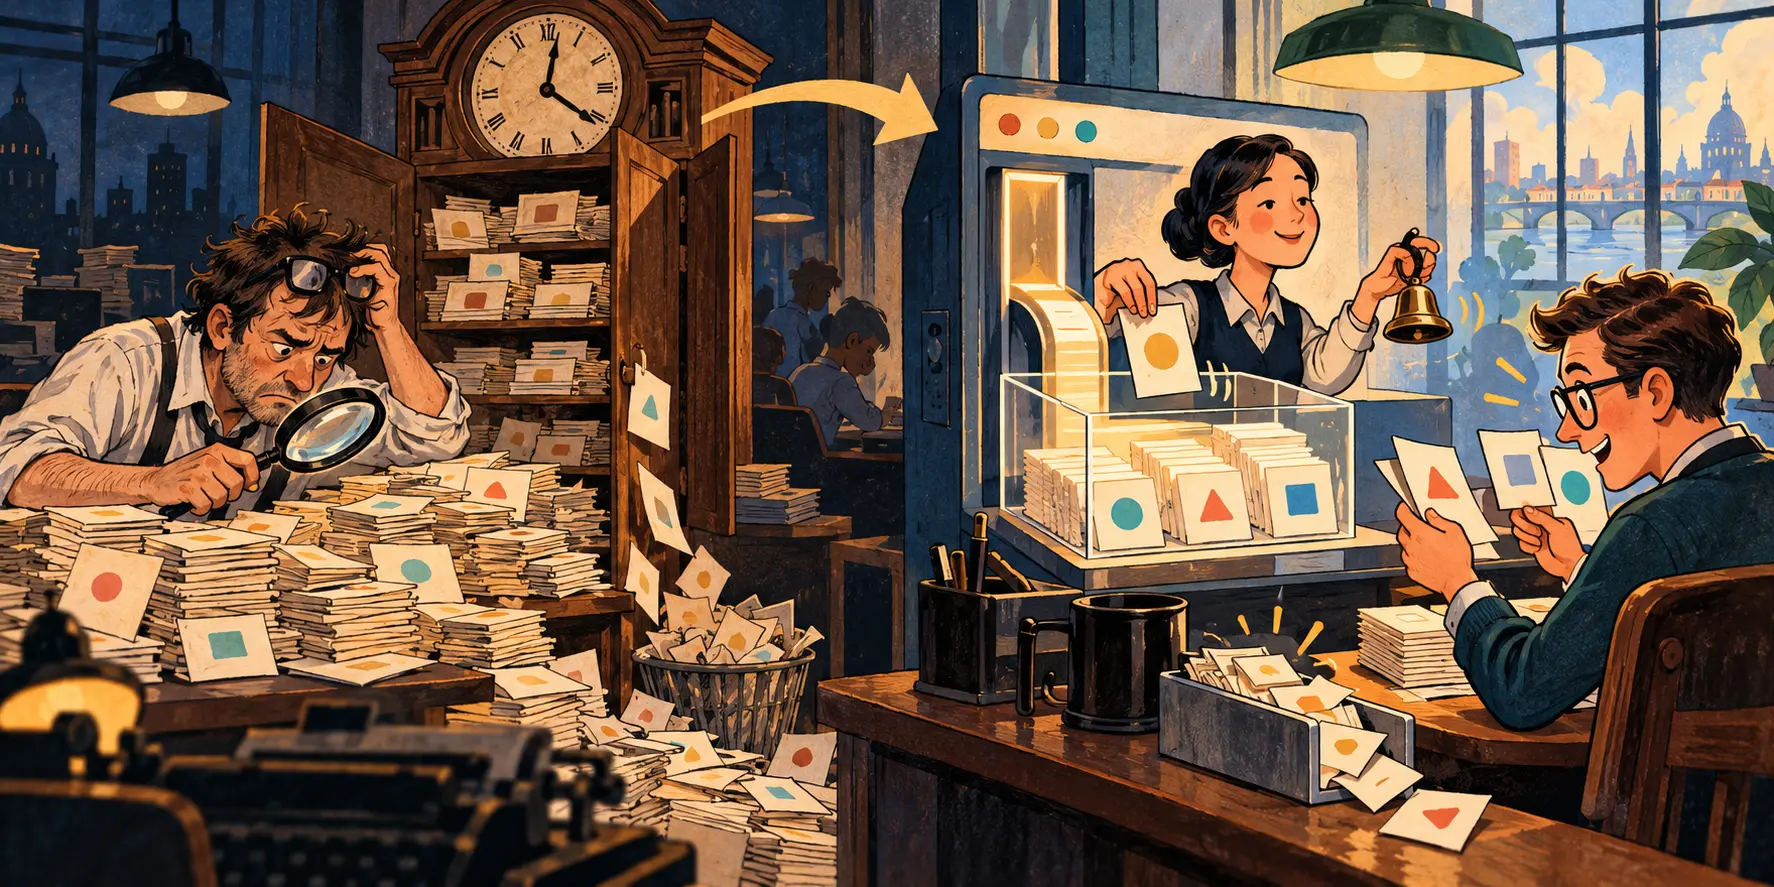
Todo e-mail recebido traz informações sobre a entrega. O destinatário-isca acrescentava uma pista sobre a aquisição do endereço. Para a pergunta clássica «onde conseguiram meu e-mail?», aquela caixa tinha um comprovante.
Havia uma divisão de tarefas. Os sites voluntários mostravam a isca; a estrutura central distribuía endereços e recebia correspondência. Domínios cedidos pelos participantes, com o encaminhamento de e-mail apontado para o projeto, ampliavam as opções de destinatários convincentes. As vitrines eram espalhadas, o balcão de recebimento era central.
Quem coleta pode passar adiante
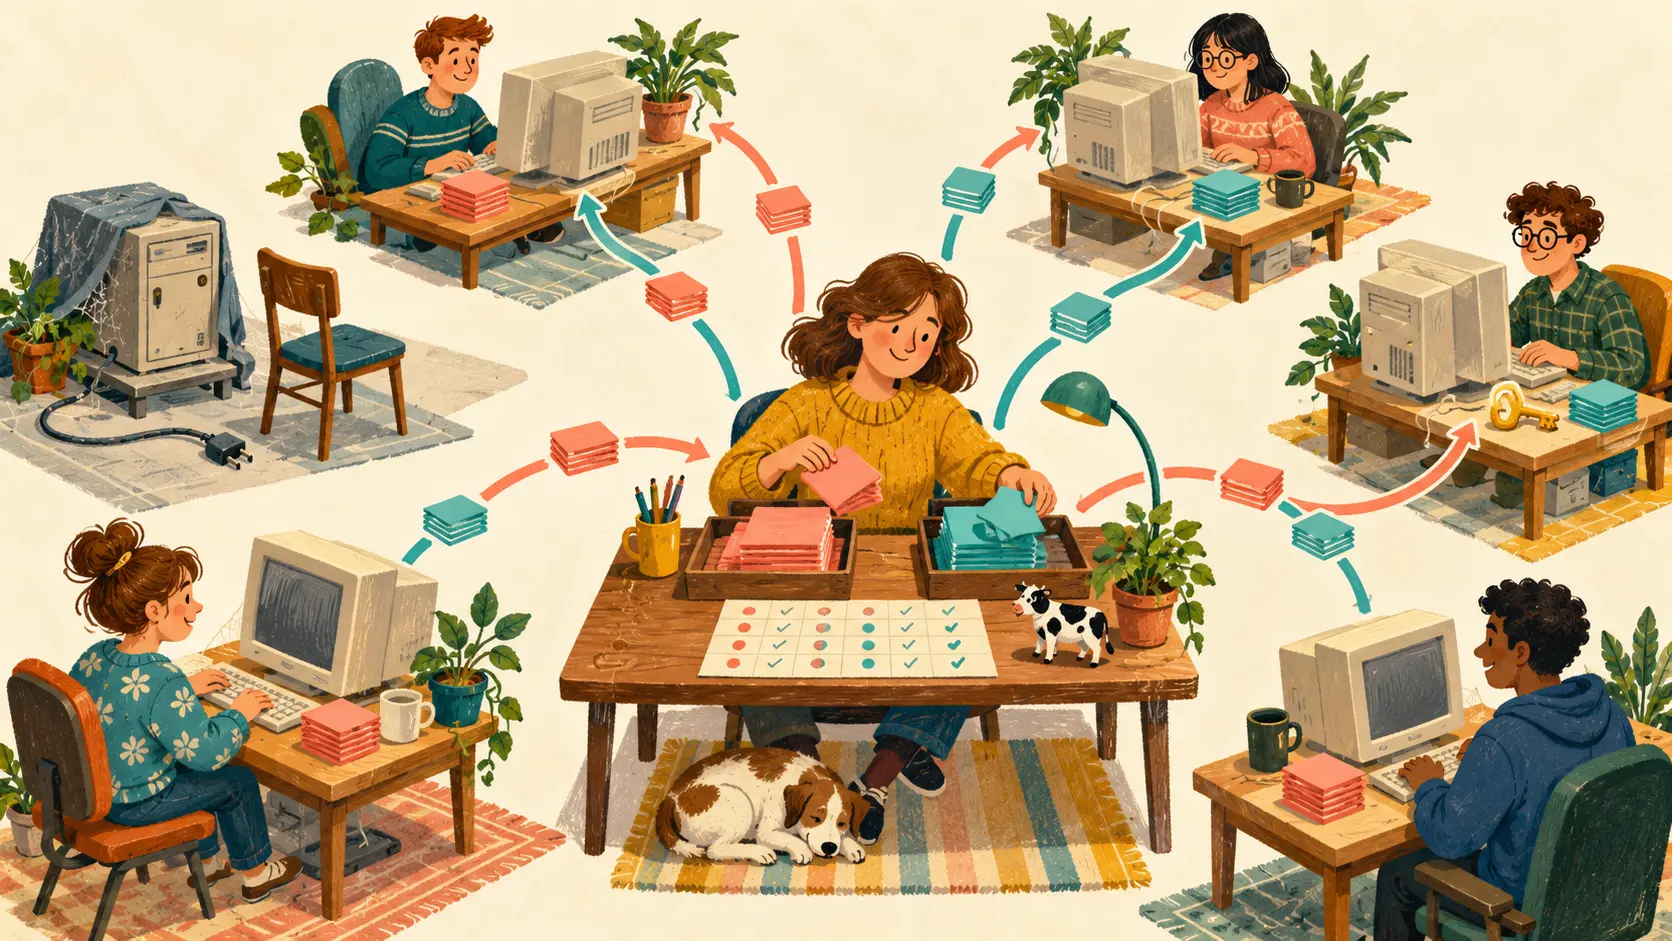
A pesquisa de Kevin S. Xu e colegas em 2009 usou essas ligações para estudar grupos de coletores com comportamento semelhante. O trabalho distinguia a máquina que recolhia endereços do servidor que enviava mensagens. Um coletor podia fornecer material a vários remetentes; um remetente podia recorrer a vários coletores.
O endereço permitia acompanhar etapas executadas por equipamentos diferentes. A falsa notificação tributária de 2009 também mostrava por que valia a pena manter registros antigos. Um endereço recolhido em 2007 ainda devolvia uma história que podia ser consultada.
A esperteza dependia de encanamento em dia. A FAQ atual do projeto explica que o e-mail chega diretamente aos seus servidores, inclusive quando usa subdomínios cedidos. Também informa que retirar um domínio faz as mensagens para endereços já distribuídos voltarem ao remetente. A isca pode continuar circulando depois que seu ponto de observação deixa de receber.
O Project Honey Pot transformou uma página em começo de uma experiência de correspondência. O robô carregava o endereço, o projeto ficava com o recibo. Cada anúncio e cada falsa urgência podiam acrescentar algo à história da circulação daquele endereço. O spam finalmente encontrara alguém interessado em saber de onde ele vinha.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance