
摘要
- WAIS 用共同协议连接各服务器自己的索引;用户仍需先从源描述或服务器目录中找到目标数据库。
- 项目公告称服务器数从 1991 年 7 月的 44 个增至 10 月的 80 个。这反映参与增长,不是完整或独立审计的全球目录。
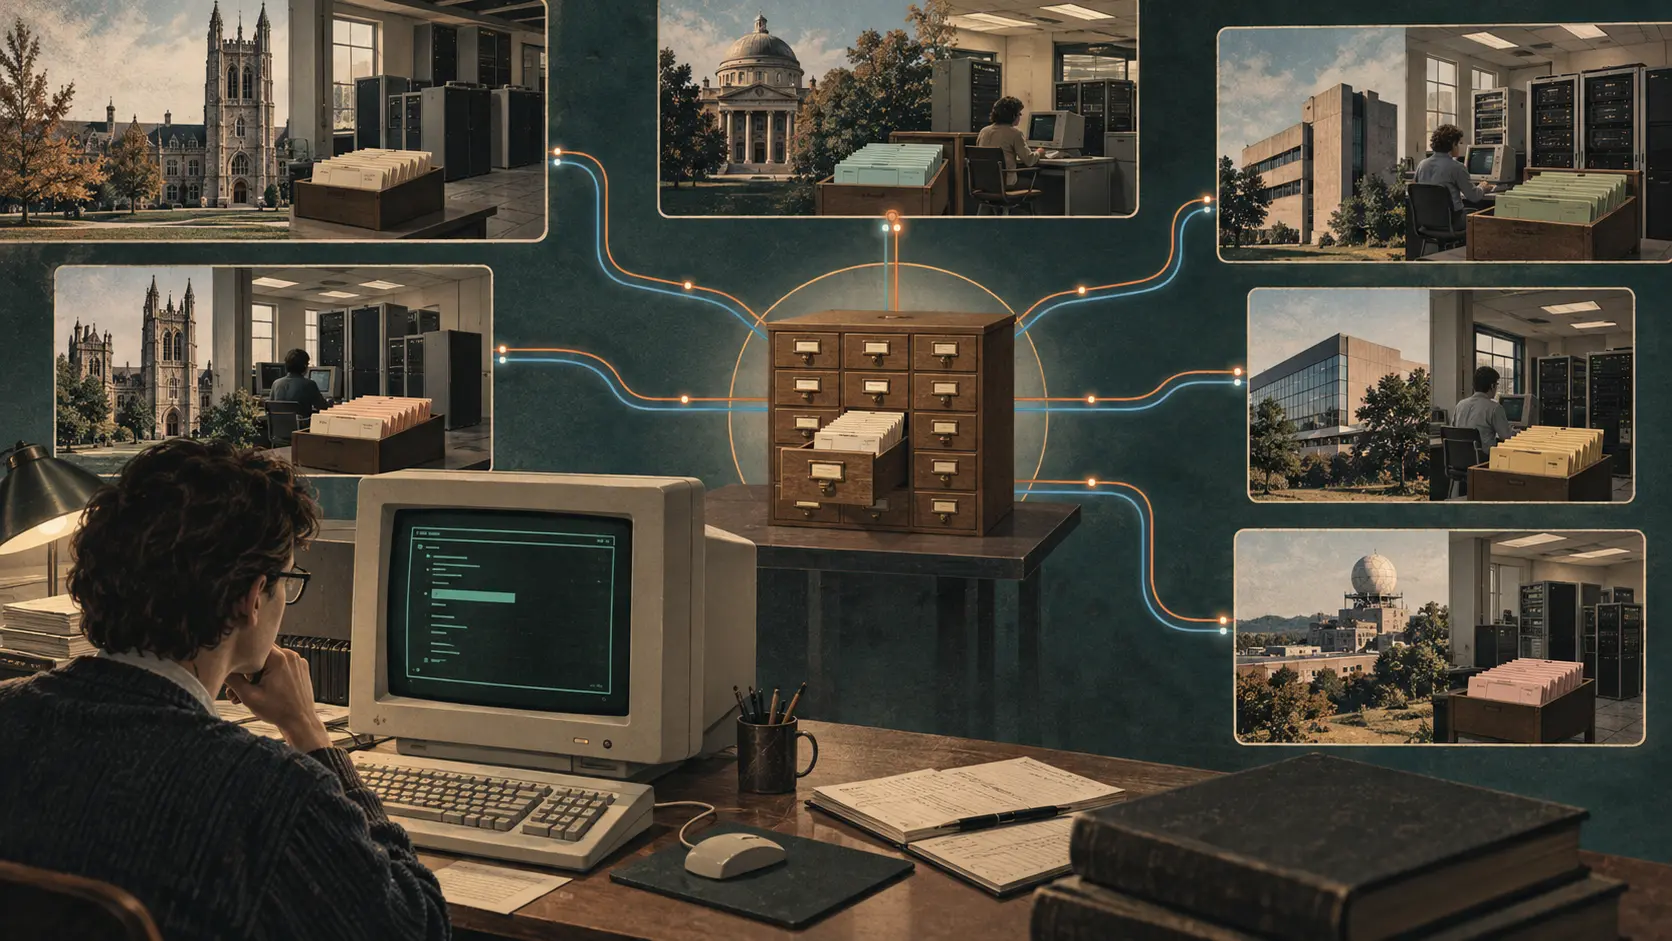
分布式搜索的难点,有时在输入检索词之前就已经出现。1991 年 7 月 31 日,Brewster Kahle 发布 WAIS Beta 2,并报告当时已有 44 台服务器。用户仍然要先知道:该去搜索哪一台?
WAIS 为这个前置步骤提供了另一种可搜索对象——服务器目录。Beta 2 公告把目录本身列为 Quake 上的一项服务,也介绍了从本地文件生成索引的软件。源描述为客户端指明一个有名称的目标,随后由目标服务器搜索自己的数据库。机构因此可以发布自己的可检索资料库,而不必先把所有文件合并进一个覆盖全网的总索引。
目录的职责是定位索引,而不是取代索引。1991 年 10 月,WAIS-discussion 列表的一份公告称,服务器已达 80 台,分布在四个国家、三个大洲;新增来源包括 FidoNet 节点清单、机器人学资料、澳大利亚资源指南和常见问题集合。每增加一项,都需要有人准备源、维持访问,并把它的存在告知共享目录。
W3 后来保存的一份概览把目录称为“索引的总索引”:当时它列出 80 多个索引,同时指出一次 WAIS 查询最多返回 40 条结果。W3 对 WAIS 的比较还指出一个导航限制:在 WAIS 客户端中,用户可以搜索主目录,却不能从概览页一路跟随链接浏览不同索引。Web 网关可以补上这种链接式概览,但那是额外视图,并非 WAIS 客户端本身具备的能力。
到 1994 年,RFC 1580 记载 directory-of-servers 数据库在多个站点提供,并建议用户查询它来按主题发现数据库。顺序由此清楚起来:先发现数据源,再选中它,最后搜索它。这个后期指南并不能证明所有数据源都被收录,也不能证明目录始终及时更新。
WAIS 让本地发布与统一检索可以并存,但检索协议没有消除目录维护这项协调工作。项目公告记录的是组织者报告的参与情况,并未统计有多少数据库不可见、目录条目多久过期,或用户是否总能找到合适来源。选定数据库后,WAIS 可以搜索它;找到数据库则是系统的另一层工作。
资料与边界
- Brewster Kahle 的 WAIS Beta 2 公告,1991 年 7 月 31 日
- WAIS-discussion 第 31 期摘要,1991 年 10 月 17 日
- W3 保存的 WAIS 数据源历史概览及归档源目录
- W3 关于 WAIS、Gopher 与 Web 的历史 FAQ
- RFC 1580《网络资源工具指南》,1994 年 3 月
1991 年的服务器数量来自项目公告,不是独立审计的普查。W3 页面是后来保存下来的历史快照,不能视为 WAIS 部署的完整清单。1994 年 RFC 描述的是后期实践,不能证明 1991 年所有客户端的行为完全相同。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance