
Résumé
- WAIS associait des index locaux par un protocole client-serveur, mais il fallait d’abord trouver la description ou l’entrée de répertoire qui désignait la base à interroger.
- Les annonces du projet comptaient 44 serveurs en juillet 1991 puis 80 en octobre : une progression déclarée, pas un catalogue mondial complet ni un recensement indépendant.
Dans une recherche en réseau, la difficulté pouvait précéder la requête. Le 31 juillet 1991, Brewster Kahle annonça WAIS Beta 2 et indiqua 44 serveurs. Encore fallait-il savoir lequel détenait les documents recherchés.
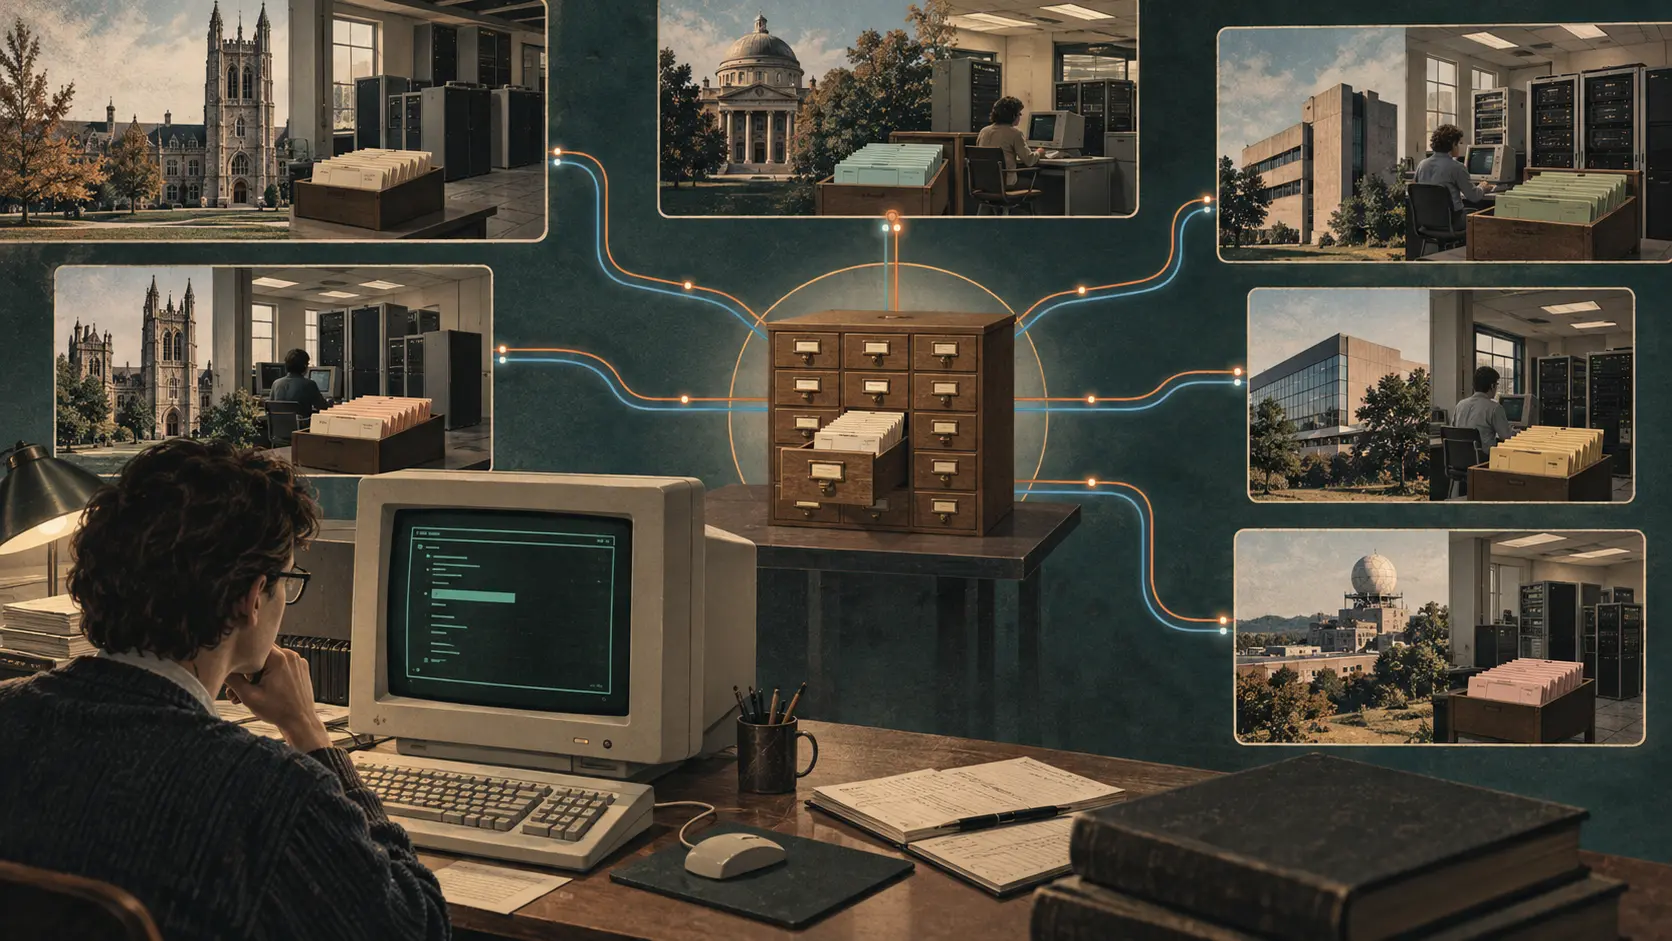
WAIS répondait en partie à cette question avec un second objet consultable : le répertoire des serveurs. L’annonce de Beta 2 mentionnait ce répertoire parmi les serveurs hébergés sur Quake et décrivait un logiciel permettant de créer des index à partir de fichiers locaux. Une description de source indiquait au client une destination nommée ; le serveur interrogeait sa propre base. Une institution pouvait ainsi ouvrir sa collection à la recherche sans fusionner au préalable tous ses documents dans un index général.
Le répertoire servait donc à localiser des index ; il ne les remplaçait pas. En octobre, un message de la liste WAIS-discussion annonçait 80 serveurs répartis dans quatre pays et trois continents. Il citait de nouvelles sources, dont une liste de nœuds FidoNet, des ressources de robotique, un guide australien et des FAQ. Derrière chaque nouvelle entrée, il fallait qu’un responsable prépare la source, la rende accessible et signale son existence au répertoire partagé.
Une présentation historique du W3 a ensuite décrit le répertoire comme un « index des index ». Elle signalait plus de 80 index, tout en précisant qu’une recherche WAIS ne pouvait renvoyer plus de 40 résultats. La comparaison du W3 avec WAIS ajoutait une limite d’usage : dans le client WAIS, on pouvait interroger le répertoire maître, mais pas parcourir les index en suivant des liens depuis une page d’ensemble. Une passerelle Web pouvait fournir cette navigation liée ; c’était une vue supplémentaire, pas une propriété du client WAIS.
En 1994, la RFC 1580 indiquait que la base directory-of-servers était disponible sur plusieurs sites et conseillait de la consulter pour repérer des bases par sujet. La séquence était claire : découvrir une source, la sélectionner, puis l’interroger. Ce guide ultérieur ne prouve ni que toutes les sources étaient répertoriées ni que le répertoire restait à jour.
WAIS rendait compatibles la publication locale et une recherche commune. Mais une tâche de coordination demeurait en dehors du protocole de requête. Les chiffres du projet décrivent la participation telle que ses organisateurs la rapportaient ; ils ne mesurent ni les bases invisibles, ni les entrées périmées, ni la capacité des lecteurs à choisir la bonne source. Une fois la base sélectionnée, WAIS pouvait la rechercher. La trouver relevait d’une autre couche.
Sources et limites
- Annonce de la bêta 2 de WAIS, Brewster Kahle, 31 juillet 1991
- Digest 31 de la liste WAIS-discussion, 17 octobre 1991
- Présentation historique des sources WAIS conservée par le W3 et liste des sources archivée
- FAQ du W3 sur WAIS, Gopher et le Web
- RFC 1580, Guide des outils de ressources réseau (mars 1994)
Les totaux de serveurs de 1991 viennent d’annonces du projet, non d’un recensement indépendant. Les pages du W3 constituent une archive ultérieure, pas un inventaire complet du déploiement de WAIS. Le RFC de 1994 décrit une pratique postérieure et ne prouve pas que chaque client de 1991 fonctionnait de la même façon.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance