摘要
- Tridgell 与 Mackerras 的原始技术报告让接收方把旧文件切成块,为每块发送两种校验和。发送方在新文件的每个偏移位置寻找可复用块,回传块引用和未匹配的原始字节。
- rsync 项目自己的实现说明列出另一张账单:发送方消耗 CPU 搜索,接收方消耗磁盘读取旧块并写入临时文件,最后还要以整文件校验确认结果。节约传输不等于免费更新。
先寄来的不是文件,而是库存表
想象一份大文件在两端各有一版。新版本只在开头插入一段,旧版本其余内容几乎没变。直接复制新文件,会把旧机器已经存着的大量字节再寄一遍。按原位置逐块比较也不灵:插入的一段会让后面的相同内容整体移位。原始 rsync 报告把问题设在一条低带宽、高延迟的双向链路上。两台机器各自能看到一份完整文件,却不能先把两份文件搬到同一处做普通差分——那恰好是要避免的传输。
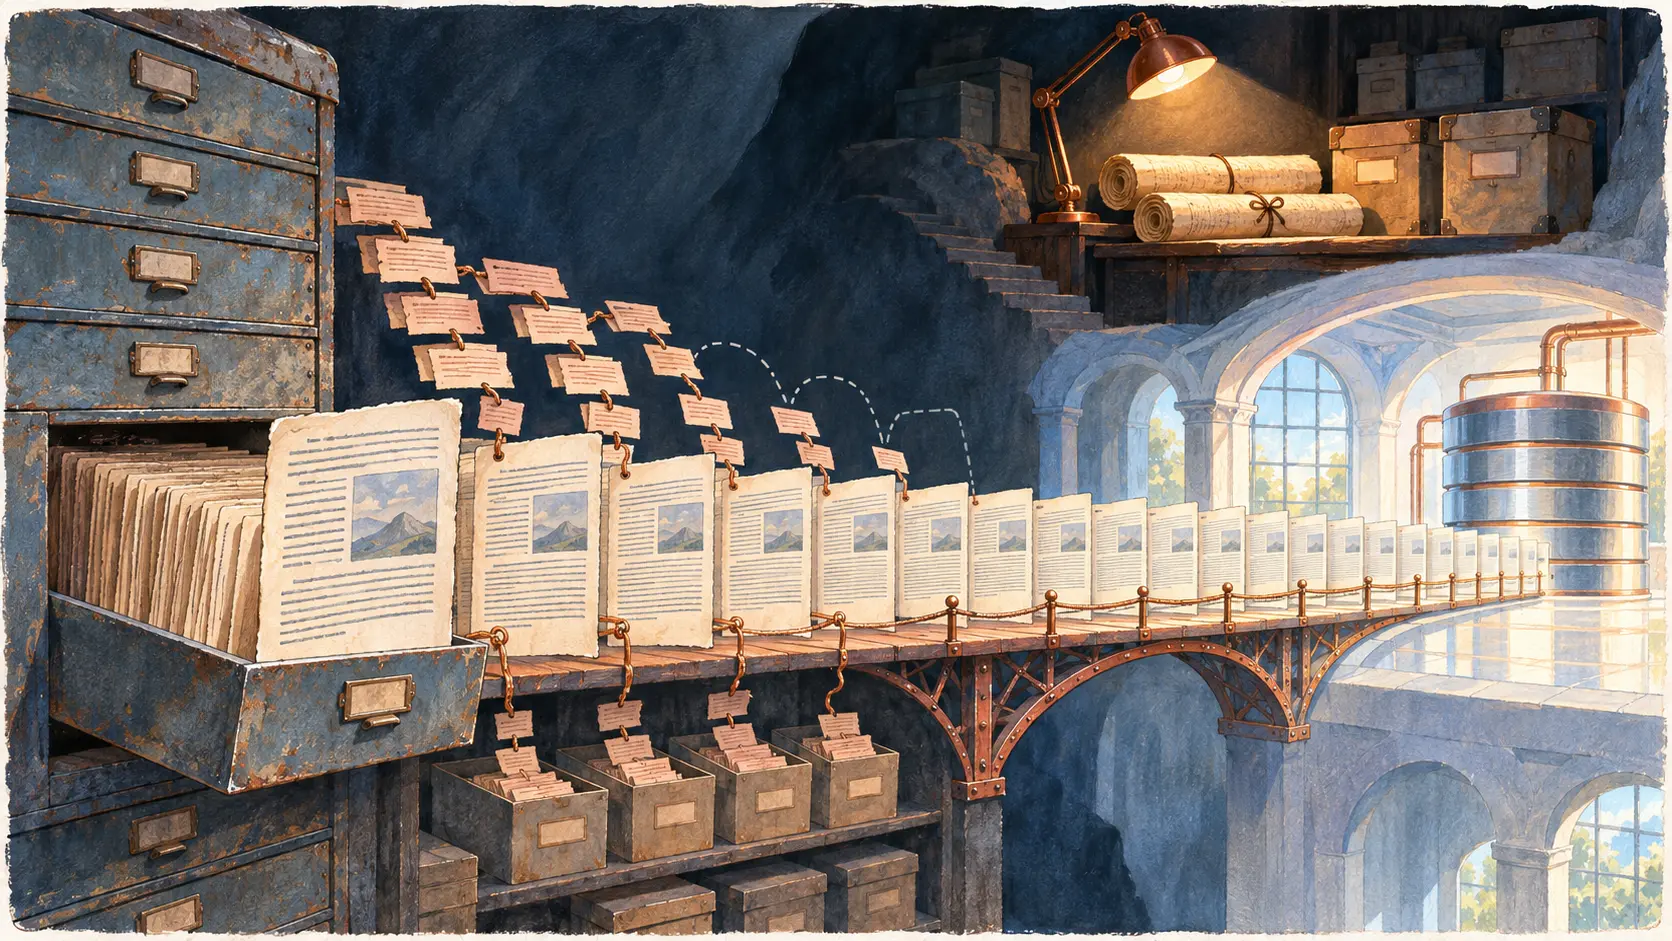
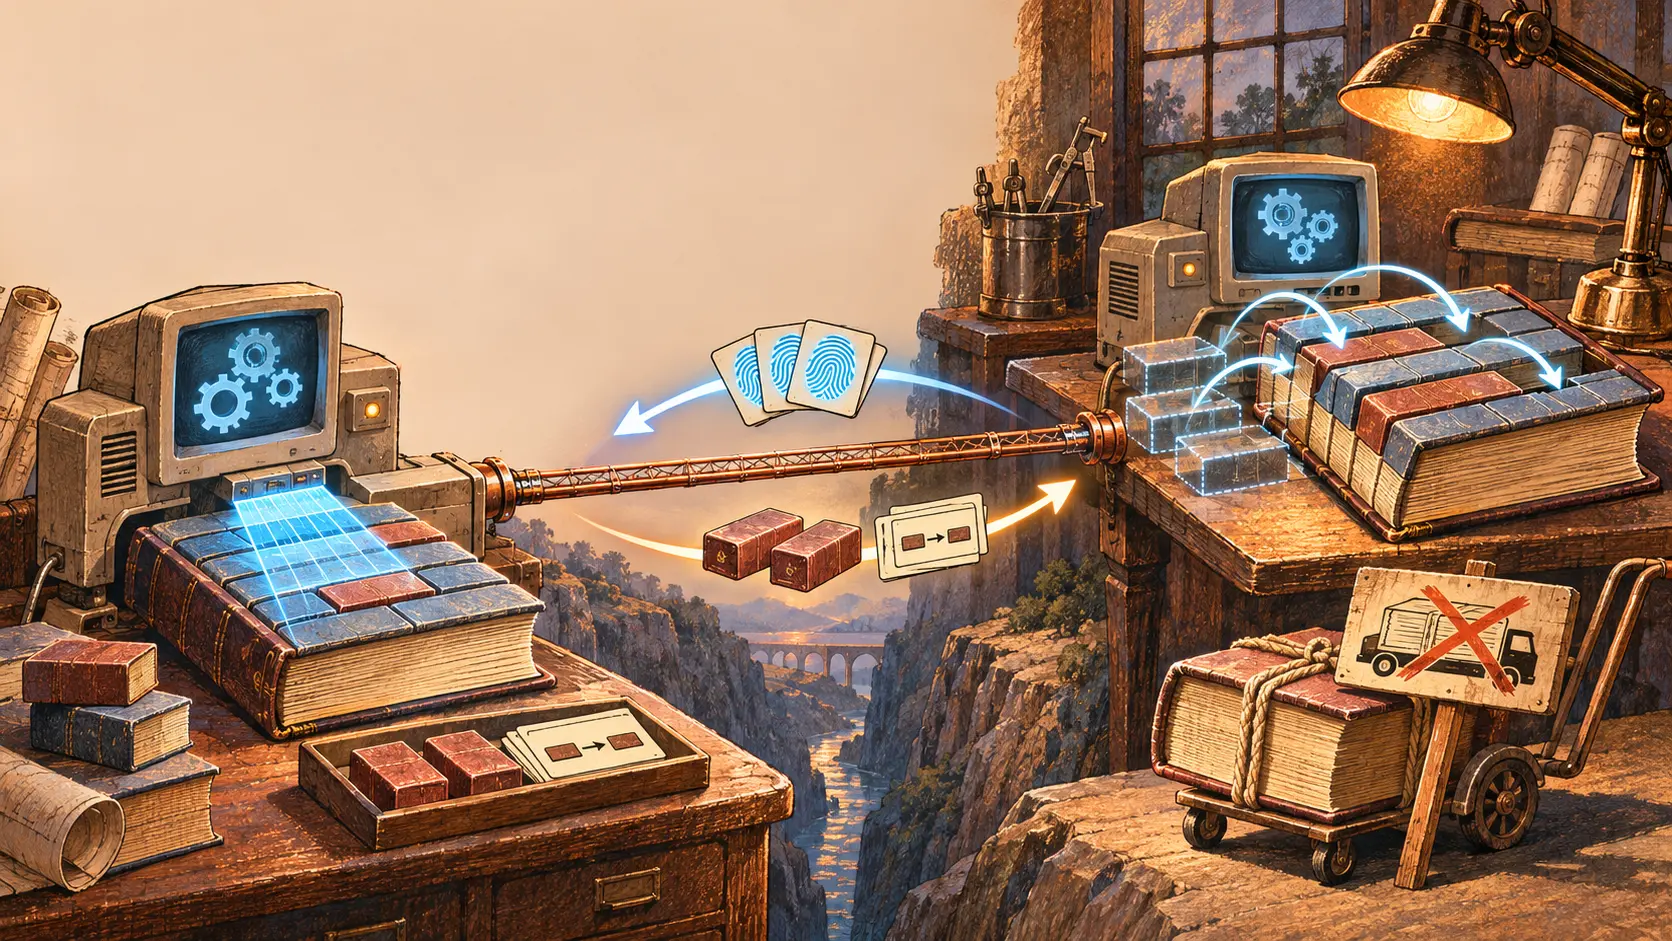
算法的第一步因此由接收方完成。它把自己已有的文件切成互不重叠的块,为每块计算一个便宜的滚动校验和与一个更强的校验和,然后把摘要寄给发送方。最初的算法说明采用 32 位弱校验和与 MD4 强校验和。这是历史设计的参数,不是今天所有版本的配置宣言。关键是发送方得到了“对面已有些什么”的简图,却没有收到整份旧文件。
发送方扫描目标新文件。遇到对面已经有的块,就发送块编号;碰到无法匹配的内容,才发送原始字节。接收方据此从旧文件取块,混入新增字节,拼出目标文件。校验和与块编号也会占用链路,所以“只传差异”是简写,不是逐字节的流量账。对原论文描述的慢链路而言,这些控制信息可能比重寄一份几乎相同的大文件便宜得多。
真正的本领是逐字节滑动
若发送方只检查与旧文件相同的块边界,开头插入一段就足以让后续全部错位。它必须在新文件的任意字节位置寻找接收方的旧块。每移动一个字节就从头计算整块校验和,又会把处理器拖垮。
技术报告的滚动校验章节给出办法:窗口向前挪一字节时,利用上一个结果,减去离开的字节,再加入进来的字节。弱校验命中之后才计算成本更高的强校验。搜索章节还在前面加了一层哈希表筛选。这样即便相同文字换了位置,发送方仍能快速找到旧块。处理器忙着算,窄网线就不用背着整本书再走一趟。
报告还让通信与计算重叠。发现匹配时,发送方可以立即寄出此前未匹配的内容和旧块编号,自己继续往后搜索。原始算法只需要一轮往返来交换摘要和重建指令。对于高延迟链路,少等一轮来回同样有价钱。
省下的字节换成了本地活儿
rsync 项目的实现说明把流程拆成生成器、发送方、接收方三个角色。接收端的生成器判断哪些文件要更新,并为现有“基准文件”发送块校验和。发送方负责搜索,CPU 工作最重。接收方从旧文件中跳着读取可复用块,同时写临时文件,可能碰上沉重的磁盘寻道。拼完后还要比较整文件校验和;对不上就丢弃临时结果,不能把错文件改名充数。
项目文档也没把线路协议夸成整齐的标准教科书。它描述了一条紧凑字节流,消息含义依赖上下文和协议版本,明确边界很少。这样能减少线上开销,却让调试、记录和扩展变难。少传几字节有时意味着维护者要读懂更刁钻的字节流。
这笔交换也有不划算的时候。接收端根本没有相似旧文件,就没有多少旧块可引用;链路很快、磁盘很慢时,额外搜索和读写未必值得。原始报告强调的是相似文件与慢链路,而不是向所有复制任务开一张万能加速支票。
改变历史的是谁先开口
发送方知道最终文件应该是什么样,接收方知道自己手边有哪些旧材料。rsync 让接收方先把旧材料的地图交出来,再让发送方选择哪些块只需指一下、哪些新字节必须亲自送到。双方都不用为了算差异而先把两份文件全集中到一台机器。
最终收到的是一份装配单:用这一块,再用那一块,把新增的字节放在这里。接收方仍要组装并核对。rsync 的胜利并非“差分传输”的无成本魔术,而是用计算、磁盘访问和协议复杂度,换回稀缺的网络容量。快递车不用再搬一整间图书馆,两头仓库却得认真整理书架。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限战略圈层会员
战略圈层
所有读者均可浏览。加入并登录后可解锁档案简报。
加入战略圈层仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance