Résumé
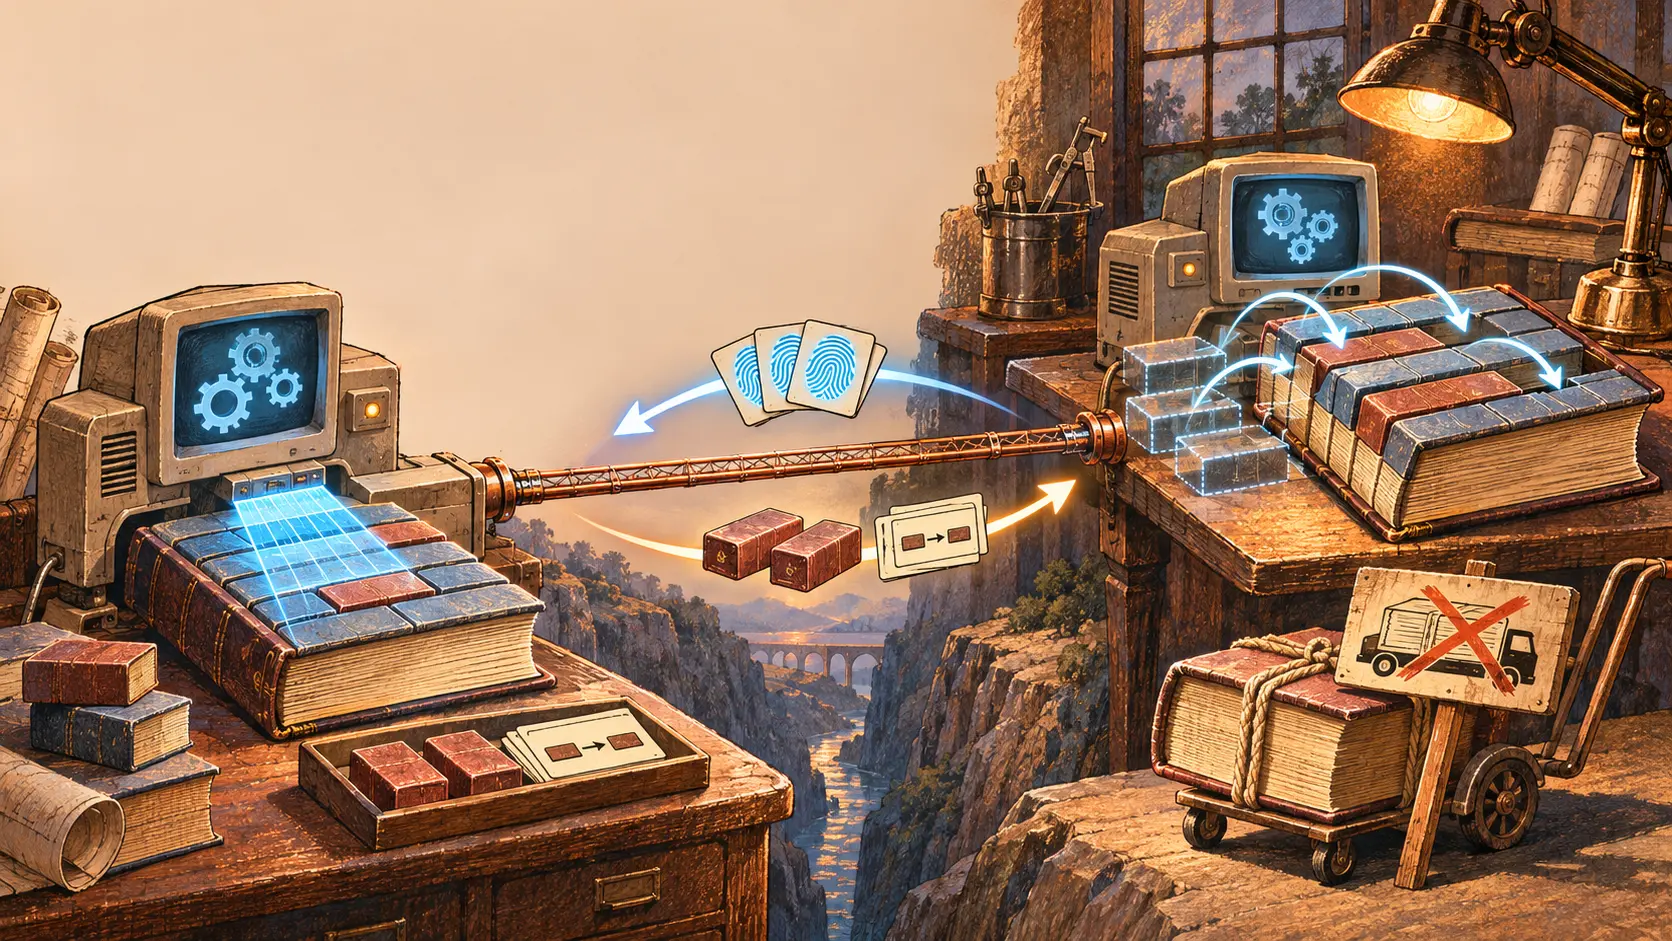
- Dans le rapport technique initial de Tridgell et Mackerras, le destinataire découpe son ancien fichier en blocs et envoie deux sommes de contrôle par bloc. L’émetteur cherche ces blocs à chaque décalage du nouveau fichier, puis transmet des références et les segments absents.
- La description pratique du projet rsync montre la contrepartie : la recherche sollicite le processeur de l’émetteur, la reconstruction lit et écrit sur le disque du destinataire, et une somme de contrôle finale vérifie le fichier assemblé.
Celui qui reçoit expédie d’abord son inventaire
Deux machines possèdent presque le même gros fichier. L’une détient la version à jour; l’autre doit la recevoir par une connexion lente. Une copie ordinaire retransmet tout. Comparer les octets à leur position actuelle ne suffit pas non plus : une phrase insérée au début décale les passages inchangés qui suivent. Le rapport original part de cette difficulté concrète. Chaque machine voit son propre fichier entier, mais pas celui qui se trouve à l’autre bout du fil. Faire un diff local exigerait d’abord le transfert que l’on veut éviter.
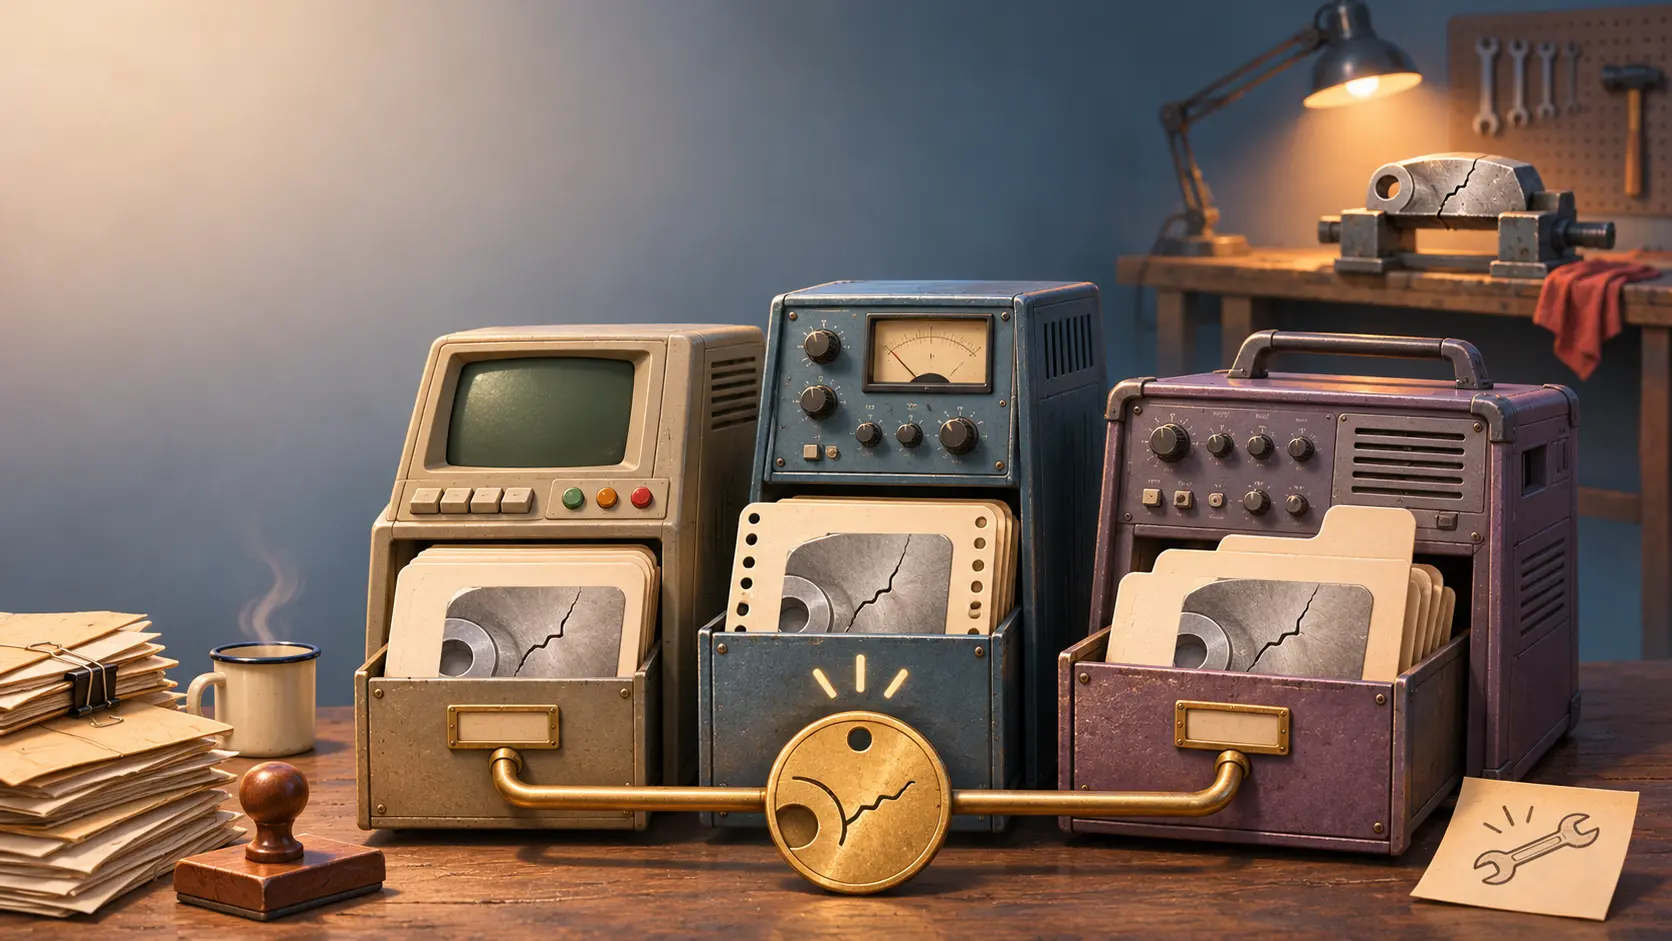
Le premier geste utile revient donc au destinataire. Il découpe son ancien fichier en blocs contigus, calcule pour chacun une petite somme de contrôle « roulante » et une seconde plus forte, puis expédie ces résumés à la source. La description de l’algorithme précise que la première faisait 32 bits et la seconde employait MD4 dans cette version historique. Ce sont des caractéristiques du plan d’origine, pas une affirmation sur toutes les versions actuelles. L’essentiel est que l’émetteur reçoit une description des pièces déjà disponibles sans recevoir le fichier ancien.
Il parcourt alors le fichier désiré. Lorsqu’un bloc correspond à une pièce présente chez le destinataire, il envoie son numéro au lieu de ses octets. Pour ce qui n’existe pas de l’autre côté, il envoie les données elles-mêmes. Le destinataire recompose le nouveau fichier à partir de l’ancien et des morceaux reçus. Les sommes de contrôle et les index de blocs prennent aussi de la place sur le lien. Sur la liaison lente et à forte latence imaginée par les auteurs, cette dépense peut toutefois être bien inférieure à celle d’un nouveau transfert intégral.
Le calcul glissait d’un octet à l’autre
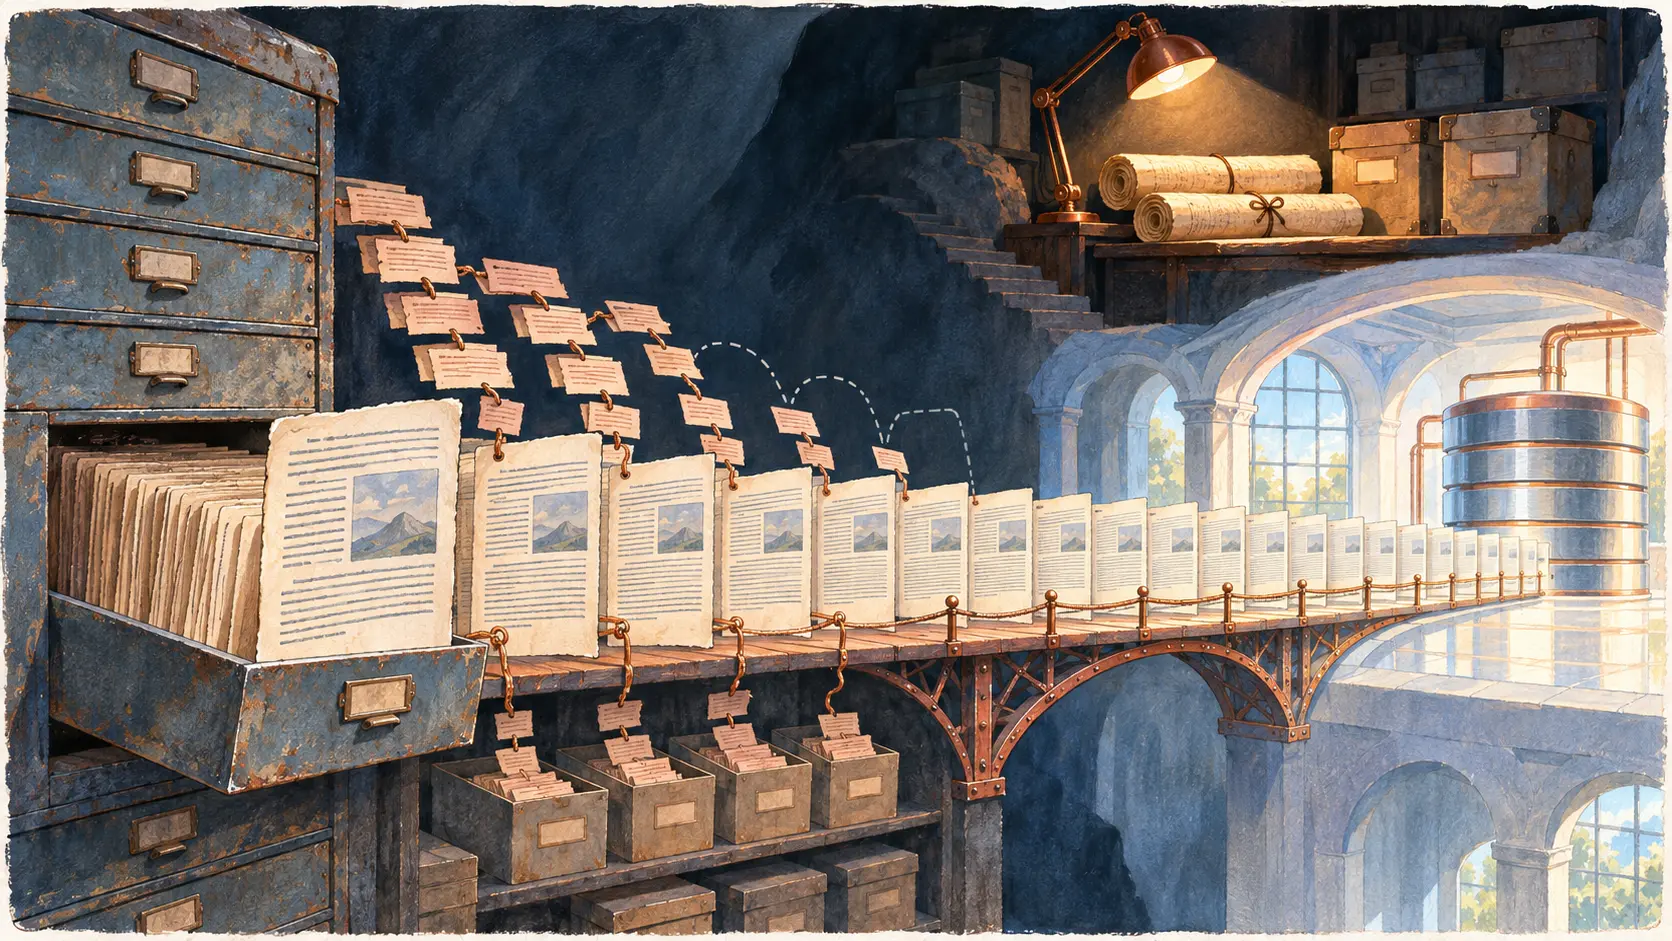
Le découpage en blocs ne suffit pas si l’émetteur regarde uniquement les mêmes positions dans les deux fichiers. Une insertion en tête ferait paraître « différents » tous les blocs suivants. Il faut retrouver les blocs du destinataire à n’importe quel décalage du fichier source. Recalculer une somme complète pour chaque fenêtre déplacée d’un octet serait coûteux.
La section du rapport consacrée à la somme roulante fournit l’astuce. Lorsqu’une fenêtre avance d’un octet, le calcul suivant réutilise le précédent en retirant l’octet sortant et en ajoutant l’entrant. Une correspondance sur cette somme rapide déclenche la vérification plus forte. La description de la recherche ajoute une table de hachage avant ces comparaisons. La machine dépense des calculs pour reconnaître un passage inchangé même lorsqu’il a changé de place; le fil, lui, n’a pas à transporter ce passage une deuxième fois.
Le rapport explique aussi comment le calcul et la communication se recouvrent. Dès qu’une correspondance est trouvée, l’émetteur peut transmettre les données non reconnues et l’index du bloc réutilisé pendant que la recherche continue. L’algorithme originel n’exige qu’un aller-retour de dialogue pour échanger l’inventaire et les instructions. Sur un lien à forte latence, chaque conversation économisée compte.
Les octets évités deviennent du travail ailleurs
La présentation de la mise en œuvre par le projet distingue un générateur côté destination, l’émetteur et le récepteur. Le générateur choisit les fichiers à traiter et envoie les sommes du fichier de base déjà présent. L’émetteur cherche les correspondances; cette étape consomme surtout du processeur. Le récepteur lit parfois des blocs dispersés de l’ancien fichier tout en écrivant une copie temporaire; cette étape peut peser sur le disque. À la fin, une somme de contrôle du fichier entier est comparée. Une reconstruction incorrecte est abandonnée plutôt que rebaptisée en bon fichier.
L’économie d’octets s’accompagne aussi d’un protocole difficile. La même documentation décrit un flux compact dont le sens dépend beaucoup du contexte et de la version, avec peu de frontières explicites entre messages. Cela réduit les frais sur le fil, mais complique l’analyse et l’évolution du protocole. Le projet lui-même en reconnaît le coût. Il a choisi de ménager la ressource rare du scénario initial : la liaison réseau.
Cette économie n’est pas systématique. Un fichier entièrement nouveau ne fournit presque aucun bloc à réutiliser. Un lien rapide et un disque lent peuvent rendre l’analyse plus chère que la copie simple. Le rapport initial présente comme meilleur terrain deux fichiers proches sur une liaison lente. L’algorithme change le lieu de la dépense; il ne la fait pas disparaître.
La trouvaille tenait à l’ordre de parole
La source connaît le fichier final. Le destinataire connaît les pièces anciennes qu’il peut réutiliser. rsync laisse ce dernier les décrire avant que la source ne décide quoi expédier. Il devient possible de comparer deux fichiers séparés sans les rassembler entiers au même endroit. Le message de retour ressemble à un plan de montage : reprendre tel bloc, puis tel autre, et ajouter ici des octets réellement nouveaux.
Le destinataire doit encore reconstruire et vérifier le résultat. Le gain historique de rsync n’est donc pas une magie du « transfert des seules différences ». C’est un échange délibéré de calcul, d’accès disque et de complexité contre de la capacité réseau. Le transporteur n’apporte pas une seconde bibliothèque complète; les deux entrepôts trient davantage leurs rayons.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé au Cercle stratégique
Cercle stratégique
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre le Cercle stratégiqueRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance