Resumen
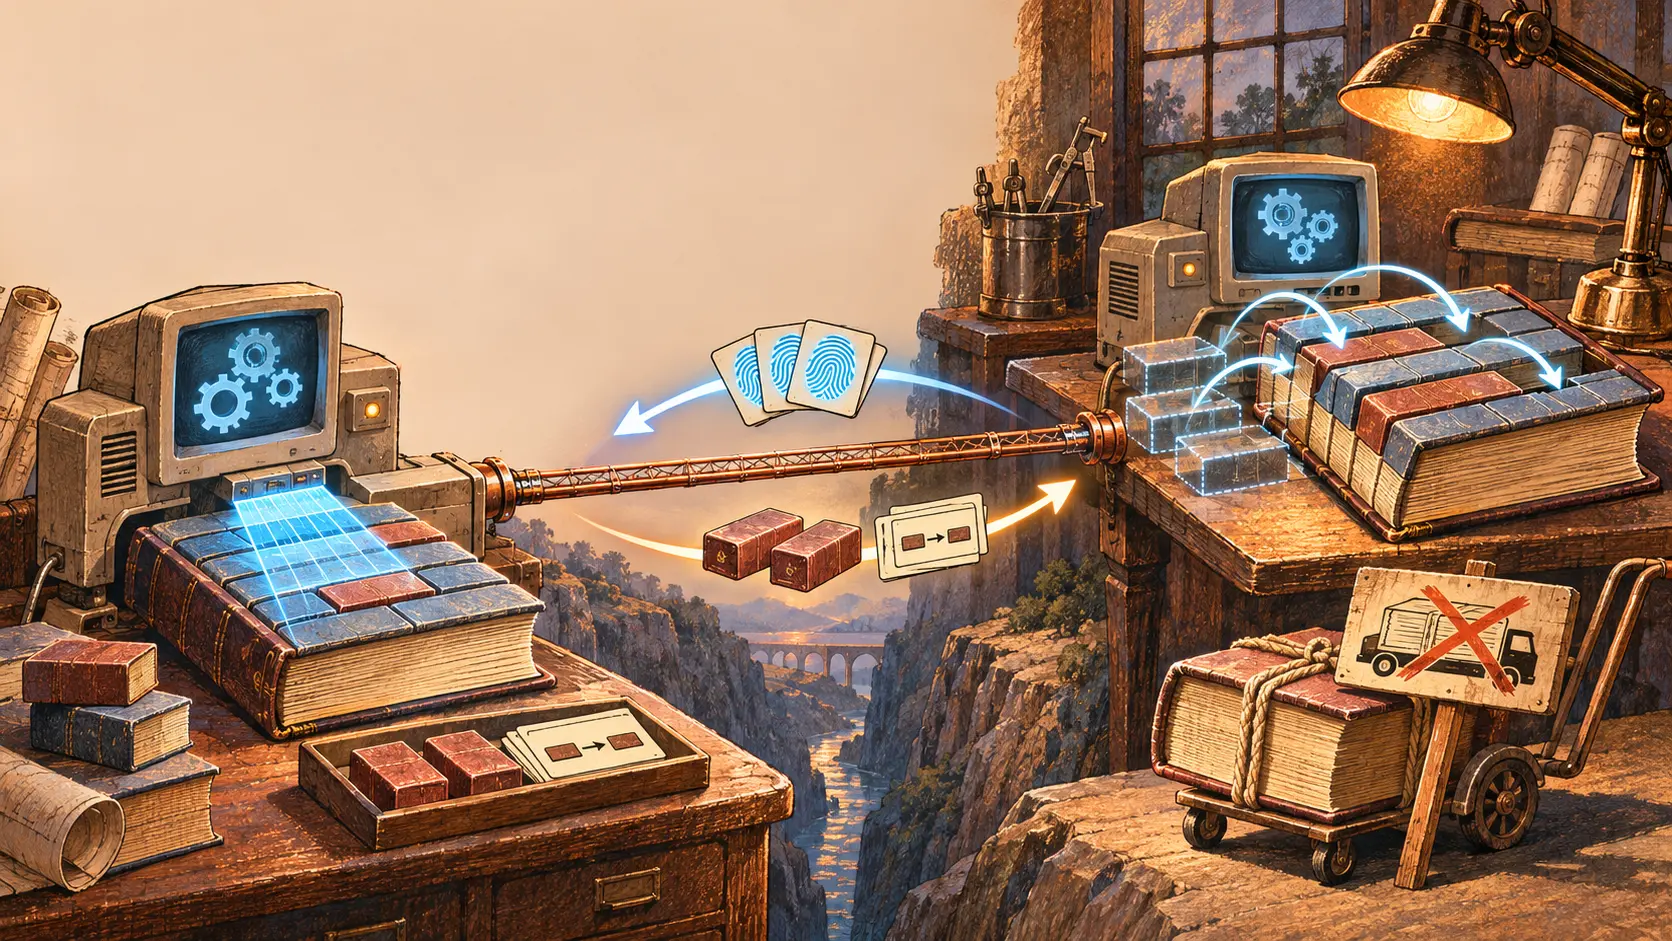
- Según el informe técnico original, el receptor divide su archivo existente en bloques y envía dos sumas de control por cada uno. El emisor busca coincidencias en cualquier posición del archivo nuevo y manda índices de bloques reutilizables más los tramos sin pareja.
- La explicación práctica del propio proyecto expone el precio del ahorro: el emisor gasta CPU buscando coincidencias, el receptor hace lecturas y escrituras de disco, y una suma final comprueba el archivo reconstruido.
El destino mandaba primero su inventario
Imaginemos dos copias casi iguales de un archivo grande a los lados de una conexión lenta. Una versión añade un párrafo cerca del comienzo. Copiar todo otra vez desperdicia el contenido que el destino ya guarda. Comparar únicamente bloques de la misma posición también falla: el párrafo insertado desplaza lo que viene detrás. El informe de Tridgell y Mackerras parte de esa separación física. Cada máquina tiene su archivo completo, pero ninguna posee ambos para ejecutar una comparación local sin usar antes el enlace.
El movimiento ingenioso sale del receptor. Parte su copia antigua en bloques consecutivos, calcula para cada uno una suma rápida y otra más fuerte, y envía esos resúmenes al origen. En el diseño documentado, la primera suma era de 32 bits y la segunda empleaba MD4. Son detalles históricos de aquel diseño, no una descripción de todas las versiones actuales. La idea duradera es dar al origen una representación de lo que ya existe al otro extremo sin transmitirle el archivo antiguo.
El emisor recorre la versión deseada. Si encuentra un bloque que el receptor ya tiene, manda una referencia a esa pieza. Si no lo encuentra, manda los bytes nuevos. El receptor arma el resultado con piezas propias y material recibido. También viajan por la red las sumas y los índices; los datos transferidos no se reducen literalmente a «solo las diferencias». En el enlace lento y con mucha latencia que contemplaba el informe, ese coste adicional podía ser mucho menor que el de repetir un archivo casi idéntico.
Una suma que podía deslizarse de byte en byte
Buscar únicamente en las posiciones originales habría perdido el contenido desplazado por una inserción. El origen necesita buscar bloques del destino en cualquier desplazamiento del archivo nuevo. Calcular desde cero una suma de todo el bloque a cada byte sería demasiado trabajo.
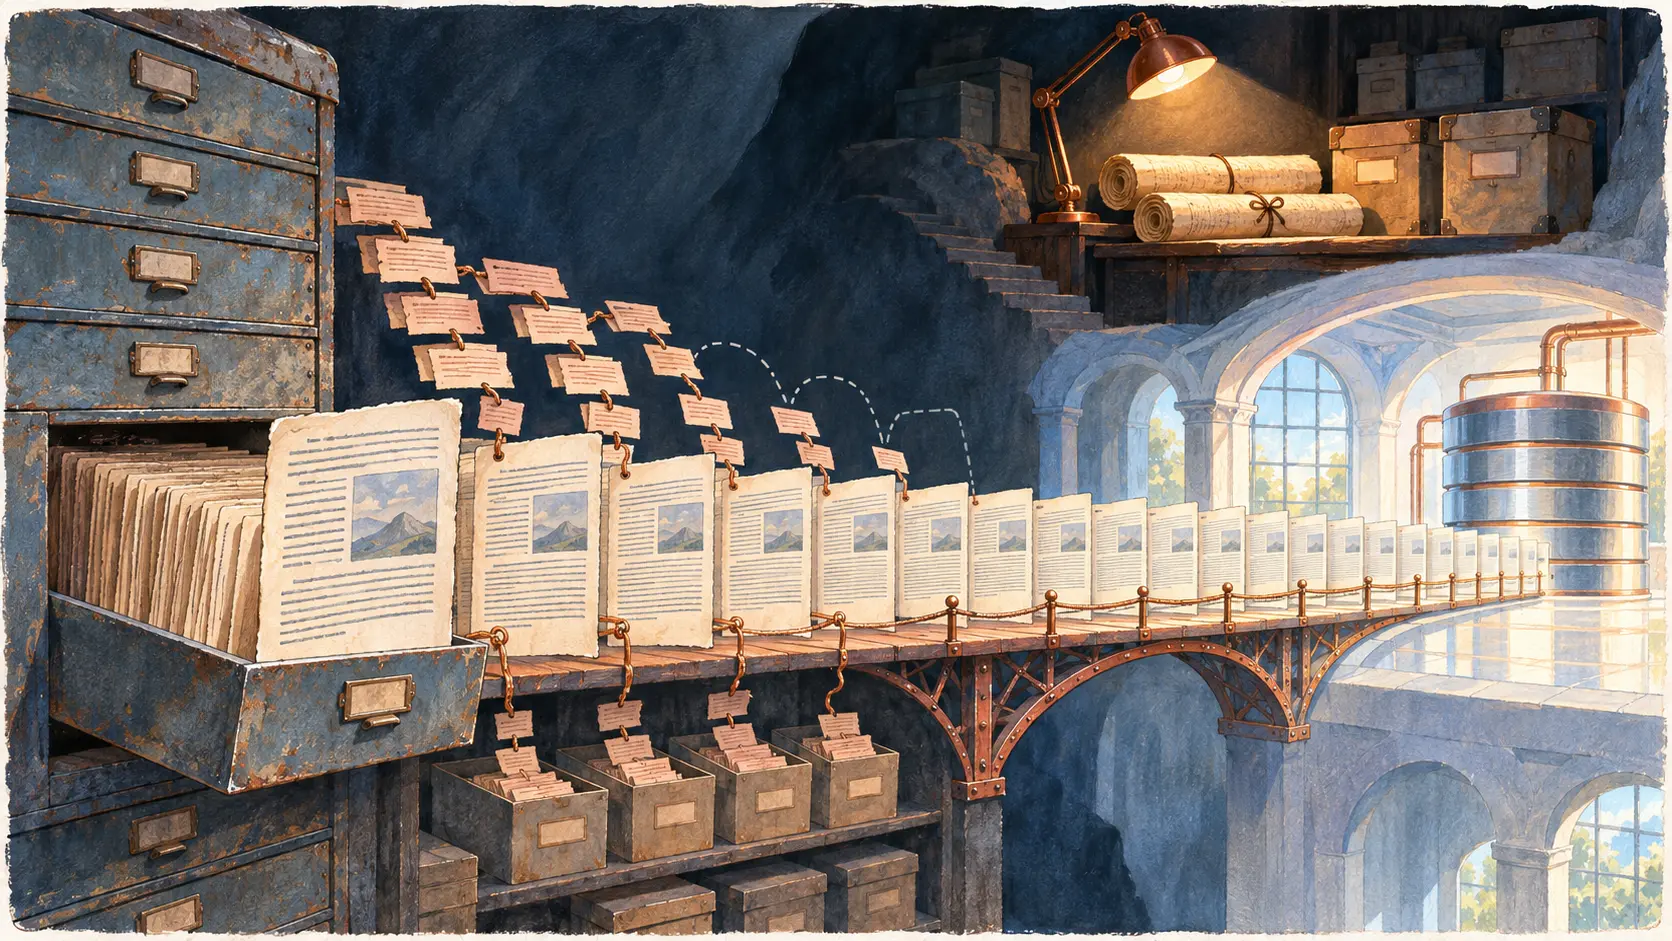
La sección sobre la suma móvil explica el ahorro de cómputo: para pasar a la ventana siguiente se resta el byte que sale y se incorpora el que entra. Solo cuando esta prueba barata coincide se calcula la suma fuerte. La descripción de la búsqueda añade una tabla hash para descartar candidatos antes. Así se reconoce contenido que cambió de lugar sin mandar de nuevo sus bytes. El ordenador hace cuentas para que la línea estrecha no cargue otro libro entero.
El informe también permitía solapar comunicación y cálculo. Cuando el emisor encontraba una coincidencia, enviaba el tramo no coincidente y el índice del bloque mientras seguía buscando. El algoritmo original necesitaba una sola ida y vuelta de mensajes para las sumas y las instrucciones de reconstrucción. En una conexión de alta latencia, evitar rondas de conversación era parte del ahorro.
Los bytes ahorrados tenían contraparte
La documentación del proyecto distingue el generador del lado receptor, el emisor y el proceso que reconstruye el archivo. El generador decide qué archivo debe actualizarse y envía sumas de la copia antigua. El emisor busca y consume CPU. El receptor puede leer bloques dispersos de su archivo mientras escribe uno temporal, con una factura de disco que crece si esas lecturas saltan continuamente. Al terminar, compara la suma del archivo entero; si no coincide, descarta la reconstrucción en vez de presentarla como un éxito.
El protocolo compacto tampoco salía gratis. Su flujo de bytes dependía del contexto y de la versión, con pocas fronteras explícitas entre mensajes. La propia descripción del proyecto advierte que esto hacía difícil documentarlo, depurarlo y ampliarlo. El diseño ahorraba tráfico en la conexión del caso original, pero desplazaba complejidad a los programas que debían entender el intercambio.
Hay situaciones en que no compensa. Si el receptor carece de piezas parecidas, apenas hay referencias que enviar. Si la conexión es rápida y el disco de destino lento, el trabajo adicional puede superar el ahorro de red. El informe original situó su mejor caso en archivos similares separados por un enlace lento. Esa condición explica el invento mejor que la promesa de una sincronización siempre más rápida.
La clave fue decidir quién hablaba primero
El origen sabe cómo debe quedar el archivo. El destino sabe qué piezas conserva cerca. rsync deja que el destino describa esas piezas antes de que el origen decida qué bytes mandar. De este modo se calcula una diferencia útil sin reunir los dos archivos completos en una misma máquina. La respuesta es un plano de montaje: toma este bloque, luego aquel y coloca aquí estos bytes nuevos.
El receptor todavía tiene que montar y comprobar el resultado. La victoria de rsync no fue un truco sin coste para «mandar menos». Cambió ancho de banda escaso por cálculos, acceso al disco y un protocolo difícil de mantener. El transportista dejó de llevar una biblioteca completa, pero ambos almacenes tuvieron que ordenar mejor las estanterías.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para el Círculo Estratégico
Círculo Estratégico
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete al Círculo EstratégicoSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance