Кратко
- В первоначальном техническом отчёте получатель разбивает имеющийся файл на блоки и отправляет две контрольные суммы для каждого. Отправитель ищет эти блоки в новой версии на любом смещении, возвращая ссылки на совпадения и исходные байты несовпавших участков.
- Практическое описание самого проекта показывает оборотную сторону экономии: поиск расходует CPU отправителя, сборка использует диск получателя, а итоговая контрольная сумма проверяет построенный файл.
Сначала приходила опись того, что уже лежит на месте
Представим большой файл в двух почти одинаковых версиях по разные стороны медленной линии. В новую редакцию вставили абзац близко к началу. Обычное копирование вновь перевезёт страницы, которые получатель уже хранит. Сравнение блоков только на прежних позициях тоже даст ложную картину: вставка сдвинула почти весь остальной текст. Авторы исходного отчёта рассматривали именно два удалённых компьютера с низкой пропускной способностью и большой задержкой. Чтобы сделать обычный локальный diff, пришлось бы сначала собрать оба полных файла в одном месте — то есть выполнить дорогую передачу.
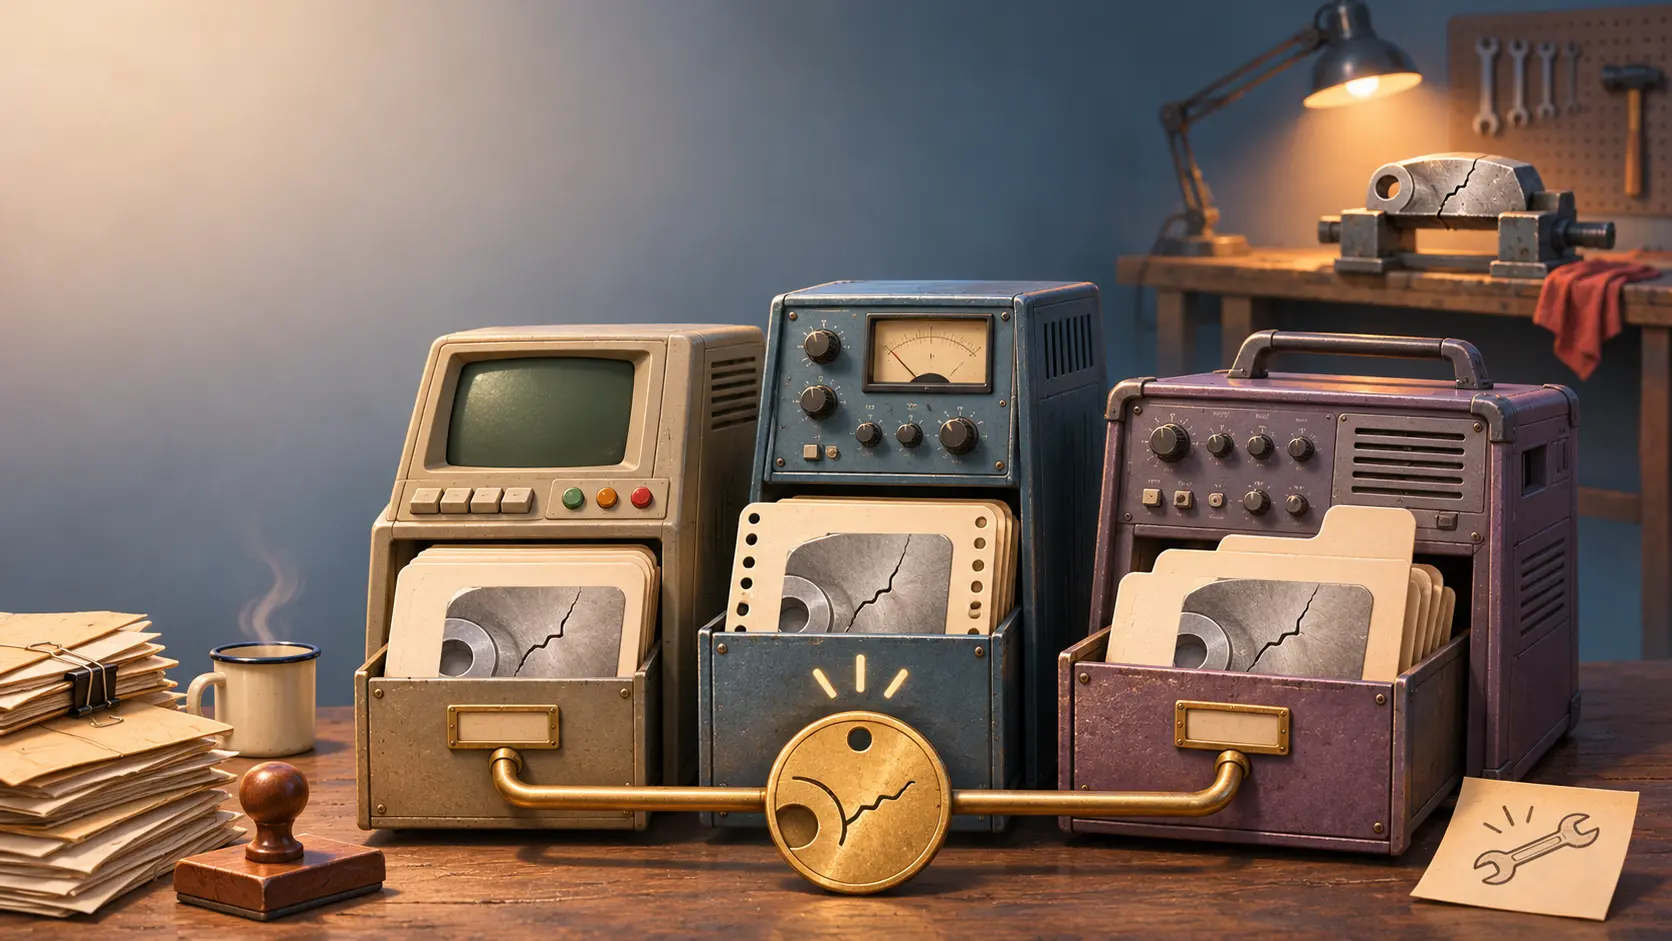
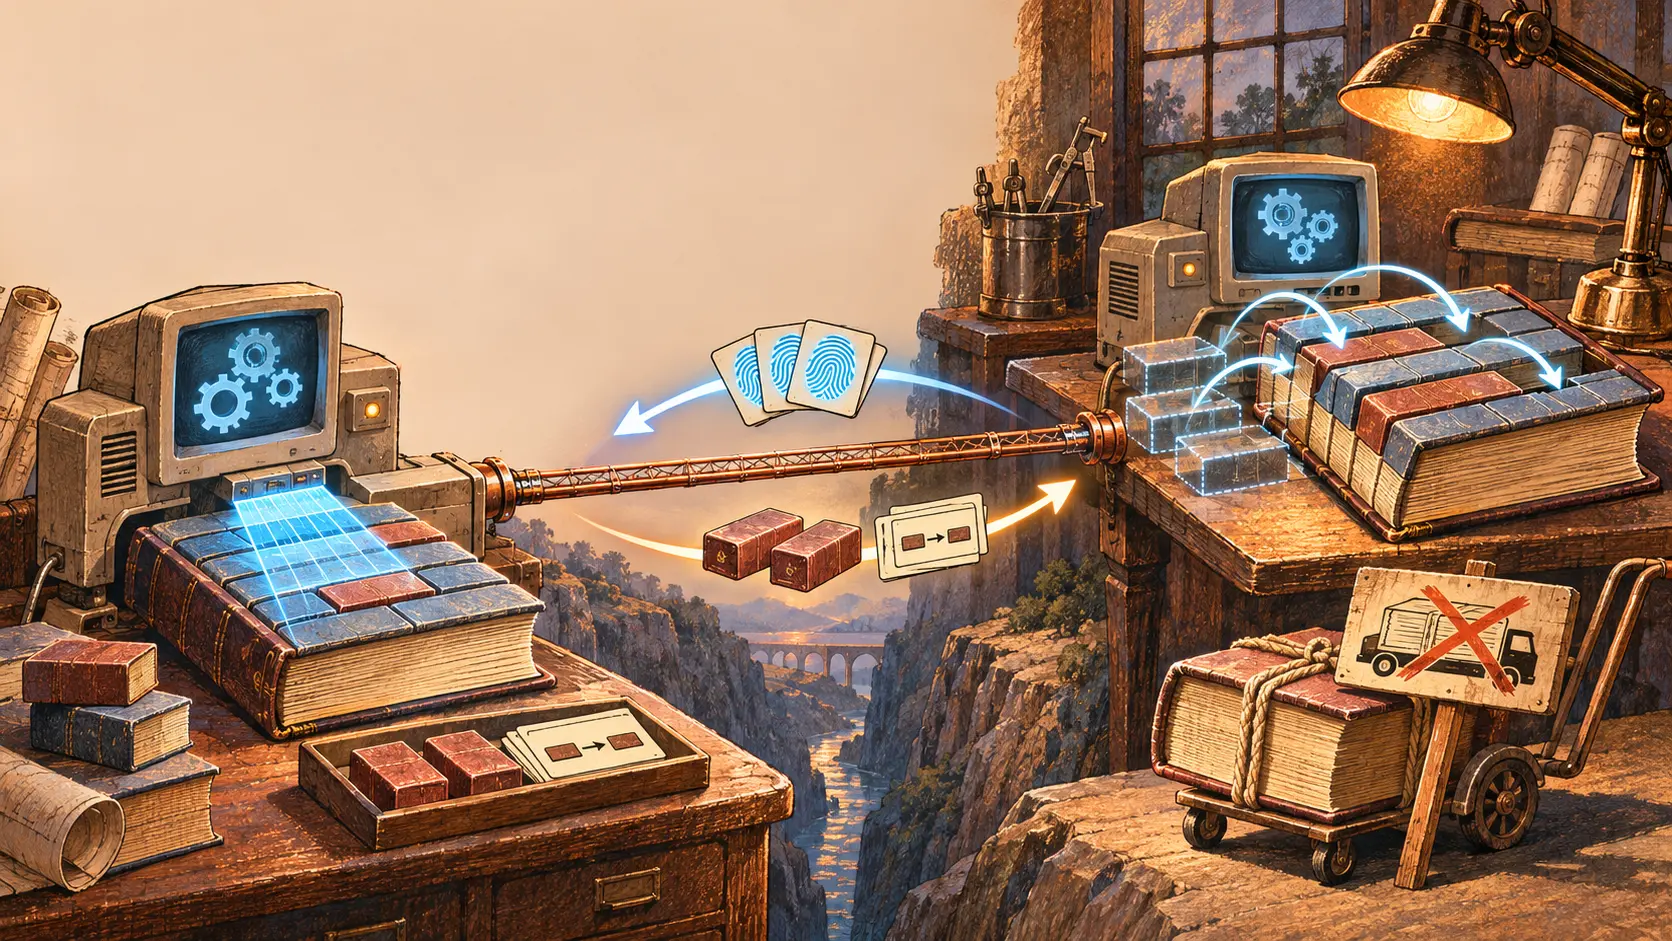
Первый полезный ход делает будущий получатель. Он режет старый файл на неперекрывающиеся блоки, вычисляет для каждого быструю скользящую и более сильную контрольную сумму, затем отправляет эти краткие сведения источнику. В историческом варианте алгоритма слабая сумма была 32-битной, а сильная использовала MD4. Эти числа относятся к первоначальному проекту, не ко всем нынешним выпускам программы. Источник получает описание находящихся на другом конце кусков, не скачивая сам старый файл.
Далее источник сканирует желаемую новую версию. Если фрагмент уже есть у получателя, отправляется номер блока; если совпадения нет — настоящие новые байты. Получатель собирает файл из своих старых фрагментов и доставленного материала. Суммы и номера блоков тоже занимают место в канале, поэтому фраза «передаются только отличия» не является буквальным отчётом о каждом байте. Для похожих файлов на медленной линии служебный груз может быть намного меньше полной повторной копии.
Окно должно было сдвигаться по одному байту
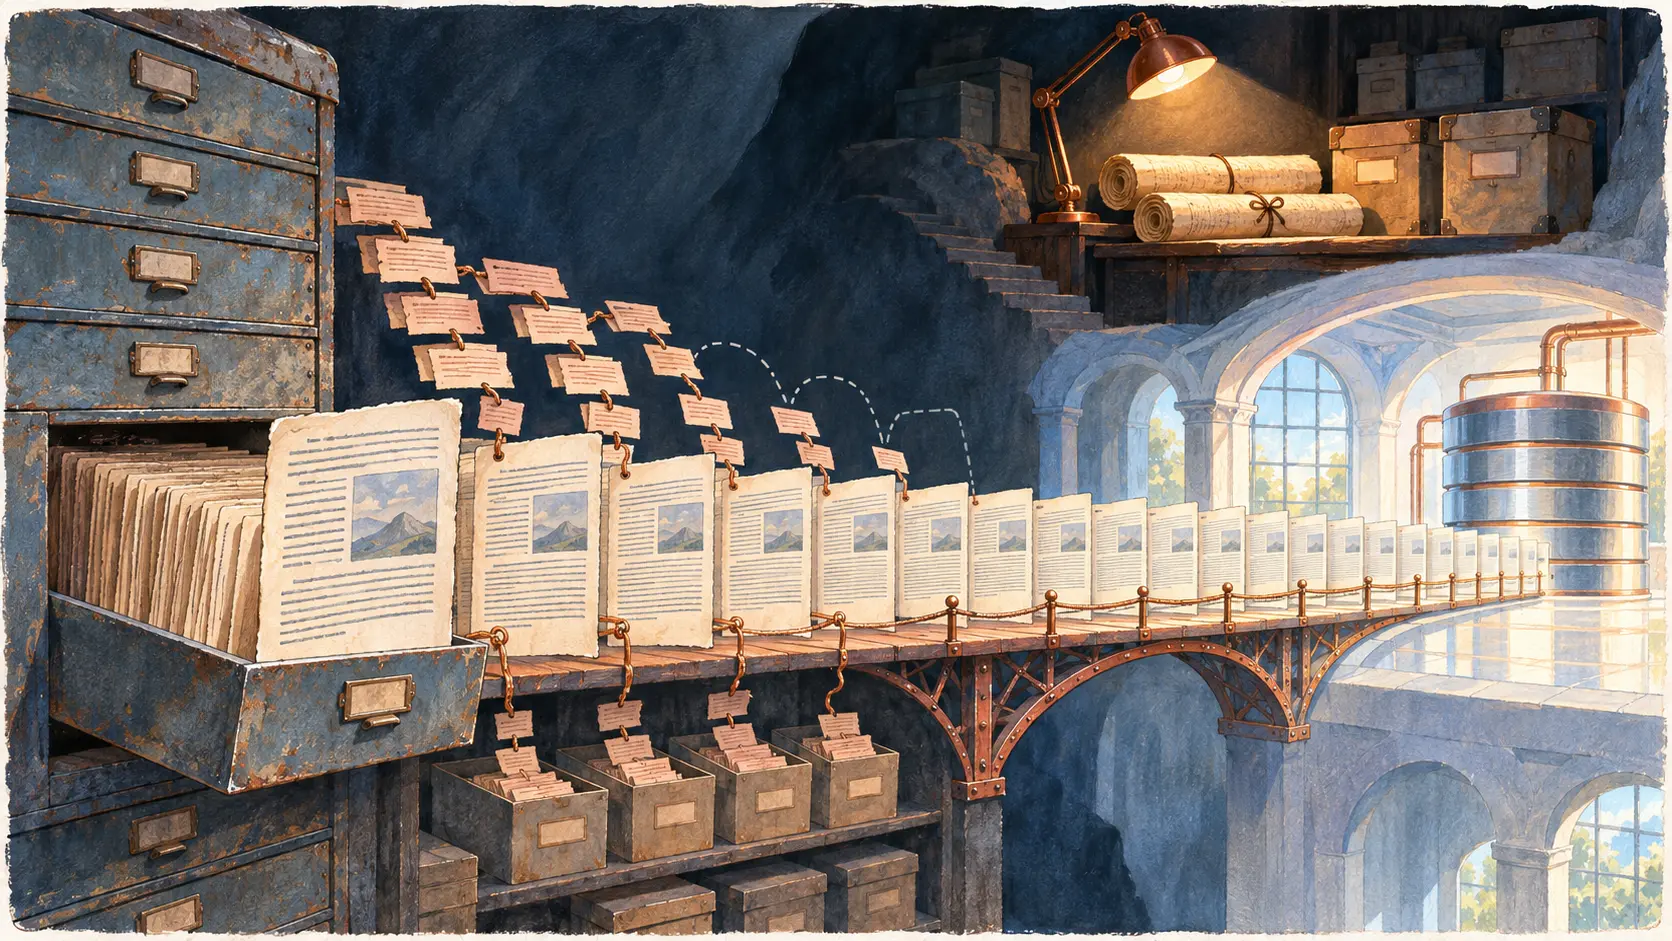
Поиск только на старых границах блоков пропустил бы всё, что поменяло положение после вставленного абзаца. Отправителю нужно найти блок получателя на любом байтовом смещении новой версии. Пересчитывать сумму всего окна при каждом шаге было бы слишком затратно.
Раздел отчёта о скользящей сумме объясняет приём: значение для следующего окна получается из предыдущего, когда уходящий байт вычитается, а входящий добавляется. Дорогая сильная проверка проводится лишь при совпадении дешёвой. Раздел о поиске добавляет первичное отсеивание через хеш-таблицу. Поэтому старый блок можно обнаружить, даже если он переехал в другое место файла. Процессор делает арифметику, чтобы узкий провод не тащил ту же книгу второй раз.
Отчёт описывает и одновременное выполнение поиска и передачи. Обнаружив совпадение, отправитель может послать накопленный новый участок и номер блока, а сам искать дальше. Для обмена списком сумм и командами реконструкции исходному алгоритму хватало одной поездки туда-обратно. На линии с большой задержкой дополнительный диалог тоже стоил бы времени.
За сэкономленные байты заплатили машины
Описание реализации на сайте проекта выделяет генератор на стороне получателя, отправителя и собственно принимающий процесс. Генератор решает, что обновлять, и посылает суммы старого файла-основы. Отправитель ищет совпадения и сильнее всего нагружает процессор. Принимающий процесс может читать разрозненные участки старого файла, одновременно записывая временный новый, — это тяжело для диска. В конце проверяется сумма целого файла. Если результат неверен, временная копия удаляется.
Экономный протокол тоже предъявлял счёт. Проектная документация описывает сплошной поток байтов, где смысл участка зависит от контекста и версии протокола, а явных границ сообщений мало. Накладные расходы линии меньше, зато разбирать ошибки, описывать и расширять обмен сложнее. Сбережённую пропускную способность оплачивает труд разработчиков и обслуживающего кода.
Если у получателя нет похожего старого файла, ссылаться почти не на что. Если линия быстрая, а хранилище медленное, дополнительный поиск и чтение могут обойтись дороже прямой копии. Первоначальный отчёт называл лучшим случаем похожие файлы через медленное соединение. Алгоритм направлял затраты туда, где оставался запас, а не отменял их.
Изобретение изменило очередь выступающих
Отправитель знает, каким должен стать файл. Получатель знает, какие старые фрагменты у него под рукой. rsync велел сначала получателю описать эти фрагменты, а затем отправителю выбрать ссылки и новые байты. Так можно вычислить полезное различие, не собирая оба полных файла на одной машине. Ответ напоминает инструкцию по сборке: возьми этот блок, затем другой и вставь свежий фрагмент.
Получателю всё ещё нужно собрать и проверить результат. История rsync — не бесплатный фокус «передать меньше». Это обмен CPU, дисковых операций и сложности протокола на дефицитную сетевую ёмкость. Курьеру не пришлось вновь везти всю библиотеку; зато оба склада стали внимательнее к полкам.
Обзор для участников
Подробный контекст профиля
Войдите с подходящим уровнем подписки, чтобы открыть полный обзор и примечания к источникам.
Только для Стратегического сообщества
Стратегическое сообщество
Открыто всем читателям. Вступите и войдите, чтобы открыть обзоры профилей.
Вступить в Стратегическое сообществоТолько для Альянса лидеров
Альянс лидеров
Для проверенных владельцев IP-активов и руководителей. Войдите, чтобы открыть обзоры Альянса.
Вступить в Альянс лидеров