Resumo
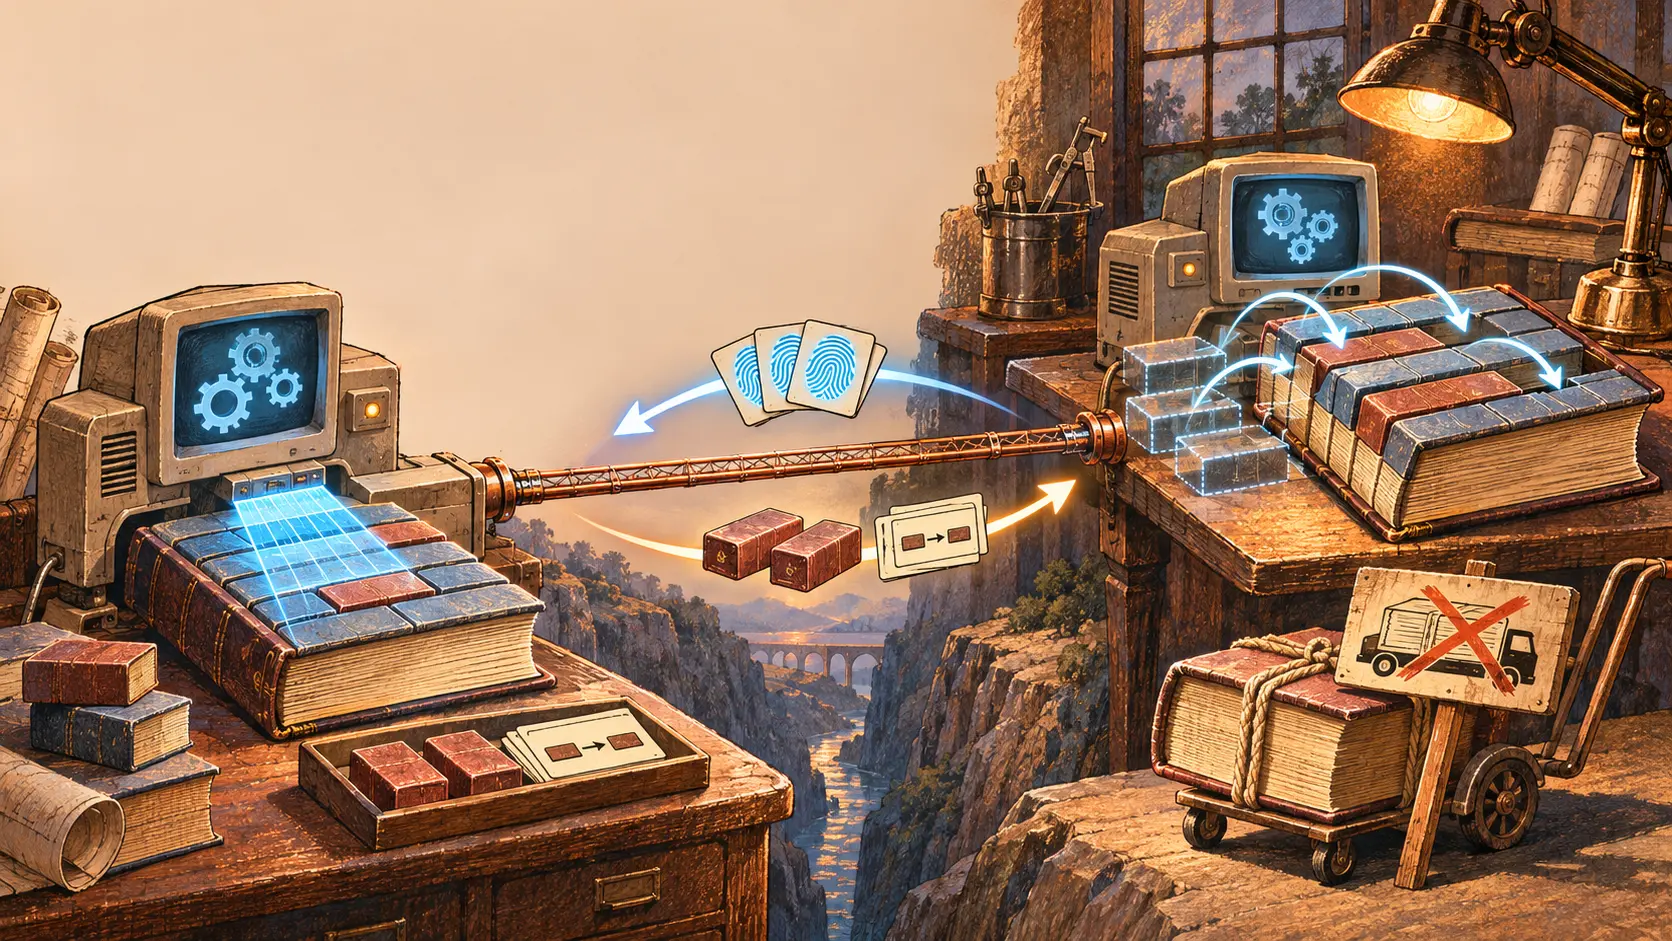
- No relatório técnico de Tridgell e Mackerras, o destino divide o arquivo que já possui e envia duas somas por bloco. A origem procura os blocos em qualquer posição do arquivo atualizado e devolve referências aos trechos reaproveitáveis e dados literais para o restante.
- A descrição prática do projeto rsync mostra o custo transferido: a busca usa CPU da origem, a montagem usa disco do destino, e uma soma do arquivo inteiro confere o resultado.
O destino enviou a lista do estoque
Duas versões de um arquivo grande estão em máquinas separadas. A mais nova ganhou um parágrafo perto do começo; boa parte do resto é igual. Uma cópia integral transporta pela segunda vez o conteúdo que o destino já guarda. Uma comparação só entre blocos nas mesmas posições também erra, porque a inserção empurra tudo que vem depois. O relatório original trata justamente desse caso de conexão com pouca banda e muita latência: cada máquina conhece seu arquivo, mas nenhuma possui os dois para fazer uma comparação local sem usar a ligação antes.
A primeira mensagem útil parte de quem receberá a atualização. Essa máquina reparte sua versão em blocos contíguos, calcula uma soma rápida que pode deslizar e outra mais forte para cada bloco, e envia a lista à origem. Na versão histórica descrita no relatório, a soma fraca tinha 32 bits e a forte era MD4. Esses eram os parâmetros daquele desenho, não uma descrição geral das versões de hoje. A origem ganha um retrato das peças que existem do outro lado sem precisar receber o arquivo antigo.
Em seguida, ela percorre a versão desejada. Quando acha conteúdo igual a um bloco do destino, transmite o número daquele bloco. Para os trechos sem correspondência, envia os próprios bytes. A máquina receptora combina o material recebido com suas peças antigas. A ligação também transporta somas e índices, portanto não carrega literalmente apenas as diferenças. Para arquivos semelhantes sobre o link estreito do exemplo, esse custo extra pode ser menor que o de repetir o arquivo inteiro.
A janela tinha de andar um byte por vez
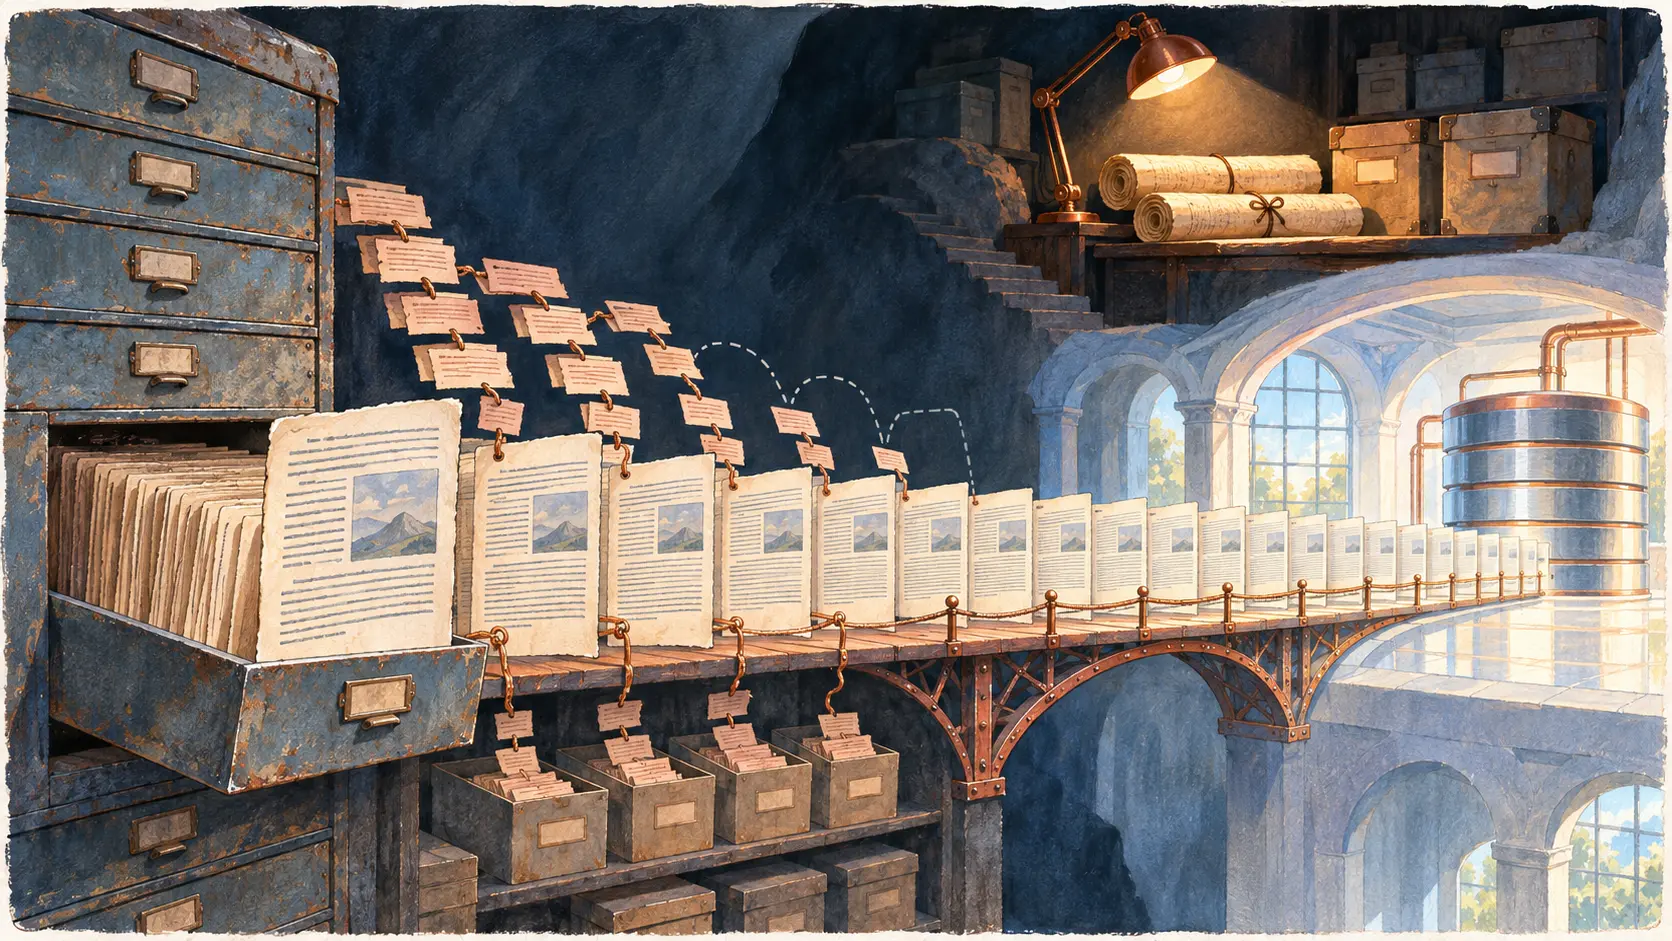
Uma busca limitada às mesmas posições perderia quase todo o conteúdo depois de uma inserção. A origem precisa localizar um bloco do destino em qualquer posição da versão nova. Recalcular toda a soma para cada janela deslocada um byte seria pesado.
A seção sobre a soma móvel explica a solução: ao avançar a janela, o valor seguinte aproveita o anterior, retirando o byte que saiu e acrescentando o que entrou. A verificação mais cara ocorre apenas quando a soma rápida encontra candidato. A seção de busca põe ainda uma tabela de dispersão antes dessas comparações. É por isso que o algoritmo encontra material que mudou de lugar. O processador trabalha mais para que o fio fino não carregue o mesmo livro outra vez.
O relatório descreve também a sobreposição entre busca e envio. Ao encontrar uma correspondência, a origem pode transmitir o trecho novo acumulado e o índice do bloco enquanto segue procurando. O desenho original exige uma ida e volta para trocar o inventário e as instruções. Em conexões de grande latência, evitar várias rodadas de conversa já era uma economia.
Os bytes economizados viraram trabalho local
A explicação de implementação do próprio projeto separa gerador, emissor e receptor. O gerador no destino decide o que atualizar e calcula as somas da cópia que servirá de base. O emissor procura correspondências e exige bastante CPU. O receptor lê partes às vezes distantes de seu arquivo antigo e escreve uma cópia temporária, exigindo disco. Ao final, compara-se uma soma do arquivo completo; se a montagem falhar, o resultado temporário é descartado.
Nem o protocolo escapou da conta. A documentação do projeto descreve um fluxo compacto de bytes, com poucos limites explícitos entre mensagens e significado dependente do contexto e da versão. Isso reduz o peso na rede, mas dificulta documentação, depuração e extensão. A decisão de poupar a conexão lenta cobrou trabalho dos programas e de quem os mantém.
Se o destino não tem material parecido, há poucos blocos para reaproveitar. Se a rede é rápida mas o disco demora, o cálculo e as leituras podem custar mais do que uma cópia direta. O relatório original tratou arquivos semelhantes numa ligação lenta como seu melhor caso. O algoritmo mudou a distribuição da conta, não aboliu a conta.
A invenção mudou quem falava primeiro
A origem sabe como deve ficar o arquivo. O destino sabe quais peças antigas tem ao alcance. rsync deixa o destino descrevê-las antes de a origem decidir o que expedir. Assim se encontra uma diferença útil sem reunir os dois arquivos inteiros numa máquina. A resposta parece uma instrução de montagem: reutilize este bloco, depois aquele, e acrescente estes bytes.
Ainda cabe ao receptor montar e verificar. A história do rsync não é um truque sem custos chamado “enviar só diferenças”. É a escolha de gastar CPU, disco e complexidade de protocolo para poupar capacidade escassa da rede. O entregador evita transportar toda a biblioteca; os dois depósitos precisam organizar as estantes.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Exclusivo para o Círculo Estratégico
Círculo Estratégico
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Círculo EstratégicoSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance