En bref
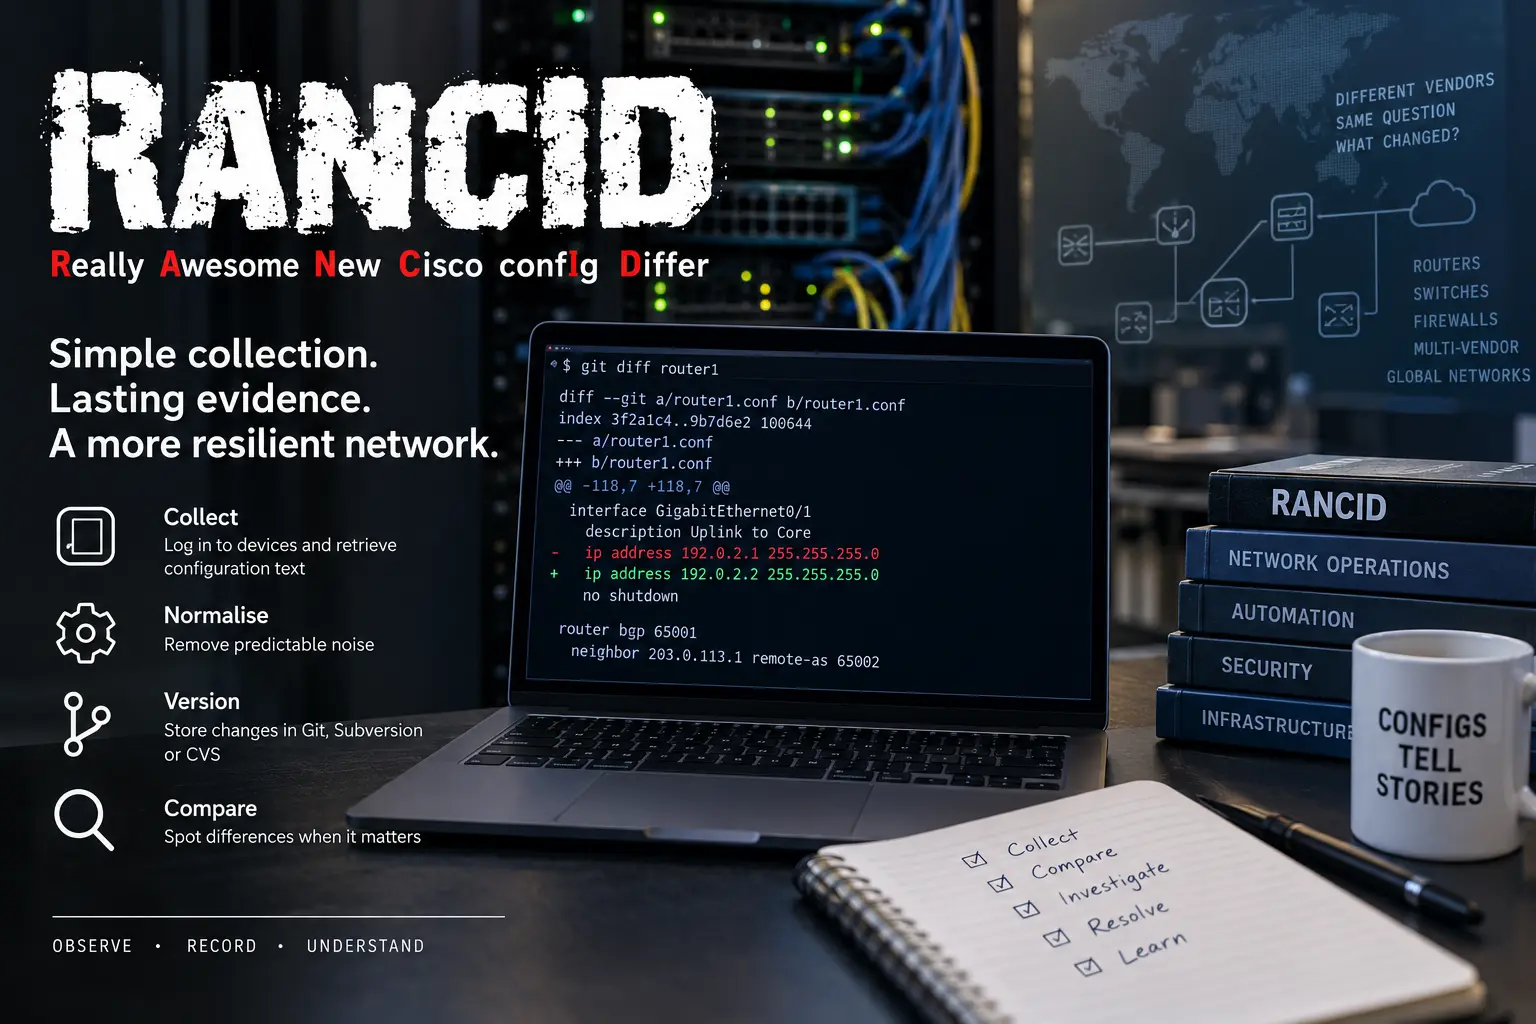
- RANCID — Really Awesome New Cisco confIg Differ — collecte régulièrement les configurations via des scripts de connexion et des modules orientés constructeurs, normalise la sortie et enregistre les changements dans CVS, Subversion ou Git.
- Son matériau est un texte observable, et non un état souhaité: un instantané peut révéler une dérive ou un changement urgent, mais passer à côté des actions intermédiaires, de l'état d'exécution et de l'identité de l'auteur.
- L'hôte qui améliore l'investigation des incidents devient une cible de grande valeur, car il concentre les identifiants de gestion, la topologie et les secrets de configuration de l'ensemble du parc.
- RANCID reste utile aux côtés de GitOps, de l'automatisation et des systèmes de référence, car un collecteur indépendant peut montrer ce que l'équipement a réellement rapporté après une intervention ou une exécution partielle du processus officiel.
Après une panne, la plus petite question utile est souvent « qu'est-ce qui a changé? »
Un réseau peut tomber à cause d'une interaction complexe entre politique de routage, état des interfaces, défaillances logicielles et charge. Mais la première piste pratique reste une seule ligne: l'adresse d'un voisin a changé, une ACL a été déplacée, un match a été ajouté à un route-map, un trunk a perdu un VLAN. L'équipement a accepté la commande, et les conséquences sont apparues plus tard, et parfois loin du point de modification.
RANCID a été conçu pour préserver cette piste. Il se connecte aux routeurs, commutateurs et autres équipements pris en charge, exécute des commandes, filtre la sortie et commit le texte obtenu dans un système de versions. Lorsqu'un fichier change, le dépôt affiche un diff et peut envoyer un courriel ou déclencher un autre workflow. Le système n'a pas besoin de comprendre tout l'objectif métier pour constater que l'équipement rapporte désormais un autre texte.
La modestie du modèle est une qualité. RANCID ne prétend pas être un plan de contrôle complet. Il ne planifie pas de fenêtre, ne génère pas toutes les configurations et ne garantit pas la conformité. Il effectue des observations périodiques. C'est donc utile dans un parc mixte, où certains équipements sont automatisés, d'autres gérés manuellement, et d'autres encore trop anciens pour une API moderne.
Le modèle est incomplet par conception. Un changement peut être appliqué et annulé entre deux collectes. Un échec de connexion laissera un ancien fichier paraître récent. Un module constructeur peut ne pas interroger la commande décisive. La normalisation peut retirer une valeur qui se révélera importante plus tard. Le diff ne prouve que la différence de texte vue par le collecteur; il ne prouve ni qui ni pourquoi l'équipement a été modifié, ni si cela a causé la panne.
Ces limites ne réduisent pas la valeur de la preuve, elles la délimitent précisément. RANCID apporte une réponse durable et peu complexe à une question restreinte. Pendant un incident, c'est parfois plus utile qu'un large tableau de bord de symptômes sans contexte de configuration.
Le projet a donné aux routeurs une mémoire externe avant que les contrôleurs ne soient à la mode
RANCID est né à une époque où les équipements réseau étaient gérés principalement en CLI. La configuration vivait sur les routeurs et commutateurs, et le savoir opérationnel dans la mémoire des ingénieurs, l'historique des terminaux et des répertoires personnels. Un remplacement d'équipement ou une commande erronée pouvait révéler que l'organisation ne disposait d'aucune copie à jour indépendante.
Le nom commençait par Cisco, mais la couverture s'est élargie grâce aux modules constructeurs. L'architecture a accepté un fait inconfortable: les invites, les séquences de connexion, la pagination et les commandes diffèrent. Plutôt que d'attendre un modèle unique, RANCID a automatisé les interfaces réelles.
clogin, qui fonctionne via Expect, peut reconnaître les invites, mener une session, passer en mode privilégié et exécuter des commandes. Le module récupère la configuration en cours, l'inventaire ou un autre état; la sortie est ensuite normalisée et enregistrée sous forme de texte.
L'approche est aussi fragile que toute automatisation en CLI. Une nouvelle invite casse le script. Le firmware change la sortie. Bannières, pagination, authentification et synchronisation varient. Certains équipements exigent Telnet ou d'anciennes suites de chiffrement. Les modules locaux peuvent diverger de l'amont.
Sa longévité montre que l'interopérabilité naît souvent de l'adaptation, non d'une norme parfaite. RANCID ne rend pas les CLI identiques; il crée un processus commun par-dessus les différences. Le dépôt devient l'interface stable. L'essentiel: la mémoire quitte l'équipement — même en cas de destruction totale d'un routeur, la dernière configuration et l'historique subsistent.
router.dbtransforme le parc en un plan de collecte planifié
Le processus traditionnel commence parrouter.db, qui associe noms d'hôtes, types et états. Les enregistrements actifs deviennent des cibles. Les groupes définissent les planifications, les dépôts et les périmètres de responsabilité. Le fichier est simple à relire et à versionner, mais il détermine quels équipements seront mémorisés et lesquels resteront invisibles.
La simplicité rend les erreurs lisibles: une faute de frappe dans un nom, un type erroné, un état désactivé. Mais elle ne garantit pas l'exhaustivité. Un routeur absent n'est pas détecté automatiquement. Un équipement retiré peut rester listé. Un nom peut se résoudre vers une adresse inattendue. La liste doit être confrontée à un registre d'actifs ou à une source de référence.
Lorsquerancid-runs'exécute, il sélectionne les cibles actives, appelle la connexion et la logique constructeur, récupère la sortie, la compare et commit les changements significatifs. Erreurs et tentatives répétées font partie du service. Un équipement peut être injoignable, l'authentification échouer, une commande renvoyer des données incomplètes. Chaque exécution doit avoir un statut; l'existence d'un fichier ne prouve pas sa fraîcheur.
Une copie ancienne peut être propre et convaincante. L'opérateur a besoin de la date du dernier collecte réussie, du nombre d'échecs consécutifs et de la confirmation que toutes les commandes attendues ont été exécutées. Un archive sans suivi de fraîcheur crée une fausse confiance.
Les groupes permettent de limiter le rayon d'impact. Des environnements différents utilisent des identifiants, des fréquences et des dépôts distincts; les équipements critiques peuvent être collectés plus souvent ou depuis des hôtes isolés. Maisrouter.dbn'est pas une source d'intention: c'est un plan de collecte. Une comparaison avec NetBox, Nautobot ou un registre d'actifs révèle les équipements sans historique et les parcs oubliés.
La connexion via Expect a rendu l'automatisation possible et a concentré les secrets
Les CLI interactives ont été conçues pour des humains. Elles affichent des bannières, demandent identifiant et mot de passe, négocient le terminal, suspendent la sortie et changent d'invite selon le mode. Expect attend un motif et répond, transformant le dialogue en séquence automatisée.
RANCID utilise ce modèle. Ses outils ouvrent Telnet ou SSH, gèrent les invites, passent en mode privilégié et lancent les commandes. C'est ainsi que l'on automatisait les équipements bien avant les API pilotées par modèle.
Le mécanisme crée une concentration de risque sérieuse. Le collecteur peut avoir besoin d'accéder à des centaines ou des milliers d'équipements. Les identifiants sont souvent décrits dans.cloginrcet protégés par les droits du système de fichiers. La compromission de l'hôte ou du fichier donne à l'attaquant une carte du parc et des données pour le plan de gestion. Les comptes partagés et privilégiés élargissent les conséquences.
Même « lecture seule » dépend de la plateforme. Certains équipements séparent mal l'affichage de la configuration des commandes plus larges. Le dépôt peut contenir des chaînes de communauté, des hachages, des clés, des noms de clients et des adresses internes. Le filtrage aide, mais ne garantit pas l'absence de secrets.
L'hôte RANCID doit être considéré comme un système privilégié: segmenté, mis à jour, sauvegardé et surveillé. Les comptes doivent être restreints, alternés et audités. SSH remplace Telnet lorsque possible. Les anciens algorithmes sont isolés, et non autorisés sur un hôte de gestion universel. L'accès au dépôt suit le principe du moindre privilège.
Les modules constructeurs transforment une sortie instable en texte comparable
RANCID ne reçoit pas une configuration universelle abstraite. Il exécute les commandes de la plateforme spécifique, lit la sortie et applique des analyseurs et des filtres. Le module sait quoi demander, quelles lignes conserver, comment gérer les modes et comment ordonner le résultat.
Ce savoir est un actif opérationnel. Les plateformes nomment différemment les interfaces, l'inventaire, les logiciels et les tables de routage. Certaines affichent l'uptime, des horodatages et des compteurs. Le module transforme cette diversité en fichiers suffisamment stables pour un diff utile.
La traduction peut se rompre en silence. Une nouvelle version déplace une ligne, change un en-tête ou exige un privilège différent. L'analyseur continue de fonctionner mais perd une section. Le succès doit donc inclure des tests de contenu, et pas seulement le code de sortie.
La maintenance des modules exige un accès aux équipements, des exemples et une connaissance des versions. Les bifurcations locales règlent vite le problème mais compliquent les mises à jour. L'organisation doit connaître ses correctifs, les comparer à l'amont et tester le firmware avant la production.
La normalisation sépare le changement significatif du bruit de chaque exécution
La sortie CLI contient des valeurs qui changent sans modification de configuration: uptime, date, compteurs, identifiants de session, hachés chiffrés, ordre des lignes. Tout conserver produirait un diff à chaque exécution et noierait le signal.
RANCID supprime ou masque une partie de ces valeurs et stabilise l'ordre. Le dépôt montre les changements de politique, d'interface ou d'accès plutôt qu'un compteur actualisé. Grâce à cela, un diff simple reste utile pendant des années.
Mais la normalisation est une décision éditoriale dans le code. Un filtrage insuffisant crée des alertes permanentes; un filtrage excessif masque le matériel utile à l'incident ou à l'audit. Une valeur volatile peut devenir décisive lors d'une enquête sur un redémarrage ou une rotation de clés.
L'opérateur doit comprendre ce que le module filtre. Les changements de filtre doivent être traités comme des changements de schéma, car ils modifient la preuve enregistrée. Pour les équipements particulièrement critiques, on peut conserver séparément une sortie brute protégée et une version normalisée pour la comparaison.
Le contrôle de versions crée une chronologie du texte, pas un journal des transactions
CVS, Subversion ou Git conservent les versions, les diffs et les heures de commit. L'archive montre l'évolution du texte observable et permet de revenir à un ancien état. Export, réplication et relecture sont simples.
Un commit n'est pas une transaction sur le routeur. Son auteur est généralement un compte de service, non la personne ayant saisi la commande. L'heure est celle de la collecte ou du commit, pas nécessairement du changement. Plusieurs commandes se retrouveront dans un seul diff, les changements intermédiaires étant absents.
La chronologie doit donc être mise en regard avec AAA, syslog, tickets, pipelines et événements de l'équipement. Le dépôt offre un axe temporel indépendant mais incomplet. Sa force: le texte conservé; sa limite: l'absence d'intention et d'identité transactionnelle.
Git n'améliore pas automatiquement la preuve si l'historique peut être réécrit, les horloges sont erronées ou les commits ne sont pas répliqués. Rétention, protection de branches, signatures et copies immuables peuvent renforcer l'assurance.
La collecte périodique laisse une fenêtre où le changement décisif peut disparaître
RANCID observe des instantanés. Entre deux exécutions, une personne ou une automatisation peut modifier l'équipement, provoquer un incident puis effectuer un retour arrière. Le dépôt montrera deux états identiques et passera à côté de l'événement clé.
Réduire l'intervalle rétrécit la fenêtre, mais accroît les sessions, la charge, les commits et les chevauchements de tâches. Certains équipements supportent mal les requêtes CLI fréquentes. Les grands parcs exigent une planification et une limite de concurrence.
Une vision complète exige AAA, syslog, journaux d'orchestrateur, commits d'intention, télémétrie ou comptabilisation des commandes. RANCID reste utile comme vérification indépendante périodique.
La fraîcheur doit être visible. Pour chaque équipement, on définit un âge acceptable et une alarme en cas d'erreurs en série. Une copie vieille de six mois n'est pas fausse; elle témoigne d'un autre moment. L'interface ne doit pas la présenter comme l'état actuel.
L'hôte RANCID peut exposer tout le plan de gestion
Le collecteur rassemble identifiants, noms, adresses, descriptions, configurations et types d'équipements. Sa compromission donne à l'attaquant à la fois la carte et le moyen d'accès.
Le dépôt peut contenir des secrets même après filtrage: chaînes de communauté, hachés, clés, adresses de tunnels, données clients et politiques. Sauvegardes, miroirs Git et courriels de diff multiplient les copies. Chaque stockage devient une partie de la surface de contrôle.
La protection doit couvrir tout le chemin: hôte durci, segmentation de gestion, comptes en lecture seule, droits sur.cloginrc, sauvegardes chiffrées et restreintes, messagerie protégée, journalisation des accès et rotation. L'accès interactif doit être rare et attribuable.
Il faut disposer d'un plan en cas de compromission du collecteur. Une réinstallation ne suffit pas: il faut identifier et faire alterner tous les identifiants touchés, trouver les copies et enquêter sur les sessions. La centralisation améliore l'audit quotidien et accroît l'incident potentiel.
LibreNMS montre le symptôme, RANCID ajoute le contexte de configuration
LibreNMS peut signaler la chute d'un port, la perte d'un voisin ou la hausse d'erreurs. RANCID montre le changement de configuration associé. Ensemble, ils accélèrent le diagnostic, sans transformer corrélation en causalité.
Les outils ont des planifications différentes et peuvent manquer des événements. Une défaillance matérielle ne produit pas nécessairement de diff; un diff peut n'avoir aucun effet. Il faut synchroniser les horaires, vérifier la fraîcheur et ajouter journaux ou tickets.
L'intégration doit préserver la provenance. Un tableau de bord ne doit pas afficher un diff sans date ni statut de collecte. L'archive ne doit pas affirmer expliquer un symptôme qu'elle n'a pas mesuré. Ensemble, elles offrent une histoire plus complète: ce qui s'est passé et ce que l'équipement rapportait à ce moment-là.
GitOps et source de vérité décrivent l'intention; RANCID enregistre la réponse de l'équipement
Les systèmes modernes modélisent l'inventaire, les adresses, les services et les politiques dans des données faisant autorité, génèrent la configuration et appliquent les changements via relecture et tests.
RANCID, après ou en parallèle, lit ce que l'équipement expose réellement. Il confirme l'application de l'intention, révèle une dérive manuelle ou montre que l'OS du constructeur a normalisé la commande autrement.
Il est dangereux de faire automatiquement de la configuration collectée une nouvelle intention. La dérive observée peut être précisément une erreur. Un processus robuste compare l'intention et l'observation, explique l'écart et décide quel côté corriger.
L'indépendance du collecteur a une valeur de contrôle. Si l'orchestrateur, le dépôt d'intention et l'équipement partagent la même erreur, une lecture séparée peut révéler l'état. Mais l'indépendance doit être réelle: identifiants communs, analyseur ou administrateurs communs créent des modes de défaillance communs.
Oxidized et les gestionnaires commerciaux modernisent le workflow, sans supprimer le problème initial
Oxidized propose une architecture plus récente, des API et des intégrations. Les suites commerciales ajoutent support, conformité, orchestration et modèles de données. Elles peuvent simplifier le travail et fournir un contrat.
Aucune option ne supprime le besoin d'obtenir la preuve de ce que l'équipement rapporte. Elles répartissent simplement autrement l'effort entre code, licence, support et opérations. Une migration s'évalue par la couverture, les secrets, la fraîcheur, les filtres et la rétention, non par la seule modernité de l'interface.
RANCID peut continuer à servir le matériel historique pendant qu'un autre outil prend en charge les nouvelles plateformes. La coexistence temporaire est plus sûre qu'un basculement perdant des années d'historique. Il faut savoir quel outil est responsable de chaque équipement et comment réconcilier les différences.
Le diff par courriel fait du dépôt un workflow humain
Le courriel a longtemps été la couche de signalisation. Un changement génère un diff pour une liste ou une équipe, insérant la preuve dans un canal habituel et permettant une relecture partagée.
Le workflow peut devenir bruyant. Une mauvaise normalisation, un firmware verbeux ou des changements massifs créent un flux de courriels que l'on cesse de lire. Les listes peuvent inclure des personnes superflues, et un courriel laisse des copies sensibles hors du dépôt.
Il faut définir quelles groupes reçoivent quels équipements, comment les courriels sont classés, comment un changement attendu est relié à un ticket et quelle réponse exige un changement inattendu. Un diff non lu n'est pas un contrôle.
Ticketing, messagerie instantanée et pipelines peuvent remplacer ou compléter le courriel, mais la logique reste la même: un changement de texte devient une décision humaine. L'automatisation peut ajouter l'âge, la fenêtre de changement et la criticité, sans trancher seule la légitimité.
Le looking glass montre que même la lecture exige des limites
RANCID a historiquement été lié aux fonctions de looking glass exécutant des commandes diagnostiques restreintes. L'idée est utile: offrir de la visibilité sans accès CLI complet.
Mais « lecture seule » ne signifie pas « sans risque ». Les commandes révèlent la topologie, les routes, les politiques, les noms internes et les relations commerciales. Une entrée mal vérifiée peut permettre des commandes inattendues. Une requête lourde charge le routeur. Les résultats peuvent se diffuser trop largement.
L'interface doit restreindre strictement les commandes, les paramètres, les cibles et la fréquence, journaliser l'usage et, si possible, utiliser des identifiants distincts. L'information délivrée doit correspondre au public visé.
La leçon générale: le plan de gestion contient des données sensibles même sans droit de modification. L'observation exige un encadrement autant que l'écriture.
La pérennité repose sur un petit projet canonique et de nombreuses installations invisibles
À la date de référence, le site canonique de Shrubbery Networks continuait de désigner RANCID 3.14 comme version courante, la branche 3.14 étant datée de 2025. Des miroirs GitHub et des paquets de distributions existent, mais ne remplacent pas la source canonique du statut.
Il n'existe ni nombre d'installations audité, ni budget, ni liste complète des mainteneurs. Une grande partie de la valeur est invisible: anciennes installations internes, adaptations locales, paquets, utilisateurs qui ne participent pas publiquement.
Cette invisibilité complique l'estimation de l'influence et de la succession. Un logiciel mature peut fonctionner longtemps avec peu de changements, mais SSH, les OS et la sortie CLI évoluent. Le savoir critique peut être concentré chez quelques personnes.
Les utilisateurs devraient suivre les versions, l'activité du site, les correctifs de distribution, la réactivité aux signalements, l'état de leurs propres modules et leur capacité à migrer. Le calme n'équivaut pas à l'abandon, mais il ne doit pas être considéré comme une garantie sans vérification.
La migration doit préserver la preuve, et pas seulement remplacer le collecteur
Les dépôts peuvent contenir des années de configurations, de diffs, de commentaires et d'horodatages. Repartir de zéro interrompt la chronologie précisément au moment où elle est nécessaire, lors d'un incident.
La migration détermine le format de stockage, la recherche des anciens équipements, la correspondance des noms et des identités, la séparation des anciens et nouveaux commits. Les horodatages et branches doivent être vérifiés.
Une exécution parallèle sur un échantillon est utile. Les écarts révèlent les commandes manquantes, les filtres différents et les divergences d'analyseurs. Le succès, ce n'est pas seulement la connexion, mais la préservation d'un champ de preuve équivalent et la visibilité des erreurs.
Les identifiants doivent être alternés, non copiés aveuglément. Les anciens hôtes, sauvegardes, listes de diffusion et dépôts doivent être retirés de manière démontrable. Les secrets laissés en place accroissent le risque.
Le texte de configuration n'est pas le comportement du réseau
Un fichier peut sembler correct alors que le forwarding est défaillant. Une commande peut avoir été partiellement rejetée, réécrite, masquée par un état dynamique ou neutralisée par le matériel. RIB, FIB, sessions, files d'attente et état physique ne se réduisent pas au texte.
Certains modules collectent des sorties opérationnelles, mais l'objet principal reste un instantané textuel. Pour le comportement, il faut des tests d'accessibilité, de la télémétrie, l'état des protocoles et des sondes actives.
L'inverse est vrai aussi: le comportement semble normal, et une configuration dangereuse attend la prochaine défaillance. C'est pourquoi le diff compte: il montre un changement structurel avant ou après le symptôme.
Une interprétation correcte relie intention, configuration observée et exécution sans les mélanger. Chacune est une piste distincte. L'investigation explique les coïncidences et les ruptures.
La valeur d'audit dépend de la provenance, de la rétention et de l'explicabilité du collecteur
Pour que le dépôt soutienne un audit, il faut pouvoir expliquer comment les données ont été obtenues, par quel compte, avec quelles commandes, à quelle fréquence, avec quels filtres et quelles erreurs. Sans provenance, un ensemble de fichiers ne définit pas la couverture.
La rétention doit être définie. Les anciens équipements et configurations sont nécessaires aux enquêtes ou aux exigences, mais accroissent le risque de secrets et de données clients. Branches, sauvegardes et courriels doivent obéir à une politique cohérente.
Copies immuables, contrôle d'accès, journaux indépendants et hachés renforcent l'intégrité. Ils ne rendent pas l'archive infaillible, mais compliquent la modification silencieuse et clarifient la chaîne de conservation.
Le collecteur lui-même doit être documenté: version, modules locaux, changements de normalisation et santé. Sinon, les fichiers peuvent différer parce que l'analyseur a changé, non l'équipement. L'audit doit faire cette distinction.
Le matériel historique maintient le besoin d'une compatibilité étroite
Les réseaux conservent des équipements plus longtemps que ne vivent les cycles d'outils modernes. Certains n'ont ni gNMI, ni NETCONF fiable, ni API. Ils continuent de parler CLI, parfois avec de la cryptographie ancienne. Tant qu'ils transportent du trafic, leur état doit être préservé.
RANCID couvre ce créneau par des modules étroits. Cela ne justifie pas l'exploitation infinie d'un matériel vulnérable. Au contraire, l'outil doit faire apparaître la dette: Telnet, algorithmes faibles, comptes partagés, modules non maintenus.
L'isolation est essentielle. Les exigences d'un ancien équipement ne doivent pas affaiblir l'hôte de gestion commun. Collecteurs distincts, hôtes de rebond et segmentation limitent le risque jusqu'au remplacement.
La compatibilité étroite devient un mécanisme transitoire: elle préserve la preuve et l'opération pendant que la sortie est planifiée, et non un argument contre le renouvellement.
Dans de nombreux parcs, les nouveaux équipements offrent une télémétrie structurée, tandis que les anciens restent limités à la CLI et à SNMP. RANCID conserve les témoignages pour la seconde catégorie, sans transformer la compatibilité en affirmation de sécurité ou d'aptitude à long terme du matériel.
Un outil étroit peut traverser plusieurs vagues de gestion
RANCID a traversé les NMS, le SDN, la mise en réseau par intention, l'infrastructure as code et GitOps. Il a survécu non en promettant de les remplacer, mais en conservant une fonction restreinte: obtenir du texte et montrer le changement.
Une fonction étroite est facile à expliquer, vérifier et migrer. Elle réduit la dépendance aux modèles propriétaires. Le texte et le diff se lisent avec des outils ordinaires, abaissant le coût de la continuité.
La simplicité devient une faiblesse si les nouvelles plateformes, la sécurité ou la succession ne sont pas entretenues. La longévité passée ne garantit pas l'avenir. Chaque organisation vérifie sa propre couverture et son plan de sortie.
La leçon n'est pas que le simple est toujours meilleur, mais que la fonction essentielle doit rester exportable et compréhensible lors du changement de grande plateforme.
Le diff textuel compte parce qu'il s'agit d'une preuve restreinte et vérifiable
Le principal mérite de RANCID est de ne pas exiger de croire un modèle opaque. Le fichier montre le texte obtenu; le diff, les lignes ajoutées, supprimées et modifiées; l'historique, les observations successives. Un ingénieur peut tout vérifier avec des outils ordinaires.
La lisibilité réduit la distance entre la collecte et le jugement. On peut contester un filtre, repérer une anomalie, restaurer une ancienne configuration. Le format est portable d'un produit à l'autre. Même la disparition de RANCID ne détruirait pas le dépôt.
La preuve est limitée: un ensemble de commandes, un moment, un analyseur et un accès. Elle ne montre pas tout. Une limite explicite vaut mieux qu'un tableau de bord mélangeant observation, calcul et conclusion sans provenance claire.
La valeur stratégique apparaît dans l'indépendance vis-à-vis de l'intention. Une organisation peut disposer d'un pipeline moderne et conserver RANCID comme témoin. Un changement manuel, une défaillance d'orchestrateur ou une différence constructeur obtient un point de comparaison.
Le coût est réel: identifiants, modules, stockage, traitement des erreurs et exposition des secrets. La question n'est pas le caractère vieillot du diff, mais si la valeur d'investigation dépasse le coût et si les contrôles correspondent au risque.
Le test final est simple. Après le prochain incident, l'équipe pourra-t-elle nommer le dernier changement observable, l'heure de la dernière collecte réussie, expliquer les lacunes du module et relier le diff à l'intention et aux événements? Si oui, l'outil de l'ère CLI demeure une infrastructure de connaissance utile.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance