
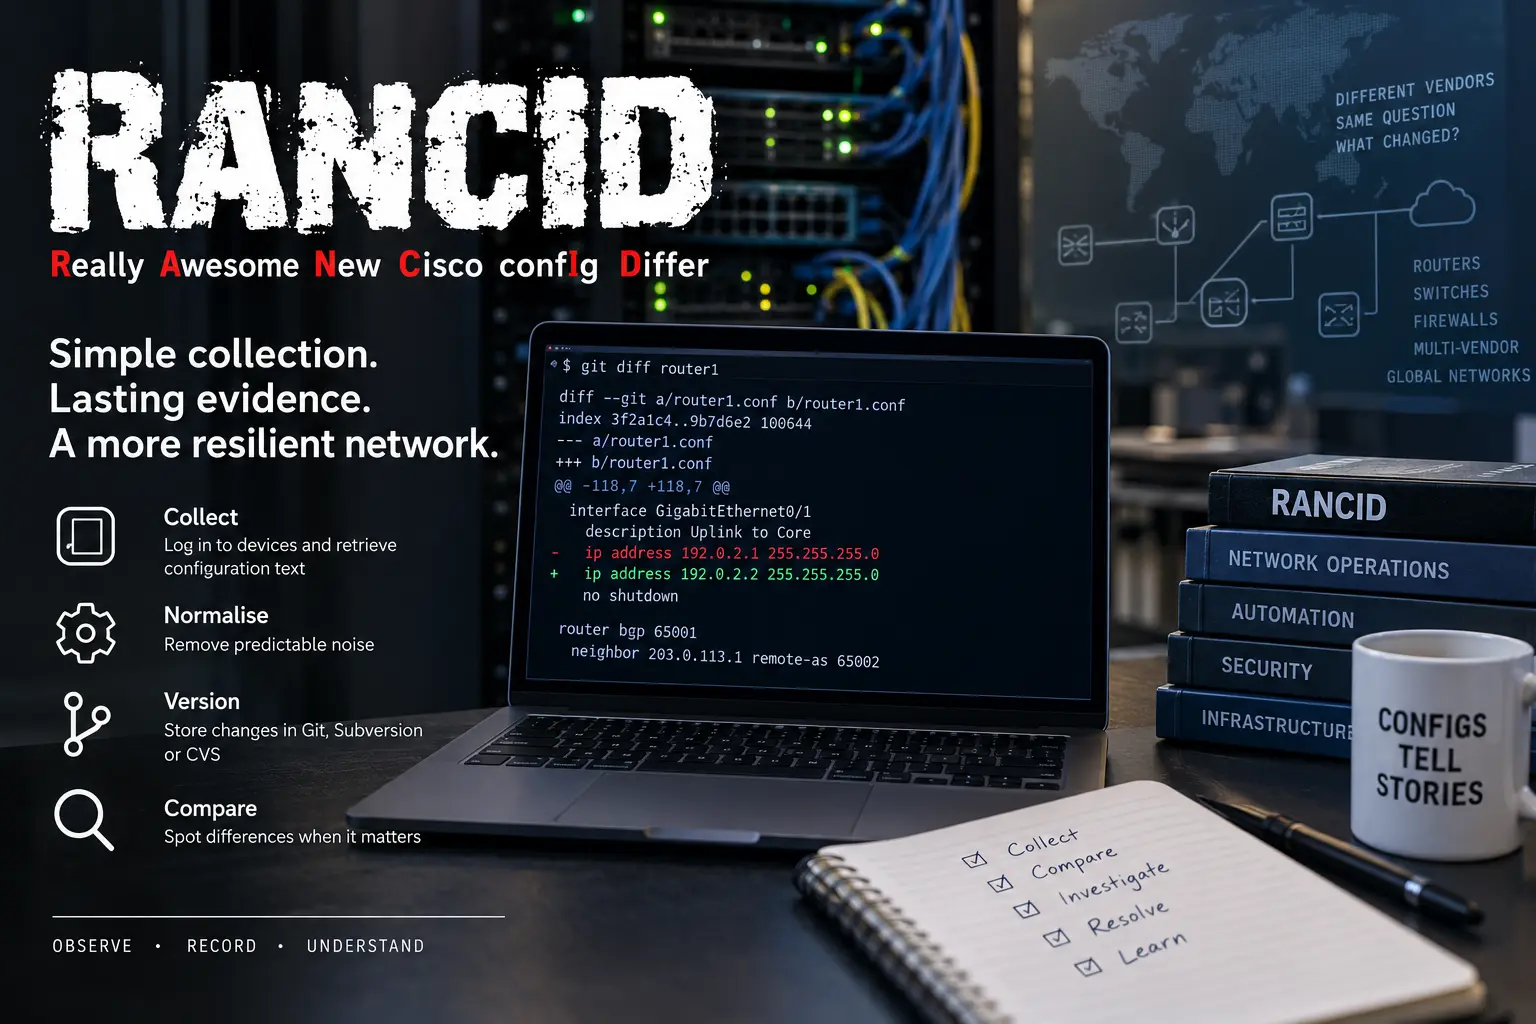
En resumen
- RANCID — Really Awesome New Cisco confIg Differ — recopila periódicamente configuraciones mediante scripts de acceso y módulos específicos de cada fabricante, normaliza la salida y guarda los cambios en CVS, Subversion o Git.
- Su material es texto observado, no un estado deseado: una instantánea puede mostrar una desviación o un cambio de emergencia, pero omitir acciones intermedias, el estado de ejecución y la identidad del autor.
- El servidor que mejora la investigación de incidentes se convierte en un objetivo de alto valor porque concentra credenciales de gestión, topología y secretos de configuración de todo el parque.
- RANCID sigue siendo útil junto a GitOps, la automatización y los sistemas de fuente de verdad, porque un recolector independiente puede mostrar lo que el dispositivo comunicó realmente después de que se eludiera o solo se ejecutara parcialmente el proceso habitual.
Después de una avería, la pregunta útil más pequeña suele ser «¿qué cambió?»
Una red puede fallar por una interacción compleja entre la política de enrutamiento, el estado de las interfaces, los errores de software y la carga. Pero la primera pista práctica sigue siendo una sola línea: cambió la dirección de un vecino, se movió una ACL, se añadió un match a un route-map, un enlace troncal perdió una VLAN. El dispositivo aceptó una orden y las consecuencias aparecieron después y, quizá, lejos del punto del cambio.
RANCID se creó para conservar esa pista. Se conecta a routers, conmutadores y otros dispositivos compatibles, ejecuta órdenes, filtra la salida y consigna el texto resultante en un sistema de control de versiones. Cuando cambia un archivo, el repositorio muestra el diff y puede enviar un correo o activar otro flujo de trabajo. El sistema no necesita comprender todo el objetivo empresarial para registrar que el dispositivo ahora comunica un texto distinto.
La modestia del modelo es una virtud. RANCID no afirma ser un plano de control completo. No planifica una ventana de cambios, no genera todas las configuraciones ni garantiza el cumplimiento. Realiza observaciones periódicas. Por eso resulta útil en un parque mixto, donde algunos dispositivos están automatizados, otros se gestionan manualmente y otros son demasiado antiguos para una API moderna.
El modelo es incompleto por diseño. Un cambio puede aplicarse y revertirse entre dos recopilaciones. Un fallo de acceso puede hacer que un archivo antiguo parezca actualizado. Un módulo del fabricante puede no solicitar la orden decisiva. La normalización puede eliminar un valor que después resulte importante. El diff solo demuestra la diferencia entre los textos vistos por el recolector; no demuestra quién modificó el dispositivo, por qué lo hizo ni si eso provocó la avería.
Estos límites no reducen el valor de la evidencia, sino que lo definen con precisión. RANCID ofrece una respuesta duradera y de baja complejidad a una pregunta acotada. Durante un incidente, a veces resulta más útil que un amplio panel de síntomas sin contexto de configuración.
El proyecto dio memoria externa a los routers antes de que los controladores se pusieran de moda
RANCID surgió cuando los equipos de red se gestionaban principalmente mediante CLI. La configuración residía en routers y conmutadores, mientras que el conocimiento operativo estaba en la memoria de los ingenieros, el historial de terminal y los directorios personales. La sustitución de un dispositivo o una orden errónea podían revelar que la organización carecía de una copia independiente y actualizada.
El nombre nació ligado a Cisco, pero la cobertura se amplió mediante módulos de fabricantes. La arquitectura aceptó un hecho incómodo: los indicadores, las secuencias de acceso, la paginación y las órdenes varían. En lugar de esperar un modelo unificado, RANCID automatizó las interfaces reales.
clogin, que funciona mediante Expect, puede reconocer indicadores, conducir la sesión, pasar al modo privilegiado y ejecutar órdenes. El módulo obtiene la configuración activa, el inventario u otro estado; después, la salida se normaliza y se guarda como texto.
El enfoque es tan frágil como cualquier automatización de CLI. Un indicador nuevo rompe el script. El firmware cambia la salida. Los mensajes de bienvenida, la paginación, la autenticación y los tiempos varían. Algunos dispositivos requieren Telnet o conjuntos de cifrado antiguos. Los módulos locales pueden divergir del proyecto original.
Su longevidad demuestra que la compatibilidad suele surgir de la adaptación, no de un estándar perfecto. RANCID no uniformiza las CLI; crea un proceso común por encima de sus diferencias. El repositorio se convierte en una interfaz estable. Lo esencial es que la memoria abandona el dispositivo: incluso si un router queda totalmente destruido, permanecen la última configuración y su historial.
router.dbconvierte el parque en un plan de recopilación programado
El proceso tradicional comienza conrouter.db, que relaciona nombres de host, tipos y estados. Las entradas activas se convierten en objetivos. Los grupos definen calendarios, repositorios y ámbitos de responsabilidad. El archivo es fácil de revisar y someter a control de versiones, pero determina qué dispositivos serán recordados y cuáles seguirán siendo invisibles.
La sencillez hace legibles los errores: una errata en el nombre, un tipo incorrecto o un estado deshabilitado. Pero no garantiza la integridad. Un router ausente no se descubre automáticamente. Un dispositivo retirado puede permanecer. Un nombre puede resolverse a una dirección inesperada. La lista debe contrastarse con un registro de activos o una fuente de verdad.
Cuando se ejecutarancid-run, selecciona los objetivos activos, invoca la lógica de acceso y la específica del fabricante, obtiene la salida, la compara y registra los cambios significativos. Los errores y reintentos forman parte del servicio. Un dispositivo puede no estar disponible, la autenticación puede fallar o una orden puede devolver datos incompletos. Cada ejecución debe tener un estado; la existencia de un archivo no demuestra que esté actualizado.
Una copia antigua puede parecer limpia y convincente. El operador necesita conocer la hora de la última recopilación correcta, el número de errores consecutivos y la confirmación de que se ejecutaron todas las órdenes esperadas. Un archivo sin supervisión de vigencia crea una falsa sensación de seguridad.
Los grupos permiten limitar el radio de impacto. Distintos entornos usan credenciales, frecuencias y repositorios diferentes; los dispositivos críticos pueden recopilarse con mayor frecuencia o desde servidores aislados. Perorouter.dbno es una fuente de intención, sino un plan de recopilación. Compararlo con NetBox, Nautobot o un registro de activos permite detectar dispositivos sin historial y equipos olvidados.
El acceso mediante Expect hizo posible la automatización y concentró los secretos
Las CLI interactivas se diseñaron para personas. Muestran mensajes de bienvenida, piden un nombre y una contraseña, negocian los parámetros del terminal, pausan la salida y cambian el indicador según el modo. Expect espera un patrón y responde, convirtiendo la conversación en una secuencia automatizada.
RANCID utiliza este modelo. Sus herramientas abren Telnet o SSH, procesan indicadores, entran en modo privilegiado y ejecutan órdenes. Así se automatizaron los equipos mucho antes de las API basadas en modelos.
El mecanismo crea una grave concentración de riesgo. El recolector puede necesitar acceso a cientos o miles de dispositivos. Las credenciales suelen describirse en.cloginrcy protegerse con permisos del sistema de archivos. Comprometer el servidor o el archivo proporciona al atacante un mapa del parque y datos para acceder al plano de gestión. Las cuentas compartidas y privilegiadas amplían las consecuencias.
Incluso «solo lectura» depende de la plataforma. Algunos dispositivos separan mal la visualización de la configuración de órdenes más amplias. El repositorio puede contener cadenas de comunidad, hashes, claves, nombres de clientes y direcciones internas. El filtrado ayuda, pero no garantiza la ausencia de secretos.
El servidor de RANCID debe considerarse un sistema privilegiado: hay que segmentarlo, actualizarlo, respaldarlo y supervisarlo. Las cuentas deben limitarse, rotarse y auditarse. SSH sustituye a Telnet cuando es posible. Los algoritmos antiguos se aíslan, en lugar de habilitarlos en un servidor de gestión de uso general. El acceso al repositorio se organiza según el principio de mínimo privilegio.
Los módulos de fabricante convierten una salida inestable en texto comparable
RANCID no recibe una configuración universal y abstracta. Ejecuta órdenes propias de una plataforma, lee la salida y aplica un analizador y filtros. El módulo sabe qué solicitar, qué líneas conservar, cómo tratar los modos y cómo ordenar el resultado.
Ese conocimiento es un activo operativo. Las plataformas dan nombres distintos a las interfaces, el inventario, el software y las tablas de rutas. Algunas imprimen el tiempo de actividad, marcas de tiempo y contadores. El módulo convierte esa diversidad en archivos lo bastante estables para que el diff sea útil.
La conversión puede romperse en silencio. Una versión nueva desplaza una línea, cambia un encabezado o exige otro nivel de privilegio. El analizador sigue funcionando, pero pierde una sección. Por eso, el éxito debe incluir pruebas de contenido, no solo un código de salida.
El mantenimiento de los módulos requiere acceso a los equipos, ejemplos y conocimiento de las versiones. Las bifurcaciones locales resuelven un problema con rapidez y complican las actualizaciones. La organización debe conocer sus parches, compararlos con el proyecto original y probar el firmware antes de llevarlo a producción.
La normalización separa los cambios significativos del ruido de cada ejecución
La salida de CLI contiene valores que cambian sin que cambie la configuración: tiempo de actividad, fecha, contadores, identificadores de sesión, hashes cifrados y orden de las líneas. Si se guarda todo, cada ejecución genera un diff y la señal se pierde entre el ruido.
RANCID elimina o enmascara parte de esos valores y estabiliza el orden. El repositorio muestra cambios de política, interfaz o acceso en lugar de un contador actualizado. Gracias a ello, un diff sencillo sigue siendo útil durante años.
Pero la normalización es una decisión editorial plasmada en código. Un filtrado insuficiente genera alertas constantes; uno excesivo oculta material útil para un incidente o una auditoría. Un valor volátil puede resultar importante al investigar un reinicio o una rotación de claves.
El operador debe entender qué filtra el módulo. Los cambios en el filtro deben tratarse como cambios en la estructura de la evidencia, porque modifican la pista que se conserva. Para los dispositivos especialmente críticos, puede guardarse por separado una salida sin procesar y protegida, junto con la versión normalizada destinada a la comparación.
El control de versiones crea una cronología del texto, no un registro de transacciones
CVS, Subversion o Git conservan versiones, diffs y horas de confirmación. El archivo muestra la evolución del texto observado y permite volver a un estado anterior. La exportación, la replicación y la revisión son sencillas.
Una confirmación no es una transacción en el router. Su autor suele ser una cuenta de servicio, no la persona que introdujo la orden. La hora corresponde al momento de la recopilación o de la confirmación, no necesariamente al del cambio. Varias órdenes pueden aparecer en un solo diff y los cambios intermedios no figuran.
Por eso, la cronología debe cotejarse con AAA, syslog, tickets, la cadena de automatización y los eventos del dispositivo. El repositorio ofrece un eje temporal independiente, pero incompleto. Su fortaleza es el texto conservado; su límite, la ausencia de intención y de identidad transaccional.
Git no mejora automáticamente la evidencia si el historial puede reescribirse, los relojes son incorrectos o los cambios confirmados no se replican. La política de conservación, la protección de ramas, las firmas y las copias inmutables pueden aumentar la confianza.
La recopilación periódica deja una ventana en la que un cambio decisivo puede desaparecer
RANCID observa instantáneas. Entre dos ejecuciones, una persona o una automatización pueden modificar el dispositivo, provocar un incidente y revertir el cambio. El repositorio mostrará dos estados idénticos y omitirá el acontecimiento clave.
Reducir el intervalo acorta la ventana, pero aumenta las sesiones, la carga, las confirmaciones y el solapamiento de tareas. Algunos dispositivos toleran mal las consultas frecuentes por CLI. Los parques grandes necesitan una planificación y límites de concurrencia.
Para obtener una imagen completa hacen falta AAA, syslog, registros del orquestador, registros de cambios de intención, telemetría o registro de comandos. RANCID sigue siendo útil como comprobación periódica e independiente.
La vigencia debe ser visible. Para cada dispositivo se establece una antigüedad aceptable y una alarma ante errores sucesivos. Una copia de hace seis meses no es falsa; es evidencia de otro momento. La interfaz no debe presentarla como estado actual.
El servidor de RANCID puede revelar todo el plano de gestión
El recolector reúne credenciales, nombres, direcciones, descripciones, configuraciones y tipos de dispositivos. Si se ve comprometido, el atacante obtiene tanto el mapa como el medio de acceso.
El repositorio puede contener secretos incluso después del filtrado: comunidades, hashes, claves, direcciones de túneles, datos de clientes y políticas. Las copias de seguridad, las réplicas de Git y los correos con diffs multiplican las copias. Cada almacén pasa a formar parte de la superficie de control.
La protección debe abarcar todo el recorrido: un servidor reforzado, segmentación de la red de gestión, cuentas de solo lectura, permisos de.cloginrc, copias de seguridad cifradas y restringidas, correo protegido, registro de accesos y rotación. El acceso interactivo debe ser excepcional y atribuible.
Debe existir un plan para el compromiso del recolector. Reinstalarlo no basta: hay que identificar y rotar todas las credenciales afectadas, localizar las copias e investigar las sesiones. La centralización mejora la auditoría cotidiana y aumenta el impacto potencial de un incidente.
LibreNMS muestra el síntoma; RANCID añade el contexto de configuración
LibreNMS puede avisar de la caída de un puerto, la pérdida de un vecino o el aumento de los errores. RANCID muestra un cambio en la configuración relacionada. Juntos aceleran el diagnóstico sin convertir la correlación en causalidad.
Las herramientas siguen calendarios distintos y pueden omitir acontecimientos. Un fallo de hardware no tiene por qué producir un diff; un diff puede no tener efecto. Hay que alinear los tiempos, comprobar la vigencia y añadir registros o tickets.
La integración debe preservar la procedencia. Un panel no debe mostrar un diff sin la fecha y el estado de la recopilación. El archivo no debe afirmar que explica un síntoma que no midió. Juntos ofrecen una historia más completa: qué ocurrió y qué comunicaba el dispositivo en torno a ese momento.
GitOps y las fuentes de verdad describen la intención; RANCID registra la respuesta del dispositivo
Los sistemas modernos modelan el inventario, las direcciones, los servicios y las políticas en datos autoritativos, generan la configuración y aplican los cambios mediante revisión y pruebas.
Después, o en paralelo, RANCID lee lo que el dispositivo expone realmente. Confirma la aplicación de la intención, detecta desviaciones manuales o muestra que el sistema operativo del fabricante normalizó una orden de otra manera.
Es peligroso convertir automáticamente la configuración recopilada en la nueva intención. La desviación observada puede ser precisamente el error. Un proceso sólido compara la intención y la observación, explica la diferencia y decide qué lado debe corregirse.
La independencia del recolector tiene valor de control. Si el orquestador, el repositorio de intención y el dispositivo comparten un mismo error, una lectura separada puede mostrar el estado. Pero la independencia debe ser real: las credenciales, el analizador o los administradores compartidos crean modos de fallo comunes.
Oxidized y los gestores comerciales modernizan el flujo de trabajo, pero no eliminan la tarea original
Oxidized ofrece una arquitectura más reciente, una API e integraciones. Las plataformas comerciales añaden soporte, cumplimiento, orquestación y modelos de datos. Pueden simplificar el trabajo y aportar un contrato.
Ninguna opción elimina la necesidad de obtener evidencia de lo que comunica el dispositivo. Solo distribuyen de otra manera el esfuerzo entre código, licencias, soporte y operaciones. La migración se evalúa por la cobertura, los secretos, la vigencia, los filtros y la conservación, no solo por la modernidad de la interfaz.
RANCID puede seguir atendiendo equipos heredados mientras otra herramienta asume las plataformas nuevas. Una convivencia temporal es más segura que un cambio definitivo que pierda años de historial. Hay que saber qué herramienta responde de cada dispositivo y cómo se concilian las diferencias.
El diff por correo electrónico convierte el repositorio en un flujo de trabajo humano
El correo fue durante mucho tiempo la capa de señalización. Un cambio genera un diff para una lista o un equipo, introduce la evidencia en un canal habitual y permite una revisión compartida.
El flujo de trabajo puede volverse ruidoso. Una mala normalización, un firmware muy verboso o cambios masivos crean una avalancha de mensajes que se deja de leer. Las listas pueden incluir a personas innecesarias y el correo deja copias sensibles fuera del repositorio.
Conviene definir qué grupos reciben información de qué dispositivos, cómo se clasifican los mensajes, cómo se vincula un cambio esperado con un ticket y qué respuesta exige uno inesperado. Un diff sin leer no constituye un control.
Los sistemas de tickets, la mensajería y los flujos automatizados pueden sustituir o complementar el correo, pero la lógica es la misma: un cambio de texto se convierte en una decisión humana. La automatización puede añadir antigüedad, ventana de cambios y criticidad, pero no resolver por sí sola la legitimidad.
Looking glass demuestra que incluso la lectura necesita límites
RANCID se ha asociado históricamente con funciones de looking glass que ejecutaban órdenes de diagnóstico limitadas. La idea es útil: ofrecer visibilidad sin conceder acceso completo a la CLI.
Pero «solo lectura» no significa «sin riesgo». Las órdenes revelan topología, rutas, políticas, nombres internos y relaciones comerciales. Una entrada mal validada puede permitir órdenes imprevistas. Una consulta pesada carga el router. Los resultados pueden difundirse demasiado.
La interfaz debe limitar estrictamente las órdenes, los parámetros, los objetivos y la frecuencia, registrar el uso y, cuando sea posible, emplear credenciales separadas. La información entregada debe adecuarse al público.
La lección general es que el plano de gestión contiene datos sensibles incluso sin permiso de modificación. La observación exige tanta gobernanza como la escritura.
La resiliencia se apoya en un pequeño proyecto canónico y muchas instalaciones invisibles
En la fecha de corte, el sitio canónico de Shrubbery Networks seguía señalando RANCID 3.14 como versión vigente, y la rama 3.14 estaba fechada en 2025. Existen réplicas en GitHub y paquetes de distribuciones, pero no sustituyen a la fuente canónica sobre el estado del proyecto.
No existe un recuento auditado de instalaciones, un presupuesto ni una lista completa de responsables de mantenimiento. Gran parte del valor es invisible: instalaciones internas antiguas, adaptaciones locales y paquetes cuyos usuarios no participan públicamente.
Esa invisibilidad dificulta evaluar la influencia y el relevo. Un software maduro puede funcionar durante mucho tiempo con pocos cambios, pero SSH, los sistemas operativos y la salida de CLI evolucionan. El conocimiento crítico puede concentrarse en unas pocas personas.
Los usuarios deben seguir las versiones, la actividad del sitio, los parches de las distribuciones, la respuesta a los informes, el estado de sus propios módulos y su capacidad de migración. La calma no equivale a abandono, pero tampoco debe considerarse una garantía sin verificación.
La migración debe conservar la evidencia, no limitarse a sustituir el recolector
Los repositorios pueden contener años de configuraciones, diffs, comentarios y marcas de tiempo. Empezar desde cero corta la cronología precisamente cuando puede ser necesaria durante un incidente.
La migración debe definir el formato de almacenamiento, la búsqueda de dispositivos antiguos, la correspondencia de nombres e identidades y la separación entre confirmaciones antiguas y nuevas. Deben verificarse las horas y las ramas.
Resulta útil ejecutar ambos sistemas en paralelo sobre una muestra. Las diferencias revelan órdenes ausentes, filtros distintos y divergencias entre analizadores. El éxito no consiste solo en conectarse, sino en conservar un campo de evidencia equivalente y hacer visibles los errores.
Las credenciales deben rotarse, no copiarse a ciegas. Los servidores antiguos, las copias de seguridad, las listas de correo y los repositorios deben retirarse de forma demostrable. Los secretos abandonados aumentan el riesgo.
El texto de configuración no equivale al comportamiento de la red
Un archivo puede parecer correcto mientras el reenvío falla. Una orden pudo rechazarse parcialmente, reescribirse, quedar anulada por un estado dinámico o ser neutralizada por el hardware. La RIB, la FIB, las sesiones, las colas y el estado físico no se reducen a texto.
Algunos módulos recopilan salida operativa, pero el foco principal es una instantánea de texto. Para conocer el comportamiento hacen falta pruebas de alcanzabilidad, telemetría, estado de los protocolos y sondas activas.
También ocurre lo contrario: el comportamiento parece normal, pero una configuración peligrosa espera al próximo fallo. Por eso importa el diff: muestra un cambio estructural antes o después del síntoma.
La interpretación correcta relaciona la intención, la configuración observada y el estado de ejecución sin confundirlos. Cada elemento es una evidencia distinta. La investigación explica las coincidencias y las brechas.
El valor para la auditoría depende de la procedencia, la conservación y la explicabilidad del recolector
Para que un repositorio sustente una auditoría, debe poder explicarse cómo se obtuvieron los datos, con qué cuenta, mediante qué órdenes, con qué frecuencia, filtros y errores. Sin procedencia, un conjunto de archivos no define su cobertura.
La conservación debe estar definida. Los dispositivos y configuraciones antiguos pueden ser necesarios para investigaciones o requisitos, pero aumentan el riesgo asociado a secretos y datos de clientes. Las ramas, las copias de seguridad y el correo deben someterse a una política coherente.
Las copias inmutables, el control de acceso, los registros independientes y los hashes refuerzan la integridad. No convierten el archivo en algo infalible, pero dificultan las modificaciones no detectadas y aclaran la cadena de custodia.
El recolector también debe documentarse: versión, módulos locales, cambios de normalización y estado de salud. De lo contrario, los archivos pueden diferir porque cambió el analizador y no el dispositivo. La auditoría debe distinguirlo.
Los equipos heredados mantienen la necesidad de una compatibilidad específica
Los equipos de red permanecen en servicio más tiempo que los ciclos de las herramientas modernas. Algunos no disponen de gNMI, un NETCONF fiable ni una API. Siguen comunicándose mediante CLI y, a veces, con criptografía antigua. Mientras transporten tráfico, es necesario conservar su estado.
RANCID cubre ese nicho con módulos específicos. Eso no justifica explotar indefinidamente hardware vulnerable. Al contrario, la herramienta debe hacer visible la deuda: Telnet, algoritmos débiles, cuentas compartidas y módulos sin mantenimiento.
El aislamiento es crítico. Los requisitos de un dispositivo antiguo no deben debilitar el servidor general de gestión. Recolectores separados, servidores de salto y segmentación limitan el riesgo hasta la sustitución.
La compatibilidad específica se convierte en un mecanismo de transición: conserva la evidencia y la operación mientras se planifica la retirada, no en un argumento contra la renovación.
En muchos parques, los dispositivos nuevos ofrecen telemetría estructurada, mientras que los antiguos siguen limitados a CLI y SNMP. RANCID conserva evidencia para el segundo grupo sin convertir la compatibilidad en una afirmación sobre la seguridad o la idoneidad a largo plazo de los equipos.
Una herramienta acotada puede sobrevivir a varias oleadas de gestión
RANCID ha atravesado NMS, SDN, redes basadas en la intención, infraestructura como código y GitOps. Sobrevivió no por prometer sustituirlos, sino por conservar una función acotada: obtener texto y mostrar el cambio.
Una función acotada es fácil de explicar, comprobar y migrar. Reduce la dependencia de modelos propietarios. El texto y el diff pueden leerse con herramientas comunes, lo que reduce el coste de la continuidad.
La sencillez se convierte en una debilidad si no se mantienen las plataformas nuevas, la seguridad o el relevo. La longevidad pasada no garantiza el futuro. Cada organización debe comprobar su propia cobertura y su plan de salida.
La lección no es que lo sencillo siempre sea mejor, sino que una función esencial debe seguir siendo exportable y comprensible cuando cambia la plataforma principal.
El diff textual importa porque es una evidencia acotada y verificable
La principal virtud de RANCID es que no obliga a confiar en un modelo opaco. El archivo muestra el texto obtenido; el diff, las líneas añadidas, eliminadas y modificadas; el historial, las observaciones sucesivas. Un ingeniero puede comprobarlo todo con herramientas comunes.
La legibilidad acorta la distancia entre la recopilación y el juicio. Un filtro puede cuestionarse, una anomalía puede verse y una configuración antigua puede recuperarse. El formato puede trasladarse fuera del producto. Incluso la desaparición de RANCID no destruiría el repositorio.
La evidencia es limitada: depende del conjunto de órdenes, el momento, el analizador y el acceso. No lo muestra todo. Un límite explícito es más sano que un panel que mezcla observación, cálculo y conclusión sin una procedencia clara.
El valor estratégico aparece cuando existe independencia respecto de la intención. Una organización puede contar con una cadena de automatización moderna y conservar RANCID como testigo. Un cambio manual, un fallo del orquestador o una diferencia del fabricante obtienen así un punto de comparación.
El coste es real: credenciales, módulos, almacenamiento, gestión de errores y exposición de secretos. La cuestión no es si el diff está pasado de moda, sino si su valor para la investigación supera el coste y si los controles se ajustan al riesgo.
La prueba final es sencilla. Tras el próximo incidente, ¿podrá el equipo identificar el último cambio observado y la hora de la recopilación correcta, explicar las omisiones del módulo y relacionar el diff con la intención y los acontecimientos? Si es así, una herramienta de la era de la CLI sigue siendo una infraestructura útil de conocimiento.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance