
Кратко
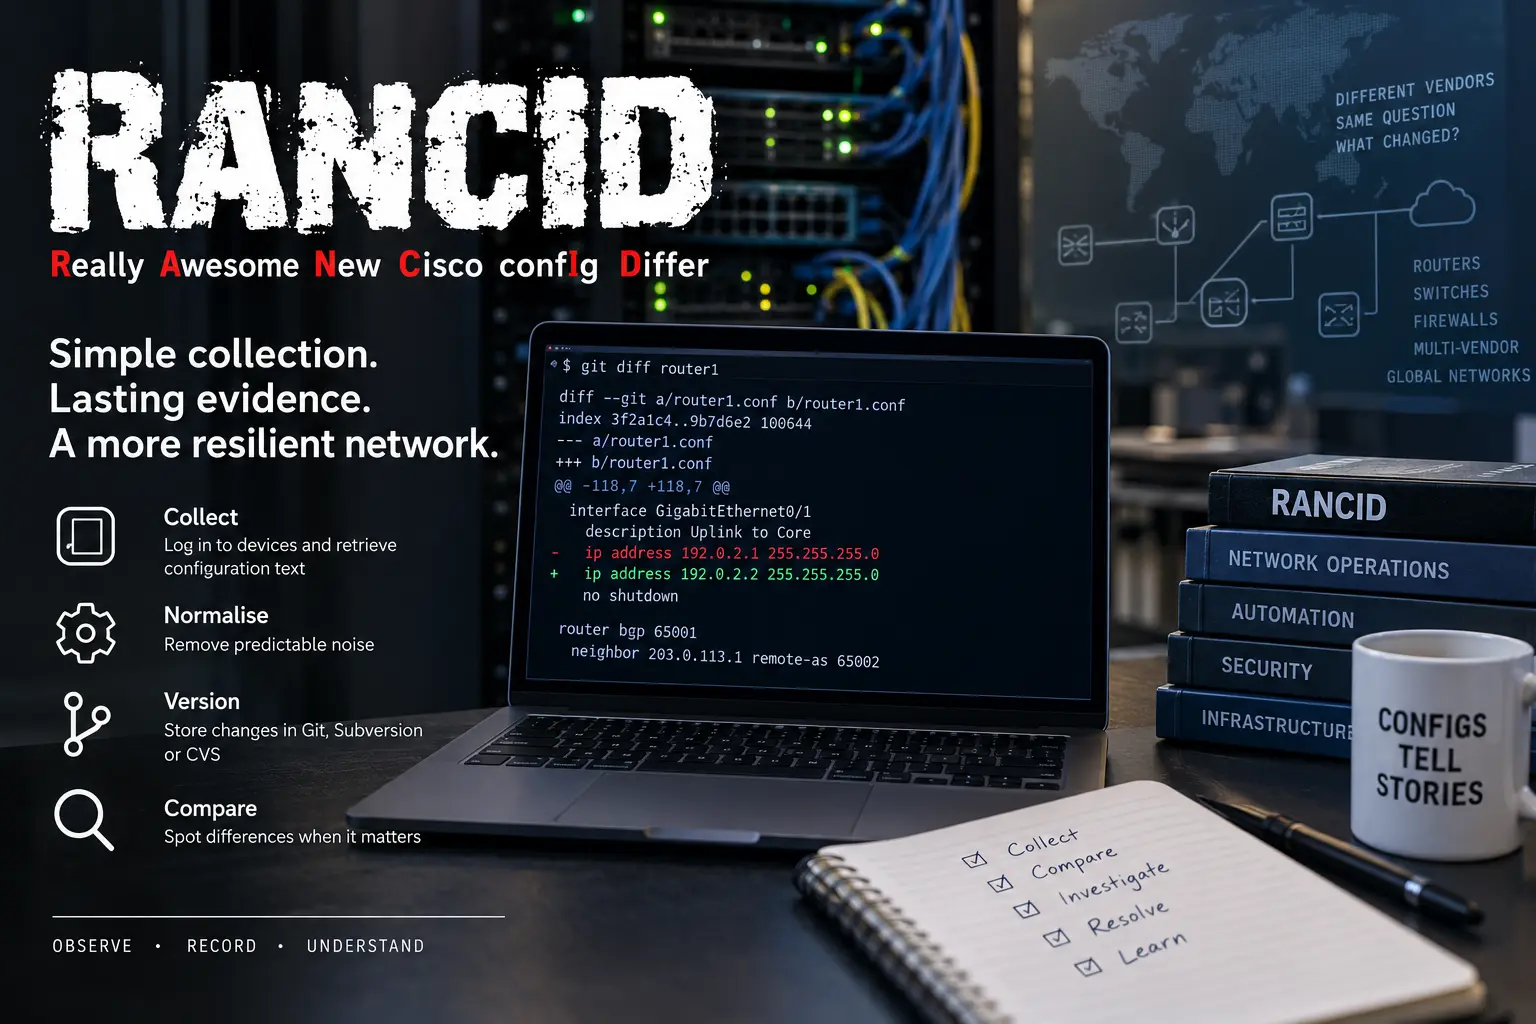
- RANCID — Really Awesome New Cisco confIg Differ — регулярно собирает конфигурации через vendor-ориентированные login-скрипты и модули, нормализует вывод и сохраняет изменения в CVS, Subversion или Git.
- Его материал — наблюдаемый текст, а не желаемое состояние: snapshot может показать drift или срочное изменение, но пропустить промежуточные действия, runtime-state и личность автора.
- Хост, который улучшает расследование инцидентов, становится высокоценной целью, потому что концентрирует management-учётные данные, топологию и секреты конфигурации всей флоты.
- RANCID остаётся полезен рядом с GitOps, автоматизацией и source-of-truth-системами, поскольку независимый collector может показать, что устройство реально сообщило после обхода или частичного выполнения штатного процесса.
После аварии самым маленьким полезным вопросом часто бывает «что изменилось?»
Сеть может отказать из-за сложного взаимодействия маршрутной политики, состояния интерфейсов, ошибок программного обеспечения и нагрузки. Но первой практической уликой остаётся одна строка: изменился адрес соседа, была переставлена ACL, в route-map добавили match, trunk потерял VLAN. Устройство приняло команду, а последствия появились позже и, возможно, далеко от точки изменения.
RANCID создан для сохранения такой улики. Он подключается к маршрутизаторам, коммутаторам и другим поддерживаемым устройствам, выполняет команды, фильтрует вывод и commits полученный текст в систему версий. При изменении файла репозиторий показывает diff и может отправить письмо или запустить другой workflow. Системе не требуется понимать всю деловую цель, чтобы зафиксировать: устройство теперь сообщает другой текст.
Скромность модели — достоинство. RANCID не заявляет, что является полным control plane. Он не планирует окно, не генерирует все конфигурации и не гарантирует compliance. Он делает периодические наблюдения. Поэтому полезен в смешанном парке, где одни устройства автоматизированы, другие управляются вручную, а третьи слишком стары для современного API.
Модель неполна по замыслу. Изменение может быть применено и отменено между двумя сборками. Ошибка login оставит старый файл выглядеть свежим. Vendor-модуль может не запросить решающую команду. Нормализация может убрать значение, которое позже окажется важным. Diff доказывает только разницу текста, увиденную collector; он не доказывает, кто и зачем менял устройство и вызвало ли это аварию.
Эти границы не уменьшают ценность доказательства, а точно определяют её. RANCID даёт долговечный, малосложный ответ на один ограниченный вопрос. Во время инцидента это иногда полезнее широкого dashboard симптомов без конфигурационного контекста.
Проект дал маршрутизаторам внешнюю память до того, как контроллеры стали модой
RANCID возник во времена, когда сетевое оборудование управлялось главным образом через CLI. Конфигурация жила на маршрутизаторах и коммутаторах, а операционное знание — в памяти инженеров, истории терминалов и личных каталогах. Замена устройства или ошибочная команда могли показать, что организация не имеет независимой актуальной копии.
Название начиналось с Cisco, но охват расширился через vendor-модули. Архитектура приняла неудобный факт: prompts, последовательности входа, paging и команды различаются. Вместо ожидания единой модели RANCID автоматизировал реальные интерфейсы.
clogin, работающий через Expect, может узнавать приглашения, вести сессию, переходить в привилегированный режим и выполнять команды. Модуль получает running configuration, инвентарь или другое состояние; затем вывод нормализуется и сохраняется как текст.
Подход хрупок так же, как любая CLI-автоматизация. Новый prompt ломает script. Firmware меняет вывод. Banner, paging, аутентификация и timing различаются. Некоторые устройства требуют Telnet или старые cipher suites. Локальные модули могут уйти от upstream.
Долговечность показывает, что совместимость часто появляется через адаптацию, а не идеальный стандарт. RANCID не делает CLI одинаковыми; он создаёт общий процесс поверх различий. Репозиторий становится стабильным интерфейсом. Главное — память покидает устройство: даже при полной гибели маршрутизатора остаются последняя конфигурация и история.
router.db превращает парк в расписанный план сбора
Традиционный процесс начинается с router.db, связывающего hostnames, типы и состояния. Активные записи становятся целями. Группы задают расписания, repositories и области ответственности. Файл прост для review и versioning, но определяет, какие устройства будут запомнены, а какие останутся невидимыми.
Простота делает ошибки читаемыми: опечатка в имени, неверный тип, disabled-state. Но она не гарантирует полноту. Отсутствующий маршрутизатор не обнаруживается автоматически. Списанное устройство может остаться. Имя может разрешаться в неожиданную адресу. Список нужно сверять с asset-register или source of truth.
Когда запускается rancid-run, он выбирает активные цели, вызывает login и vendor-логику, получает вывод, сравнивает и commits значимые изменения. Ошибки и retries — часть сервиса. Устройство может быть недоступно, аутентификация — не пройти, команда — вернуть неполные данные. Каждый запуск должен иметь статус; наличие файла не доказывает его свежесть.
Старая копия может быть чистой и убедительной. Оператору нужны время последнего успешного сбора, число последовательных ошибок и подтверждение выполнения всех ожидаемых команд. Архив без freshness-monitoring создаёт ложную уверенность.
Группы позволяют ограничить blast radius. Разные среды используют разные credentials, частоты и repositories; критические устройства можно собирать чаще или с изолированных hosts. Но router.db не является source of intent, это план сбора. Сравнение с NetBox, Nautobot или реестром активов выявляет устройства без истории и забытый парк.
Login через Expect сделал автоматизацию возможной и сконцентрировал секреты
Интерактивные CLI проектировались для людей. Они показывают banners, запрашивают имя и пароль, договариваются о терминале, приостанавливают вывод и меняют prompt по режиму. Expect ожидает шаблон и отвечает, превращая разговор в автоматизированную последовательность.
RANCID использует эту модель. Инструменты открывают Telnet или SSH, обрабатывают prompts, входят в привилегированный режим и запускают команды. Так оборудование автоматизировали задолго до model-driven API.
Механизм создаёт серьёзную концентрацию риска. Collector может нуждаться в доступе к сотням или тысячам устройств. Учётные данные часто описаны в .cloginrc и защищены правами файловой системы. Компрометация хоста или файла даёт атакующему карту флоты и данные для management plane. Общие и привилегированные аккаунты расширяют последствия.
Даже «read only» зависит от платформы. Некоторые устройства плохо отделяют показ конфигурации от более широких команд. Репозиторий может содержать community strings, hashes, keys, имена клиентов и внутренние адреса. Фильтрация помогает, но не гарантирует отсутствие secrets.
Хост RANCID следует считать привилегированной системой: сегментировать, обновлять, резервировать и мониторить. Аккаунты должны быть ограничены, ротированы и audited. SSH заменяет Telnet, где возможно. Старые алгоритмы изолируются, а не разрешаются на универсальном management-host. Доступ к repository строится по least privilege.
Vendor-модули переводят нестабильный вывод в сравнимый текст
RANCID не получает абстрактную универсальную конфигурацию. Он выполняет команды конкретной платформы, читает вывод и применяет parser и фильтры. Модуль знает, что запросить, какие строки сохранить, как обрабатывать режимы и как упорядочить результат.
Это знание — операционный актив. Платформы по-разному называют interfaces, inventory, software и route tables. Некоторые печатают uptime, timestamps и counters. Модуль превращает разнообразие в файлы, достаточно стабильные для полезного diff.
Перевод может тихо сломаться. Новая версия перемещает строку, меняет header или требует иного privilege. Parser продолжает работать, но теряет раздел. Поэтому успех должен включать content-tests, а не только exit code.
Поддержка модулей требует доступа к оборудованию, примеров и знания версий. Локальные forks быстро решают проблему и усложняют update. Организация должна знать свои patches, сравнивать с upstream и тестировать firmware до production.
Нормализация отделяет значимое изменение от шума каждого запуска
CLI-вывод содержит значения, которые меняются без конфигурационных изменений: uptime, дата, counters, session IDs, шифрованные hashes, порядок строк. Если хранить всё, каждый запуск даст diff и сигнал утонет.
RANCID удаляет или маскирует часть таких значений и стабилизирует порядок. Repository показывает изменения policy, interface или access вместо обновлённого счётчика. Благодаря этому простой diff остаётся полезным годами.
Но нормализация — редакционное решение в коде. Недостаточная фильтрация создаёт постоянные алерты, чрезмерная — скрывает материал для incident или audit. Волатильное значение может стать важным при расследовании reboot или rotation ключей.
Оператор должен понимать, что фильтрует модуль. Изменения фильтра следует рассматривать как schema-change, потому что они меняют сохраняемую улику. Для особо критичных устройств можно хранить отдельно защищённый raw-output и нормализованную версию для сравнения.
Version control создаёт хронологию текста, но не журнал транзакций
CVS, Subversion или Git сохраняют версии, diffs и commit-times. Архив показывает развитие наблюдаемого текста и позволяет вернуться к старому состоянию. Export, replication и review просты.
Commit не является транзакцией на маршрутизаторе. Его автор обычно service-account, а не человек, ввёвший команду. Время — момент сбора или commit, а не обязательно изменения. Несколько команд попадут в один diff, промежуточные изменения отсутствуют.
Поэтому хронологию надо сопоставлять с AAA, syslog, tickets, pipeline и событиями устройства. Repository даёт независимую, но неполную ось времени. Сила — сохранённый текст; граница — отсутствие intent и транзакционной личности.
Git не улучшает доказательство автоматически, если историю можно переписать, часы неверны или commits не копируются. Retention, branch protection, signatures и immutable copies могут повысить assurance.
Периодический сбор оставляет окно, где решающее изменение может исчезнуть
RANCID наблюдает snapshots. Между двумя запусками человек или автоматизация могут изменить устройство, вызвать инцидент и сделать rollback. Репозиторий покажет два одинаковых состояния и пропустит ключевое событие.
Уменьшение интервала сокращает окно, но увеличивает сессии, нагрузку, commits и перекрытие задач. Некоторые устройства плохо переносят частые CLI-запросы. Большим паркам нужны расписание и concurrency-limit.
Для полной картины требуются AAA, syslog, оркестраторские logs, intent-commits, telemetry или command accounting. RANCID остаётся полезным как периодическая независимая проверка.
Freshness должна быть видима. Для каждого устройства задаётся допустимый возраст и alarm при серийных ошибках. Копия шестимесячной давности не ложна; это свидетельство другого момента. Интерфейс не должен выдавать её за текущее состояние.
Хост RANCID может раскрыть весь management plane
Collector собирает credentials, имена, адреса, описания, конфигурации и типы устройств. Компрометация даёт атакующему и карту, и способ доступа.
Repository способен содержать secrets даже после фильтрации: communities, hashes, keys, tunnel-addresses, customer data и policies. Backups, Git-mirrors и письма с diff умножают копии. Каждое хранилище становится частью control surface.
Защита должна охватывать весь путь: hardened host, management-segmentation, read-only accounts, права .cloginrc, зашифрованные и ограниченные backups, защищённую почту, access logging и rotation. Interactive access должен быть редким и атрибутируемым.
Нужно иметь план компрометации коллектора. Переустановка недостаточна: требуется определить и ротировать все затронутые credentials, найти копии и расследовать сессии. Централизация улучшает повседневный аудит и увеличивает потенциальный incident.
LibreNMS показывает симптом, RANCID добавляет контекст конфигурации
LibreNMS может сообщить о падении порта, потере соседа или росте ошибок. RANCID показывает изменение связанной конфигурации. Вместе они ускоряют диагностику, не превращая корреляцию в причинность.
Инструменты имеют разные расписания и могут пропускать события. Hardware-failure не обязательно даёт diff; diff может не иметь эффекта. Нужно согласовать время, проверить freshness и добавить logs или tickets.
Интеграция должна сохранять происхождение. Dashboard не должен показывать diff без даты и статуса сбора. Архив не должен утверждать, что объясняет симптом, который не измерял. Вместе они дают более полную историю: что случилось и что устройство сообщало рядом с этим временем.
GitOps и source of truth описывают intent; RANCID фиксирует ответ устройства
Современные системы моделируют инвентарь, адреса, services и policies в авторитетных данных, генерируют конфигурацию и применяют изменения через review и tests.
RANCID после или параллельно читает то, что устройство реально exposes. Он подтверждает применение intent, выявляет ручной drift или показывает, что vendor OS нормализовала команду иначе.
Опасно автоматически делать собранную конфигурацию новой intent. Наблюдаемая drift может быть как раз ошибкой. Устойчивый процесс сравнивает замысел и наблюдение, объясняет разницу и решает, какую сторону исправлять.
Независимость collector имеет контрольную ценность. Если orchestrator, intent-repository и устройство разделяют одну ошибку, отдельное чтение может показать состояние. Но independence должна быть реальной: общие учётные данные, parser или администраторы создают общие failure modes.
Oxidized и коммерческие менеджеры модернизируют workflow, но не устраняют исходную задачу
Oxidized предлагает более новую архитектуру, API и integrations. Коммерческие suites добавляют поддержку, compliance, orchestration и data models. Они могут упростить работу и дать контракт.
Ни один вариант не отменяет потребность получить доказательство того, что устройство сообщает. Они лишь иначе распределяют усилия между code, license, support и operations. Migration оценивается по покрытию, секретам, freshness, фильтрам и retention, а не только по современности интерфейса.
RANCID может продолжать обслуживать legacy-hardware, пока другой инструмент берёт новые платформы. Временное сосуществование безопаснее cutover, теряющего годы истории. Нужно знать, какой инструмент отвечает за каждое устройство и как reconciled различия.
Email-diff превращает repository в человеческий workflow
Почта долго была сигнальным слоем. Изменение генерирует diff для списка или команды, вставляя доказательство в привычный канал и позволяя совместный review.
Workflow может стать шумным. Плохая нормализация, многословная firmware или массовые changes создают поток писем, который перестают читать. Списки могут включать лишних людей, а письмо оставляет чувствительные копии вне repository.
Следует определить, какие группы получают какие устройства, как классифицируются письма, как ожидаемое изменение связывается с ticket и какой response требуется на неожиданное. Непрочитанный diff не является контролем.
Ticketing, chat и pipelines могут заменить или дополнить email, но логика та же: изменение текста превращается в человеческое решение. Автоматизация может добавить возраст, change window и критичность, не решая легитимность одна.
Looking glass показывает, что даже чтение нуждается в границах
RANCID исторически связывался с looking-glass-функциями, запускавшими ограниченные диагностические команды. Идея полезна: дать visibility без полного CLI-доступа.
Но «read only» не означает «без риска». Команды раскрывают топологию, маршруты, policy, внутренние имена и деловые отношения. Плохо проверенный input может разрешить неожиданные команды. Тяжёлый запрос нагружает маршрутизатор. Результаты могут распространяться слишком широко.
Интерфейс должен строго ограничивать команды, параметры, targets и frequency, логировать использование и по возможности использовать отдельные credentials. Выдаваемая информация должна соответствовать аудитории.
Общий урок: management plane содержит чувствительные данные даже без права изменения. Наблюдение требует управления так же, как запись.
Устойчивость опирается на небольшой канонический проект и множество невидимых установок
Канонический сайт Shrubbery Networks на cutoff продолжал указывать RANCID 3.14 как текущий, а линия 3.14 датировалась 2025 годом. GitHub mirrors и дистрибутивные пакеты существуют, но не заменяют канонический источник статуса.
Нет аудированного install-count, бюджета или полного списка maintainers. Большая ценность невидима: старые внутренние установки, локальные адаптации, packages, пользователи которых публично не участвуют.
Невидимость усложняет оценку влияния и succession. Mature software может долго работать с малым числом changes, но SSH, OS и CLI-output развиваются. Критическое знание может быть сосредоточено у нескольких людей.
Пользователям следует отслеживать versions, активность сайта, distribution patches, реакцию на reports, состояние собственных модулей и способность мигрировать. Спокойствие не равно заброшенности, но не должно считаться гарантией без проверки.
Миграция должна сохранить доказательство, а не просто заменить collector
Repositories могут содержать годы конфигураций, diffs, комментариев и timestamps. Начало с нуля обрывает хронологию именно тогда, когда она нужна при инциденте.
Migration определяет формат хранения, поиск старых устройств, соответствие имён и identities, разделение старых и новых commits. Время и branches должны быть проверены.
Полезен параллельный запуск на выборке. Различия выявляют отсутствующие команды, иные фильтры и parser-divergence. Успех — не только подключение, но сохранение равного поля доказательства и видимость ошибок.
Credentials следует ротировать, а не слепо копировать. Старые hosts, backups, mailing lists и repositories должны быть доказуемо выведены. Оставленные secrets увеличивают риск.
Текст конфигурации не равен поведению сети
Файл может выглядеть правильно, а forwarding — ломаться. Команда могла быть частично отвергнута, переписана, перекрыта динамическим state или нейтрализована hardware. RIB, FIB, sessions, queues и физическое состояние не сводятся к тексту.
Некоторые модули собирают operational output, но основной объект — текстовый snapshot. Для поведения нужны reachability tests, telemetry, protocol state и активные probes.
Обратное тоже верно: поведение кажется нормальным, а опасная конфигурация ждёт следующего отказа. Поэтому diff важен — он показывает структурное изменение до или после симптома.
Верная интерпретация связывает intent, observed configuration и runtime без смешения. Каждая — отдельная улика. Расследование объясняет совпадения и разрывы.
Аудитная ценность зависит от происхождения, retention и объяснимости коллектора
Чтобы repository поддерживал audit, необходимо объяснить, как получены данные, каким аккаунтом, какими командами, с какой частотой, фильтрами и ошибками. Без provenance набор файлов не определяет охват.
Retention должен быть задан. Старые устройства и конфигурации нужны для расследований или требований, но увеличивают риск secrets и customer data. Branches, backups и email должны подчиняться согласованной политике.
Immutable copies, access control, независимые logs и hashes повышают integrity. Они не делают архив безошибочным, но усложняют незаметное изменение и проясняют chain of custody.
Collector также документируется: версия, локальные модули, изменения нормализации и здоровье. Иначе файлы могут отличаться потому, что изменился parser, а не устройство. Audit должен это различать.
Legacy-оборудование сохраняет потребность в узкой совместимости
Сети держат устройства дольше, чем живут современные tooling-cycles. Некоторые не имеют gNMI, надёжного NETCONF или API. Они продолжают говорить по CLI и иногда через старую криптографию. Пока они несут traffic, нужно сохранять state.
RANCID покрывает нишу узкими модулями. Это не оправдывает бесконечную эксплуатацию уязвимого hardware. Напротив, инструмент должен показывать debt: Telnet, слабые algorithms, shared accounts, unmaintained modules.
Isolation критична. Требования старого устройства не должны ослаблять общий management-host. Отдельные collectors, jump hosts и segmentation ограничивают риск до замены.
Узкая совместимость становится переходным механизмом: сохраняет evidence и operation, пока планируется выход, а не аргументом против renewal.
Во многих парках новые устройства предоставляют структурированную телеметрию, а старые по-прежнему ограничены CLI и SNMP. RANCID сохраняет свидетельства для второй группы, не превращая совместимость в утверждение о безопасности или долгосрочной пригодности оборудования.
Узкий инструмент может пережить несколько волн управления
RANCID прошёл через NMS, SDN, intent-based networking, infrastructure as code и GitOps. Он выжил не обещанием заменить их, а сохранением ограниченной функции: получать текст и показывать изменение.
Узкую функцию легко объяснить, проверить и мигрировать. Она уменьшает зависимость от proprietary models. Текст и diff читаются обычными инструментами, снижая цену continuity.
Простота становится слабостью, если не поддерживаются новые платформы, безопасность или succession. Прошлая долговечность не гарантирует будущее. Каждая организация проверяет собственное покрытие и exit plan.
Урок не в том, что простое всегда лучше, а в том, что essential function должна оставаться exportable и понятной при смене большой платформы.
Текстовый diff важен, потому что это ограниченное и проверяемое доказательство
Главное достоинство RANCID — отсутствие необходимости верить непрозрачной модели. Файл показывает полученный текст; diff — добавленные, удалённые и изменённые строки; history — последовательные наблюдения. Инженер может проверить всё обычными инструментами.
Читаемость сокращает расстояние между сбором и суждением. Фильтр можно оспорить, аномалию увидеть, старую конфигурацию вернуть. Формат переносим из продукта. Даже исчезновение RANCID не уничтожит repository.
Доказательство ограничено: набор команд, момент, parser и access. Оно не показывает всё. Явная граница здоровее dashboard, смешивающего наблюдение, расчёт и вывод без ясного происхождения.
Стратегическая ценность появляется при независимости от intent. Организация может иметь современный pipeline и хранить RANCID как свидетеля. Ручное изменение, failure оркестратора или vendor-различие получает точку сравнения.
Цена реальна: credentials, модули, storage, обработка errors и экспозиция secrets. Вопрос не в старомодности diff, а в том, превышает ли расследовательная ценность стоимость и соответствуют ли controls риску.
Финальный тест прост. После следующего incident сможет ли команда назвать последнее наблюдаемое изменение, время успешного сбора, объяснить пропуски модуля и связать diff с intent и событиями? Если да, инструмент эпохи CLI продолжает быть полезной инфраструктурой знания.
Обзор для участников
Подробный контекст профиля
Войдите с подходящим уровнем подписки, чтобы открыть полный обзор и примечания к источникам.
Только для Стратегического сообщества
Стратегическое сообщество
Открыто всем читателям. Вступите и войдите, чтобы открыть обзоры профилей.
Вступить в Стратегическое сообществоТолько для Альянса лидеров
Альянс лидеров
Для проверенных владельцев IP-активов и руководителей. Войдите, чтобы открыть обзоры Альянса.
Вступить в Альянс лидеров