
Kurz
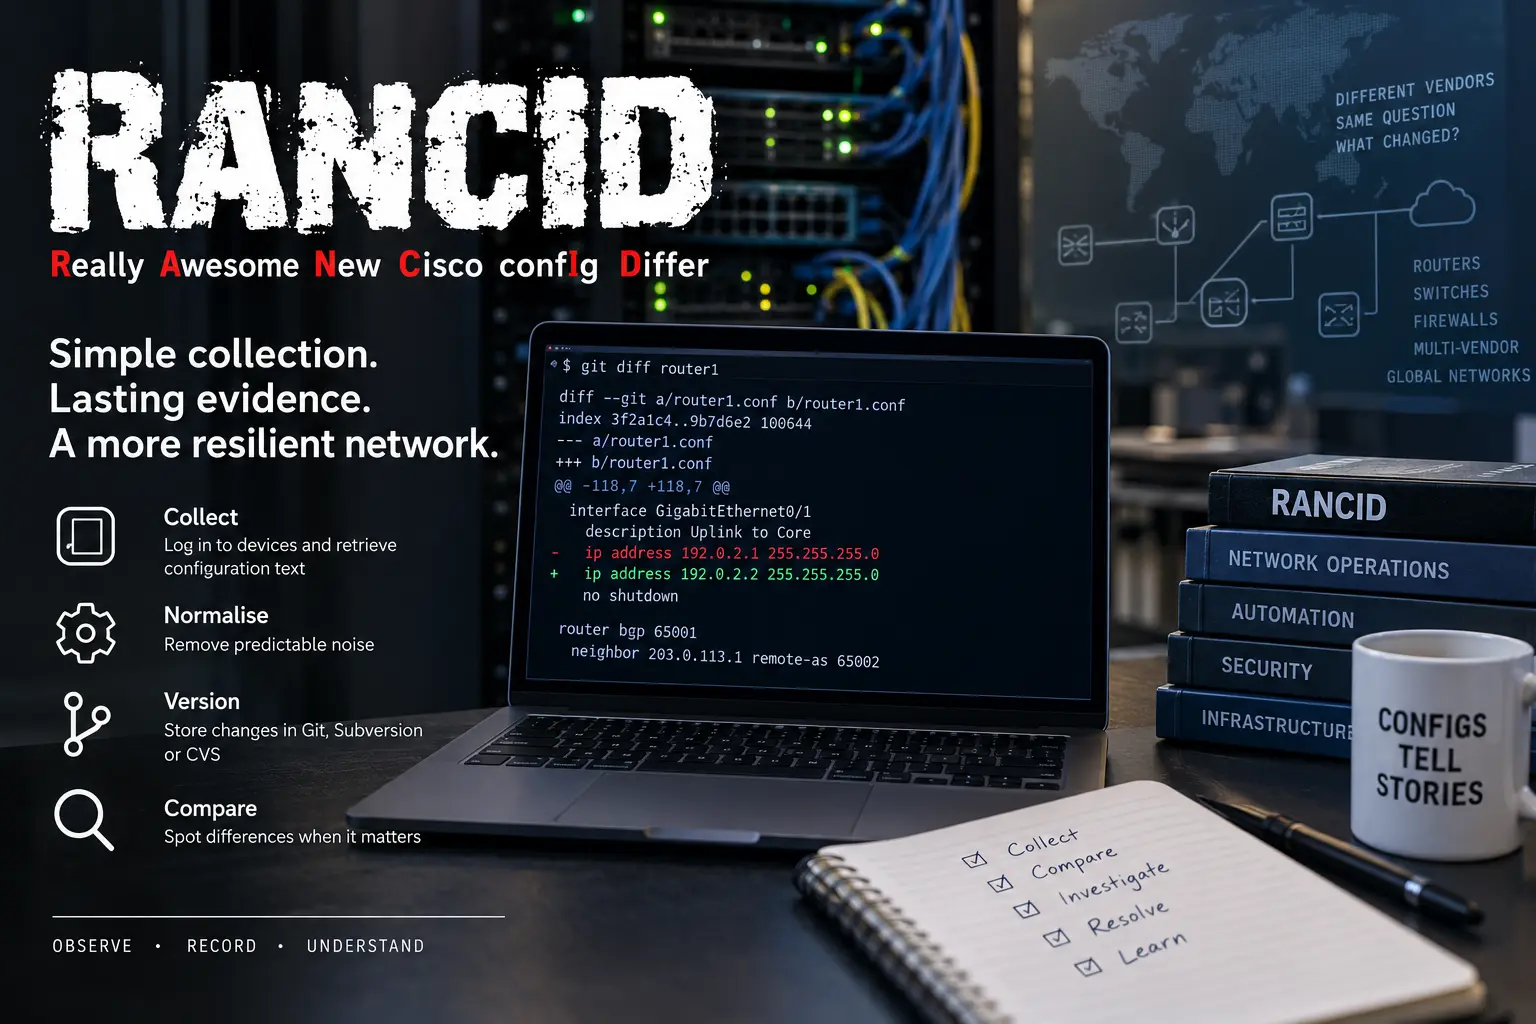
- RANCID — Really Awesome New Cisco confIg Differ — sammelt regelmäßig Konfigurationen über herstellerorientierte Login-Skripte und Module, normalisiert die Ausgabe und speichert Änderungen in CVS, Subversion oder Git.
- Sein Material ist beobachtbarer Text, kein Sollzustand: Ein Snapshot kann Drift oder eine kurzfristige Änderung zeigen, aber zwischengeschaltete Aktionen, Runtime-Status und die Identität des Verfassers übersehen.
- Ein Host, der die Vorfalluntersuchung verbessert, wird zu einem hochwertigen Ziel, weil er Management-Zugangsdaten, Topologie und Konfigurationsgeheimnisse der gesamten Flotte konzentriert.
- RANCID bleibt neben GitOps, Automatisierung und Source-of-Truth-Systemen nützlich, weil ein unabhängiger Collector zeigen kann, was ein Gerät nach einem Umgehungsschritt oder einer teilweise ausgeführten regulären Ablage tatsächlich gemeldet hat.
Nach einem Ausfall ist die kleinste nützliche Frage oft: „Was hat sich verändert?“
Ein Netz kann durch ein komplexes Zusammenspiel von Routing-Policy, Interface-Status, Softwarefehlern und Last ausfallen. Die erste praktische Spur bleibt aber eine einzelne Zeile: die Nachbaradresse hat sich geändert, eine ACL wurde verschoben, einem Route-Map wurde ein Match hinzugefügt, ein Trunk hat ein VLAN verloren. Das Gerät nahm einen Befehl an, und die Folgen erschienen später und möglicherweise weit entfernt vom Änderungspunkt.
RANCID wurde geschaffen, um eine solche Spur zu sichern. Es verbindet sich mit Routern, Switches und anderen unterstützten Geräten, führt Befehle aus, filtert die Ausgabe und committet den erhaltenen Text in ein Versionssystem. Bei einer Dateiänderung zeigt das Repository einen Diff an und kann eine E-Mail senden oder einen anderen Workflow auslösen. Das System muss das gesamte geschäftliche Ziel nicht verstehen, um festzuhalten: Das Gerät meldet jetzt einen anderen Text.
Die Bescheidenheit des Modells ist eine Stärke. RANCID behauptet nicht, eine vollständige Control Plane zu sein. Es plant kein Wartungsfenster, erzeugt nicht alle Konfigurationen und garantiert keine Compliance. Es führt periodische Beobachtungen durch. Daher ist es in gemischten Umgebungen nützlich, in denen manche Geräte automatisiert, andere manuell verwaltet und wieder andere zu alt für moderne APIs sind.
Das Modell ist bewusst unvollständig. Eine Änderung kann zwischen zwei Sammlungen angewendet und zurückgenommen werden. Ein Login-Fehler lässt eine alte Datei frisch aussehen. Ein Herstellermodul fragt vielleicht den entscheidenden Befehl nicht ab. Die Normalisierung kann einen Wert entfernen, der später wichtig wird. Ein Diff belegt nur den Textunterschied, den der Collector gesehen hat; er belegt nicht, wer und warum das Gerät geändert hat und ob dies den Ausfall verursachte.
Diese Grenzen mindern den Beweiswert nicht, sondern präzisieren ihn. RANCID liefert eine langlebige, einfache Antwort auf eine einzige, eng begrenzte Frage. Während eines Vorfalls ist das manchmal nützlicher als ein breites Symptom-Dashboard ohne Konfigurationskontext.
Das Projekt gab Routern ein externes Gedächtnis, bevor Controller modern wurden
RANCID entstand in einer Zeit, in der Netzwerkgeräte hauptsächlich über die CLI verwaltet wurden. Die Konfiguration lebte auf Routern und Switches, das Betriebswissen im Kopf der Ingenieure, in Terminal-Historien und persönlichen Verzeichnissen. Der Austausch eines Geräts oder ein fehlerhafter Befehl konnte zeigen, dass die Organisation keine unabhängige aktuelle Kopie besaß.
Der Name begann bei Cisco, doch die Abdeckung erweiterte sich über Herstellermodule. Die Architektur akzeptierte eine unbequeme Tatsache: Prompts, Login-Sequenzen, Paging und Befehle unterscheiden sich. Statt auf ein einheitliches Modell zu warten, automatisierte RANCID die realen Schnittstellen.
clogin, das über Expect läuft, kann Eingabeaufforderungen erkennen, eine Sitzung führen, in den privilegierten Modus wechseln und Befehle ausführen. Das Modul holt die Running Configuration, das Inventar oder einen anderen Status ab; dann wird die Ausgabe normalisiert und als Text gespeichert.
Der Ansatz ist so fragil wie jede CLI-Automatisierung. Ein neuer Prompt bricht das Skript. Firmware ändert die Ausgabe. Banner, Paging, Authentifizierung und Timing unterscheiden sich. Manche Geräte verlangen Telnet oder alte Cipher-Suites. Lokale Module können vom Upstream abweichen.
Die Langlebigkeit zeigt, dass Kompatibilität oft durch Anpassung entsteht, nicht durch einen idealen Standard. RANCID macht die CLI nicht gleich; es schafft einen gemeinsamen Prozess über den Unterschieden. Das Repository wird zur stabilen Schnittstelle. Entscheidend ist, dass das Gedächtnis das Gerät verlässt: Selbst bei vollständigem Verlust eines Routers bleiben die letzte Konfiguration und die Historie.
router.dbverwandelt den Gerätepark in einen geplanten Sammlungsfahrplan
Der traditionelle Prozess beginnt mitrouter.db, das Hostnamen, Typen und Zustände verknüpft. Aktive Einträge werden Ziele. Gruppen bestimmen Zeitpläne, Repositories und Verantwortungsbereiche. Die Datei ist einfach zu prüfen und zu versionieren, entscheidet aber, welche Geräte erinnert werden und welche unsichtbar bleiben.
Die Einfachheit macht Fehler lesbar: ein Tippfehler im Namen, ein falscher Typ, ein deaktivierter Zustand. Sie garantiert aber keine Vollständigkeit. Ein fehlender Router wird nicht automatisch entdeckt. Ein ausgemustertes Gerät kann bleiben. Ein Name kann zu einer unerwarteten Adresse auflösen. Die Liste muss mit dem Asset-Register oder der Source of Truth abgeglichen werden.
Wennrancid-runstartet, wählt er aktive Ziele, ruft Login und Herstellerlogik auf, holt die Ausgabe ab, vergleicht und committet relevante Änderungen. Fehler und Wiederholungen sind Teil des Dienstes. Ein Gerät kann nicht erreichbar sein, die Authentifizierung kann scheitern, ein Befehl kann unvollständige Daten liefern. Jeder Lauf braucht einen Status; das Vorhandensein einer Datei beweist nicht ihre Aktualität.
Eine alte Kopie kann sauber und überzeugend sein. Der Operator braucht den Zeitpunkt der letzten erfolgreichen Sammlung, die Zahl aufeinanderfolgender Fehler und die Bestätigung, dass alle erwarteten Befehle ausgeführt wurden. Ein Archiv ohne Freshness-Monitoring erzeugt falsche Sicherheit.
Gruppen ermöglichen es, den Wirkungsradius zu begrenzen. Verschiedene Umgebungen nutzen andere Zugangsdaten, Frequenzen und Repositories; kritische Geräte können häufiger oder von isolierten Hosts gesammelt werden. Aberrouter.dbist keine Source of Intent, sondern ein Sammlungsplan. Der Vergleich mit NetBox, Nautobot oder dem Asset-Register zeigt Geräte ohne Historie und vergessene Parks.
Login über Expect machte Automatisierung möglich und konzentrierte die Geheimnisse
Interaktive CLIs wurden für Menschen entworfen. Sie zeigen Banner, fragen nach Name und Passwort, verhandeln das Terminal, unterbrechen die Ausgabe und ändern den Prompt je nach Modus. Expect erwartet ein Muster und antwortet und verwandelt das Gespräch in eine automatisierte Sequenz.
RANCID nutzt dieses Modell. Die Werkzeuge öffnen Telnet oder SSH, behandeln Prompts, wechseln in den privilegierten Modus und führen Befehle aus. So wurde Equipment lange vor model-driven APIs automatisiert.
Der Mechanismus erzeugt eine erhebliche Risikokonzentration. Der Collector benötigt möglicherweise Zugriff auf hunderte oder tausende Geräte. Zugangsdaten sind oft in.cloginrcbeschrieben und durch Dateisystemrechte geschützt. Die Kompromittierung des Hosts oder der Datei gibt einem Angreifer die Karte der Flotte und Daten für die Management-Plane. Gemeinsame und privilegierte Konten vergrößern die Folgen.
Sogar „read only“ hängt von der Plattform ab. Manche Geräte trennen die Anzeige der Konfiguration nur schlecht von weiterreichenden Befehlen. Das Repository kann Community-Strings, Hashes, Schlüssel, Kundennamen und interne Adressen enthalten. Filterung hilft, garantiert aber keine Geheimnisfreiheit.
Der RANCID-Host sollte als privilegiertes System behandelt werden: segmentiert, aktualisiert, gesichert und überwacht. Konten müssen eingeschränkt, rotiert und auditiert werden. SSH ersetzt Telnet, wo möglich. Alte Algorithmen werden isoliert, nicht auf einem universellen Management-Host zugelassen. Der Repository-Zugriff folgt dem Least-Privilege-Prinzip.
Herstellermodule übersetzen instabile Ausgabe in vergleichbaren Text
RANCID erhält keine abstrakte universelle Konfiguration. Es führt Befehle der konkreten Plattform aus, liest die Ausgabe und wendet Parser und Filter an. Das Modul weiß, was abgefragt werden soll, welche Zeilen behalten werden, wie Modi behandelt und das Ergebnis geordnet wird.
Dieses Wissen ist ein Betriebsaktiv. Plattformen nennen Interfaces, Inventar, Software und Routentabellen unterschiedlich. Manche geben Uptime, Zeitstempel und Zähler aus. Das Modul verwandelt die Vielfalt in Dateien, die für einen nützlichen Diff stabil genug sind.
Die Übersetzung kann still scheitern. Eine neue Version verschiebt eine Zeile, ändert einen Header oder verlangt ein anderes Privileg. Der Parser läuft weiter, verliert aber einen Abschnitt. Erfolg muss daher Content-Tests umfassen, nicht nur den Exit-Code.
Die Pflege von Modulen erfordert Zugriff auf Hardware, Beispiele und Versionswissen. Lokale Forks lösen das Problem schnell und erschweren Updates. Die Organisation muss ihre Patches kennen, mit dem Upstream vergleichen und Firmware vor dem Produktivbetrieb testen.
Normalisierung trennt die relevante Änderung vom Rauschen jedes Laufs
Die CLI-Ausgabe enthält Werte, die sich ohne Konfigurationsänderung ändern: Uptime, Datum, Zähler, Session-IDs, verschlüsselte Hashes, Zeilenreihenfolge. Speichert man alles, liefert jeder Lauf einen Diff, und das Signal ertrinkt.
RANCID entfernt oder maskiert einen Teil solcher Werte und stabilisiert die Reihenfolge. Das Repository zeigt Änderungen an Policy, Interface oder Zugriff statt eines aktualisierten Zählers. Dadurch bleibt der einfache Diff über Jahre nützlich.
Aber Normalisierung ist eine redaktionelle Entscheidung im Code. Unzureichende Filterung erzeugt ständige Alarme, übermäßige Filterung versteckt Material für Incident oder Audit. Ein volatiler Wert kann bei der Untersuchung eines Reboots oder einer Schlüsselrotation wichtig werden.
Der Operator muss verstehen, was das Modul filtert. Filteränderungen sind wie -Änderungen zu behandeln, weil sie die gespeicherte Spur verändern. Für besonders kritische Geräte kann man eine gesondert geschützte Raw-Ausgabe und eine normalisierte Version für Vergleiche speichern.
Versionskontrolle schafft eine Chronologie des Textes, aber kein Transaktionsprotokoll
CVS, Subversion oder Git speichern Versionen, Diffs und Commit-Zeiten. Das Archiv zeigt die Entwicklung des beobachtbaren Textes und erlaubt Rücksprünge auf alte Zustände. Export, Replikation und Review sind einfach.
Ein Commit ist keine Transaktion auf dem Router. Sein Autor ist meist ein Service-Konto, nicht der Mensch, der den Befehl eingegeben hat. Die Zeit ist der Moment der Sammlung oder des Commits, nicht unbedingt der Änderung. Mehrere Befehle landen in einem Diff, Zwischenänderungen fehlen.
Deshalb muss die Chronologie mit AAA, Syslog, Tickets, Pipelines und Geräteereignissen abgeglichen werden. Das Repository liefert eine unabhängige, aber unvollständige Zeitachse. Die Stärke ist der gesicherte Text; die Grenze ist das Fehlen von Intent und transaktioneller Identität.
Git verbessert den Beweis nicht automatisch, wenn die Geschichte umschrieben, die Uhren falsch oder Commits nicht kopiert werden können. Retention, Branch-Schutz, Signaturen und unveränderliche Kopien können die Zuverlässigkeit erhöhen.
Periodische Sammlung lässt ein Fenster, in dem die entscheidende Änderung verschwinden kann
RANCID beobachtet Snapshots. Zwischen zwei Läufen kann ein Mensch oder eine Automatisierung das Gerät ändern, einen Vorfall auslösen und einen Rollback durchführen. Das Repository zeigt zwei identische Zustände und überspringt das Schlüsselereignis.
Verkürzung des Intervalls verkleinert das Fenster, erhöht aber Sitzungen, Last, Commits und Aufgabenüberlappung. Manche Geräte vertragen häufige CLI-Abfragen schlecht. Große Parks brauchen einen Zeitplan und eine Concurrency-Grenze.
Für ein vollständiges Bild braucht es AAA, Syslog, Orchestrator-Logs, Intent-Commits, Telemetrie oder Command Accounting. RANCID bleibt als periodische unabhängige Prüfung nützlich.
Freshness muss sichtbar sein. Für jedes Gerät wird ein zulässiges Alter und bei aufeinanderfolgenden Fehlern ein Alarm festgelegt. Eine sechs Monate alte Kopie ist nicht falsch; sie ist ein Zeugnis eines anderen Zeitpunkts. Die Oberfläche darf sie nicht als aktuellen Zustand ausgeben.
Der RANCID-Host kann die gesamte Management-Plane offenlegen
Der Collector sammelt Zugangsdaten, Namen, Adressen, Beschreibungen, Konfigurationen und Gerätetypen. Eine Kompromittierung gibt dem Angreifer sowohl die Karte als auch den Zugangsweg.
Das Repository kann Geheimnisse selbst nach Filterung enthalten: Communities, Hashes, Schlüssel, Tunnel-Adressen, Kundendaten und Policies. Backups, Git-Mirrors und Diff-E-Mails vervielfachen die Kopien. Jeder Speicher wird Teil der Control Surface.
Der Schutz muss den gesamten Weg umfassen: gehärteter Host, Management-Segmentierung, Read-only-Konten, Rechte an.cloginrc, verschlüsselte und eingeschränkte Backups, geschützte Post, Zugriffslogging und Rotation. Interaktiver Zugriff sollte selten und zuordenbar sein.
Man braucht einen Plan für die Kompromittierung des Collectors. Neuinstallation genügt nicht: Es müssen alle betroffenen Zugangsdaten bestimmt und rotiert, Kopien gesucht und Sitzungen untersucht werden. Zentralisierung verbessert das alltägliche Audit und vergrößert den potenziellen Vorfall.
LibreNMS zeigt das Symptom, RANCID liefert den Konfigurationskontext
LibreNMS kann über einen ausgefallenen Port, den Verlust eines Nachbarn oder steigende Fehler berichten. RANCID zeigt die Änderung der zugehörigen Konfiguration. Zusammen beschleunigen sie die Diagnose, ohne Korrelation in Kausalität zu verwandeln.
Die Werkzeuge haben unterschiedliche Zeitpläne und können Ereignisse übersehen. Ein Hardware-Fehler liefert nicht unbedingt einen Diff; ein Diff kann ohne Wirkung sein. Zeit muss abgeglichen, Freshness geprüft und Logs oder Tickets ergänzt werden.
Die Integration muss die Herkunft bewahren. Ein Dashboard darf keinen Diff ohne Datum und Sammlungsstatus zeigen. Das Archiv darf nicht behaupten, ein Symptom zu erklären, das es nicht gemessen hat. Zusammen liefern sie eine vollständigere Geschichte: was geschah und was das Gerät nahe diesem Zeitpunkt meldete.
GitOps und Source of Truth beschreiben Intent; RANCID hält die Antwort des Geräts fest
Moderne Systeme modellieren Inventar, Adressen, Services und Policies in autoritativen Daten, erzeugen Konfiguration und wenden Änderungen über Review und Tests an.
RANCID liest danach oder parallel, was das Gerät tatsächlich ausliefert. Er bestätigt die Umsetzung von Intent, zeigt manuellen Drift oder dass die Hersteller-OS einen Befehl anders normalisiert hat.
Es ist gefährlich, die gesammelte Konfiguration automatisch zur neuen Intent zu machen. Beobachteter Drift kann gerade der Fehler sein. Ein stabiler Prozess vergleicht Absicht und Beobachtung, erklärt die Differenz und entscheidet, welche Seite zu korrigieren ist.
Die Unabhängigkeit des Collectors hat Kontrollwert. Wenn Orchestrator, Intent-Repository und Gerät denselben Fehler teilen, kann ein separates Lesen den Zustand zeigen. Aber Unabhängigkeit muss real sein: gemeinsame Zugangsdaten, Parser oder Administratoren erzeugen gemeinsame Ausfallmodi.
Oxidized und kommerzielle Manager modernisieren den Workflow, heben aber die ursprüngliche Aufgabe nicht auf
Oxidized bietet eine neuere Architektur, APIs und Integrationen. Kommerzielle Suiten ergänzen Support, Compliance, Orchestrierung und Datenmodelle. Sie können die Arbeit vereinfachen und einen Vertrag liefern.
Keine Variante hebt die Notwendigkeit auf, den Beweis dafür zu erhalten, was ein Gerät meldet. Sie verteilen nur anders Aufwand zwischen Code, Lizenz, Support und Betrieb. Eine Migration wird anhand von Abdeckung, Geheimnissen, Freshness, Filtern und Retention bewertet, nicht nur an der Modernität der Oberfläche.
RANCID kann Legacy-Hardware weiter bedienen, während ein anderes Werkzeug neue Plattformen übernimmt. Zeitweiliges Nebeneinander ist sicherer als ein Cutover, der Jahre an Historie verliert. Man muss wissen, welches Werkzeug für jedes Gerät verantwortlich ist und wie Unterschiede abgeglichen werden.
Der E-Mail-Diff verwandelt das Repository in einen menschlichen Workflow
Post war lange die Signalebene. Eine Änderung erzeugt einen Diff für eine Liste oder ein Team, fügt den Beweis in einen vertrauten Kanal ein und erlaubt gemeinsames Review.
Der Workflow kann verrauschen. Schlechte Normalisierung, wortreiche Firmware oder Massenänderungen erzeugen einen E-Mail-Strom, den niemand mehr liest. Listen können überflüssige Empfänger enthalten, und eine E-Mail hinterlässt sensible Kopien außerhalb des Repositories.
Es sollte festgelegt werden, welche Gruppen welche Geräte erhalten, wie Mails klassifiziert werden, wie eine erwartete Änderung mit einem Ticket verbunden wird und welche Reaktion auf eine unerwartete verlangt wird. Ein ungelesener Diff ist keine Kontrolle.
Ticketing, Chat und Pipelines können E-Mail ersetzen oder ergänzen, aber die Logik bleibt: Eine Textänderung wird zu einer menschlichen Entscheidung. Automatisierung kann Alter, Change-Window und Kritikalität ergänzen, ohne allein die Rechtmäßigkeit zu entscheiden.
Looking Glass zeigt, dass selbst Lesen Grenzen braucht
RANCID war historisch mit Looking-Glass-Funktionen verbunden, die begrenzte Diagnosebefehle ausführten. Die Idee ist nützlich: Sichtbarkeit ohne vollen CLI-Zugriff.
Doch „read only“ bedeutet nicht „ohne Risiko“. Befehle offenbaren Topologie, Routen, Policies, interne Namen und Geschäftsbeziehungen. Schlecht geprüfter Input kann unerwartete Befehle ermöglichen. Eine schwere Abfrage belastet den Router. Ergebnisse können sich zu weit verbreiten.
Die Schnittstelle muss Befehle, Parameter, Ziele und Frequenz strikt begrenzen, Nutzung loggen und möglichst eigene Zugangsdaten verwenden. Die herausgegebenen Informationen müssen zur Zielgruppe passen.
Allgemeine Lehre: Die Management-Plane enthält sensible Daten auch ohne Änderungsrecht. Beobachtung erfordert dieselbe Steuerung wie das Schreiben.
Die Beständigkeit ruht auf einem kleinen kanonischen Projekt und vielen unsichtbaren Installationen
Die kanonische Website von Shrubbery Networks wies zum Stichtag weiterhin RANCID 3.14 als aktuell aus, und die 3.14-Linie war mit 2025 datiert. GitHub-Mirrors und Distributionspakete existieren, ersetzen aber nicht die kanonische Statusquelle.
Es gibt keine auditierte Installationszahl, kein Budget und keine vollständige Maintainer-Liste. Ein großer Teil des Werts ist unsichtbar: alte interne Installationen, lokale Anpassungen, Pakete und Nutzer, die sich öffentlich nicht beteiligen.
Unsichtbarkeit erschwert Wirkungsabschätzung und Nachfolge. Ausgereifte Software kann lange mit wenigen Änderungen laufen, aber SSH, OS und CLI-Ausgabe entwickeln sich weiter. Kritisches Wissen kann bei wenigen Personen konzentriert sein.
Nutzer sollten Versionen, Website-Aktivität, Distributions-Patches, Reaktion auf Berichte, den Zustand eigener Module und die Migrationsfähigkeit verfolgen. Ruhe ist nicht gleichbedeutend mit Verlassenheit, sollte aber ohne Prüfung nicht als Garantie gelten.
Eine Migration muss den Beweis erhalten, nicht nur den Collector ersetzen
Repositories können Jahre an Konfigurationen, Diffs, Kommentaren und Zeitstempeln enthalten. Ein Neuanfang bricht die Chronologie genau dann, wenn sie bei einem Vorfall gebraucht wird.
Die Migration bestimmt das Speicherformat, findet alte Geräte, gleicht Namen und Identitäten ab und trennt alte und neue Commits. Zeiten und Branches müssen geprüft werden.
Nützlich ist ein paralleler Lauf auf einer Stichprobe. Unterschiede zeigen fehlende Befehle, andere Filter und Parser-Divergenz. Erfolg ist nicht nur die Anbindung, sondern die Erhaltung eines gleichwertigen Beweisfelds und die Sichtbarkeit von Fehlern.
Zugangsdaten sollten rotiert, nicht blind kopiert werden. Alte Hosts, Backups, Mailinglisten und Repositories müssen nachweislich stillgelegt werden. Zurückgelassene Geheimnisse erhöhen das Risiko.
Konfigurationstext ist nicht gleich Netzverhalten
Eine Datei kann korrekt aussehen, während das Forwarding ausfällt. Ein Befehl kann teilweise abgelehnt, umgeschrieben, von dynamischem Zustand überlagert oder von Hardware neutralisiert worden sein. RIB, FIB, Sessions, Queues und physischer Zustand reduzieren sich nicht auf Text.
Manche Module sammeln operationale Ausgabe, aber das Hauptobjekt ist der Text-Snapshot. Für Verhalten braucht es Reachability-Tests, Telemetrie, Protokollzustand und aktive Probes.
Umgekehrt gilt ebenfalls: Verhalten erscheint normal, während eine gefährliche Konfiguration auf den nächsten Ausfall wartet. Deshalb ist der Diff wichtig — er zeigt die strukturelle Änderung vor oder nach dem Symptom.
Korrekte Interpretation verbindet Intent, beobachtete Konfiguration und Runtime, ohne sie zu vermischen. Jede ist eine eigene Spur. Die Untersuchung erklärt Übereinstimmungen und Brüche.
Der Auditwert hängt von Herkunft, Retention und Erklärbarkeit des Collectors ab
Damit ein Repository Audit unterstützt, muss erklärt werden, wie die Daten gewonnen wurden, mit welchem Konto, mit welchen Befehlen, welcher Frequenz, Filtern und Fehlern. Ohne Provenienz definiert ein Satz Dateien keine Abdeckung.
Retention muss festgelegt sein. Alte Geräte und Konfigurationen werden für Untersuchungen oder Anforderungen gebraucht, erhöhen aber das Risiko von Geheimnissen und Kundendaten. Branches, Backups und E-Mail müssen einer vereinbarten Politik unterliegen.
Unveränderliche Kopien, Zugriffssteuerung, unabhängige Logs und Hashes erhöhen die Integrität. Sie machen das Archiv nicht fehlerfrei, erschweren aber unmerkliche Änderungen und klären die Beweiskette.
Auch der Collector wird dokumentiert: Version, lokale Module, Änderungen der Normalisierung und Gesundheit. Sonst können sich Dateien unterscheiden, weil der Parser sich änderte, nicht das Gerät. Das Audit muss dies unterscheiden.
Legacy-Equipment erhält den Bedarf an schmaler Kompatibilität
Netze halten Geräte länger als moderne Tooling-Zyklen dauern. Manche haben kein gNMI, kein zuverlässiges NETCONF und keine API. Sie sprechen weiter CLI und manchmal alte Kryptografie. Solange sie Traffic tragen, muss der Zustand gesichert werden.
RANCID deckt diese Nische mit schmalen Modulen. Das rechtfertigt keinen endlosen Betrieb verwundbarer Hardware. Im Gegenteil: Das Werkzeug muss die Schulden zeigen — Telnet, schwache Algorithmen, geteilte Konten, ungepflegte Module.
Isolation ist entscheidend. Die Anforderungen alter Geräte dürfen den gemeinsamen Management-Host nicht schwächen. Separate Collector, Jump-Hosts und Segmentierung begrenzen das Risiko bis zum Austausch.
Schmale Kompatibilität wird zum Übergangsmechanismus: Sie sichert Beweis und Betrieb, solange der Ausstieg geplant wird, und ist kein Argument gegen Erneuerung.
In vielen Parks bieten neue Geräte strukturierte Telemetrie, während alte weiterhin auf CLI und SNMP beschränkt sind. RANCID sichert die Belege für die zweite Gruppe, ohne Kompatibilität zu einer Aussage über Sicherheit oder langfristige Eignung der Hardware zu machen.
Ein schmales Werkzeug kann mehrere Wellen von Steuerungsansätzen überleben
RANCID hat NMS, SDN, Intent-based Networking, Infrastructure as Code und GitOps durchlaufen. Es überlebte nicht mit dem Versprechen, sie zu ersetzen, sondern durch das Festhalten an einer begrenzten Funktion: Text holen und Änderung zeigen.
Eine schmale Funktion lässt sich leicht erklären, prüfen und migrieren. Sie verringert die Abhängigkeit von proprietären Modellen. Text und Diff sind mit gewöhnlichen Werkzeugen lesbar, was die Kontinuität verbilligt.
Einfachheit wird zur Schwäche, wenn neue Plattformen, Sicherheit oder Nachfolge nicht gepflegt werden. Vergangene Langlebigkeit garantiert keine Zukunft. Jede Organisation prüft ihre eigene Abdeckung und ihren Exit-Plan.
Die Lehre ist nicht, dass Einfaches immer besser ist, sondern dass die wesentliche Funktion exportierbar und verständlich bleiben muss, wenn eine große Plattform wechselt.
Der Text-Diff ist wichtig, weil er ein begrenzter und prüfbarer Beweis ist
Der wichtigste Vorteil von RANCID ist, dass man einer intransparenten Modellebene nicht vertrauen muss. Die Datei zeigt den erhaltenen Text; der Diff zeigt hinzugefügte, gelöschte und geänderte Zeilen; die Historie zeigt aufeinanderfolgende Beobachtungen. Ein Ingenieur kann alles mit gewöhnlichen Werkzeugen prüfen.
Lesbarkeit verkürzt die Distanz zwischen Sammlung und Urteil. Ein Filter kann angefochten, eine Anomalie gesehen, eine alte Konfiguration zurückgeholt werden. Das Format ist produktunabhängig. Selbst das Verschwinden von RANCID zerstört das Repository nicht.
Der Beweis ist begrenzt: ein Satz Befehle, ein Zeitpunkt, ein Parser und ein Zugang. Er zeigt nicht alles. Eine explizite Grenze ist gesünder als ein Dashboard, das Beobachtung, Berechnung und Schluss ohne klare Herkunft mischt.
Strategischer Wert entsteht bei Unabhängigkeit von Intent. Eine Organisation kann eine moderne Pipeline haben und RANCID als Zeugen behalten. Manuelle Änderung, Ausfall des Orchestrators oder Herstellerdifferenz erhält einen Vergleichspunkt.
Der Preis ist real: Zugangsdaten, Module, Speicher, Fehlerbehandlung und Exposition von Geheimnissen. Die Frage ist nicht, ob ein Diff altmodisch ist, sondern ob der Untersuchungswert die Kosten übersteigt und die Kontrollen dem Risiko entsprechen.
Der letzte Test ist einfach. Nach dem nächsten Vorfall: Kann das Team die letzte beobachtete Änderung benennen, den Zeitpunkt der erfolgreichen Sammlung nennen, die Auslassungen des Moduls erklären und den Diff mit Intent und Ereignissen verbinden? Wenn ja, bleibt das Werkzeug der CLI-Ära eine nützliche Wissensinfrastruktur.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten