Em resumo
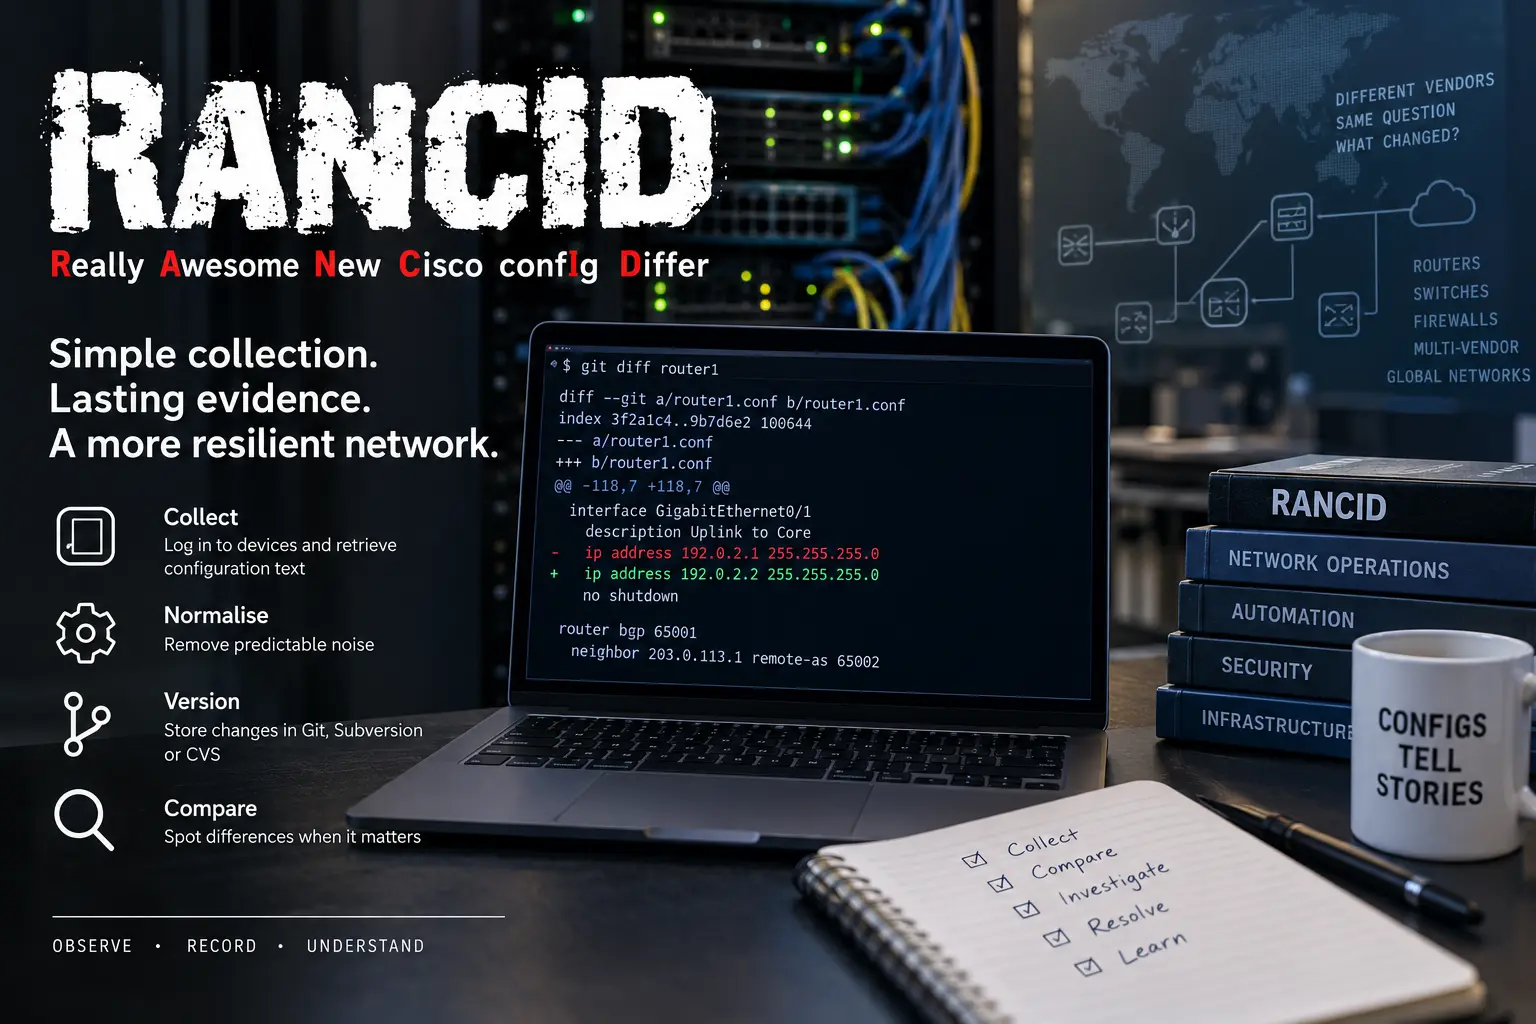
- RANCID — Really Awesome New Cisco confIg Differ — coleta configurações periodicamente por meio de scripts de login e módulos específicos de fornecedor, normaliza a saída e salva as alterações em CVS, Subversion ou Git.
- Seu material é texto observado, não o estado desejado: um snapshot pode revelar drift ou uma mudança urgente, mas pode deixar passar ações intermediárias, estado de runtime e a identidade do autor.
- Um host que melhora a investigação de incidentes torna-se um alvo de alto valor, porque concentra credenciais de gerenciamento, topologia e segredos de configuração de toda a frota.
- O RANCID continua útil ao lado de GitOps, automação e sistemas de fonte da verdade, porque um coletor independente pode mostrar o que o dispositivo realmente reportou após uma intervenção manual ou uma execução parcial do processo padrão.
Depois de uma falha, a menor pergunta útil costuma ser "o que mudou?"
Uma rede pode falhar por causa da interação complexa entre política de roteamento, estado de interfaces, erros de software e carga. Mas a primeira pista prática é sempre uma linha: o endereço de um vizinho mudou, uma ACL foi reordenada, um match foi adicionado a um route-map, um trunk perdeu uma VLAN. O dispositivo aceitou o comando, e as consequências apareceram depois e, talvez, longe do ponto de alteração.
O RANCID foi criado para preservar essa pista. Ele se conecta a roteadores, switches e outros dispositivos suportados, executa comandos, filtra a saída e faz commit do texto obtido no sistema de versões. Quando um arquivo muda, o repositório mostra o diff e pode enviar um e-mail ou disparar outro fluxo de trabalho. O sistema não precisa entender todo o objetivo de negócio para registrar o essencial: o dispositivo agora reporta um texto diferente.
A modéstia do modelo é uma virtude. O RANCID não afirma ser um control plane completo. Ele não agenda janelas, não gera todas as configurações e não garante conformidade. Ele faz observações periódicas. Por isso é útil em um parque heterogêneo, em que alguns dispositivos são automatizados, outros são gerenciados manualmente e outros ainda são antigos demais para APIs modernas.
O modelo é incompleto por concepção. Uma alteração pode ser aplicada e revertida entre duas coletas. Uma falha de login deixará um arquivo antigo com aparência de atual. Um módulo de fornecedor pode não solicitar o comando decisivo. A normalização pode remover um valor que depois se mostrará importante. O diff só comprova a diferença de texto vista pelo coletor; ele não prova quem mudou o dispositivo, por quê, nem se isso causou o incidente.
Esses limites não diminuem o valor da evidência — eles o delimitam com precisão. O RANCID oferece uma resposta duradoura e pouco complexa a uma pergunta restrita. Durante um incidente, isso às vezes é mais útil do que um painel amplo de sintomas sem contexto de configuração.
O projeto deu aos roteadores memória externa antes que os controladores virassem moda
O RANCID surgiu em uma época em que os equipamentos de rede eram gerenciados principalmente pela CLI. A configuração vivia nos roteadores e switches, e o conhecimento operacional, na memória dos engenheiros, no histórico de terminais e em diretórios pessoais. A substituição de um equipamento ou um comando errado podia revelar que a organização não tinha uma cópia atual independente.
O nome começou com Cisco, mas a cobertura se expandiu por meio de módulos de fornecedor. A arquitetura aceitou um fato incômodo: prompts, sequências de login, paginação e comandos variam. Em vez de esperar por um modelo único, o RANCID automatizou as interfaces reais.
Oclogin, executado via Expect, pode reconhecer prompts, conduzir a sessão, entrar no modo privilegiado e executar comandos. O módulo obtém a configuração em execução, o inventário ou outro estado; em seguida, a saída é normalizada e salva como texto.
A abordagem é frágil como qualquer automação de CLI. Um novo prompt quebra o script. O firmware muda a saída. Banners, paginação, autenticação e temporização diferem. Alguns dispositivos exigem Telnet ou suítes de cifras antigas. Módulos locais podem se afastar do upstream.
A longevidade mostra que a compatibilidade frequentemente nasce da adaptação, não de um padrão ideal. O RANCID não torna as CLIs iguais; ele cria um processo comum sobre as diferenças. O repositório torna-se a interface estável. O essencial: a memória deixa o dispositivo — mesmo com a perda total de um roteador, restam a última configuração e o histórico.
Orouter.dbtransforma o parque em um plano de coleta programado
O fluxo tradicional começa com orouter.db, que vincula hostnames, tipos e estados. Registros ativos tornam-se alvos. Grupos definem cronogramas, repositórios e áreas de responsabilidade. O arquivo é simples de revisar e versionar, mas decide quais dispositivos serão lembrados e quais permanecerão invisíveis.
A simplicidade torna os erros legíveis: um erro de digitação no nome, um tipo errado, um estado desabilitado. Mas ela não garante a integridade da cobertura. Um roteador ausente não é detectado automaticamente. Um equipamento desativado pode permanecer na lista. Um nome pode resolver para um endereço inesperado. A lista precisa ser conciliada com o registro de ativos ou com a fonte da verdade.
Quando orancid-runé executado, ele seleciona os alvos ativos, chama o login e a lógica do fornecedor, obtém a saída, compara e faz commit das mudanças significativas. Erros e novas tentativas fazem parte do serviço. Um dispositivo pode estar inacessível, a autenticação pode falhar, um comando pode retornar dados incompletos. Cada execução precisa de um status; a existência do arquivo não comprova que ele está atualizado.
Uma cópia antiga pode ser limpa e convincente. O operador precisa do horário da última coleta bem-sucedida, do número de falhas consecutivas e da confirmação de que todos os comandos esperados foram executados. Um arquivo sem monitoramento de atualização cria falsa confiança.
Os grupos permitem limitar o raio de impacto. Ambientes diferentes usam credenciais, frequências e repositórios diferentes; dispositivos críticos podem ser coletados com mais frequência ou a partir de hosts isolados. Mas orouter.dbnão é uma fonte de intenção — é um plano de coleta. A comparação com NetBox, Nautobot ou o registro de ativos revela dispositivos sem histórico e parques esquecidos.
O login via Expect tornou a automação possível e concentrou os segredos
As CLIs interativas foram projetadas para pessoas. Elas exibem banners, pedem usuário e senha, negociam o terminal, pausam a saída e mudam o prompt conforme o modo. O Expect espera um padrão e responde, transformando a conversa em uma sequência automatizada.
O RANCID usa esse modelo. As ferramentas abrem Telnet ou SSH, tratam os prompts, entram no modo privilegiado e executam comandos. Assim se automatizavam equipamentos muito antes das APIs orientadas a modelo.
O mecanismo cria uma concentração séria de risco. O coletor pode precisar de acesso a centenas ou milhares de dispositivos. As credenciais costumam estar descritas no.cloginrce protegidas por permissões do sistema de arquivos. Comprometer o host ou o arquivo dá ao atacante um mapa da frota e dados do plano de gerenciamento. Contas compartilhadas e privilegiadas ampliam as consequências.
Até o "somente leitura" depende da plataforma. Alguns dispositivos separam mal a exibição da configuração de comandos mais amplos. O repositório pode conter community strings, hashes, chaves, nomes de clientes e endereços internos. A filtragem ajuda, mas não garante ausência de segredos.
O host do RANCID deve ser tratado como um sistema privilegiado: segmentado, atualizado, com backup e monitorado. As contas devem ser restritas, rotacionadas e auditadas. SSH substitui Telnet sempre que possível. Algoritmos antigos são isolados, não permitidos em um host de gerenciamento universal. O acesso ao repositório segue o princípio do menor privilégio.
Os módulos de fornecedor traduzem uma saída instável em texto comparável
O RANCID não recebe uma configuração universal abstrata. Ele executa os comandos da plataforma específica, lê a saída e aplica parsers e filtros. O módulo sabe o que solicitar, quais linhas manter, como tratar os modos e como ordenar o resultado.
Esse conhecimento é um ativo operacional. As plataformas nomeiam interfaces, inventário, software e tabelas de rotas de formas diferentes. Algumas exibem uptime, timestamps e contadores. O módulo transforma a variedade em arquivos estáveis o suficiente para um diff útil.
A tradução pode falhar silenciosamente. Uma versão nova desloca uma linha, muda um cabeçalho ou exige outro privilégio. O parser continua funcionando, mas perde uma seção. Por isso, o sucesso deve incluir testes de conteúdo, não apenas o código de saída.
Suportar módulos exige acesso ao equipamento, exemplos e conhecimento de versões. Os forks locais resolvem o problema rápido e complicam as atualizações. A organização precisa conhecer seus patches, comparar com o upstream e testar o firmware antes da produção.
A normalização separa a mudança significativa do ruído de cada execução
A saída da CLI contém valores que mudam sem alteração de configuração: uptime, data, contadores, IDs de sessão, hashes criptografados, ordem das linhas. Se tudo for armazenado, cada execução gerará um diff e o sinal se afogará.
O RANCID remove ou mascara parte desses valores e estabiliza a ordem. O repositório mostra mudanças de política, de interface ou de acesso, em vez de um contador atualizado. Assim, o diff simples continua útil por anos.
Mas a normalização é uma decisão editorial em código. Filtragem insuficiente gera alertas constantes; filtragem excessiva esconde material para incidente ou auditoria. Um valor volátil pode se tornar importante na investigação de um reboot ou da rotação de chaves.
O operador precisa entender o que o módulo filtra. Mudanças no filtro devem ser tratadas como mudança de esquema, porque alteram a evidência que é salva. Para dispositivos especialmente críticos, é possível guardar uma saída bruta protegida separadamente e uma versão normalizada para comparação.
O controle de versões cria uma cronologia do texto, mas não um registro de transações
CVS, Subversion ou Git preservam versões, diffs e horários de commit. O arquivo mostra a evolução do texto observado e permite voltar a um estado antigo. Exportar, replicar e revisar são simples.
O commit não é uma transação no roteador. Seu autor normalmente é uma conta de serviço, não a pessoa que digitou o comando. O horário é o momento da coleta ou do commit, não necessariamente da alteração. Vários comandos caem em um único diff; as mudanças intermediárias não aparecem.
Por isso, a cronologia precisa ser cruzada com AAA, syslog, tickets, pipelines e eventos do dispositivo. O repositório oferece um eixo de tempo independente, porém incompleto. A força é o texto preservado; o limite é a ausência de intenção e de identidade transacional.
O Git não melhora a evidência automaticamente se o histórico puder ser reescrito, os relógios estiverem errados ou os commits não forem copiados. Retenção, proteção de branches, assinaturas e cópias imutáveis podem elevar o nível de garantia.
A coleta periódica deixa uma janela em que a mudança decisiva pode desaparecer
O RANCID observa snapshots. Entre duas execuções, uma pessoa ou a automação pode alterar o dispositivo, provocar um incidente e reverter a mudança. O repositório mostrará dois estados idênticos e perderá o evento-chave.
Reduzir o intervalo encurta a janela, mas aumenta sessões, carga, commits e sobreposição de tarefas. Alguns dispositivos toleram mal solicitações frequentes de CLI. Parques grandes precisam de cronograma e limite de concorrência.
Para o quadro completo, são necessários AAA, syslog, logs de orquestradores, commits de intenção, telemetria ou contabilidade de comandos. O RANCID permanece útil como verificação independente periódica.
A atualidade precisa ser visível. Cada dispositivo deve ter uma idade máxima aceitável e um alarme para falhas em série. Uma cópia de seis meses não é falsa; é testemunho de outro momento. A interface não deve apresentá-la como estado atual.
O host do RANCID pode expor todo o plano de gerenciamento
O coletor acumula credenciais, nomes, endereços, descrições, configurações e tipos de dispositivos. Comprometê-lo dá ao atacante tanto o mapa quanto o meio de acesso.
O repositório pode conter segredos mesmo depois da filtragem: communities, hashes, chaves, endereços de túnel, dados de clientes e políticas. Backups, espelhos Git e e-mails com diffs multiplicam as cópias. Cada armazenamento passa a fazer parte da superfície de controle.
A proteção precisa cobrir todo o caminho: host endurecido, segmentação do gerenciamento, contas somente leitura, permissões do.cloginrc, backups criptografados e restritos, e-mail protegido, logs de acesso e rotação. O acesso interativo deve ser raro e atribuível.
É preciso ter um plano de comprometimento do coletor. Reinstalar não basta: é preciso identificar e rotacionar todas as credenciais afetadas, localizar cópias e investigar sessões. A centralização melhora a auditoria cotidiana e aumenta o potencial de incidente.
O LibreNMS mostra o sintoma, o RANCID acrescenta contexto de configuração
O LibreNMS pode reportar queda de porta, perda de vizinho ou aumento de erros. O RANCID mostra a alteração da configuração relacionada. Juntos, eles aceleram o diagnóstico sem transformar correlação em causalidade.
As ferramentas têm cronogramas diferentes e podem perder eventos. Uma falha de hardware não necessariamente gera diff; um diff pode não ter efeito. É preciso alinhar o tempo, verificar a atualidade e acrescentar logs ou tickets.
A integração deve preservar a origem. O painel não deve mostrar um diff sem data e status da coleta. O arquivo não deve afirmar que explica um sintoma que não mediu. Juntos, oferecem uma história mais completa: o que aconteceu e o que o dispositivo reportava perto desse momento.
GitOps e fonte da verdade descrevem a intenção; o RANCID registra a resposta do dispositivo
Os sistemas modernos modelam inventário, endereços, serviços e políticas em dados autoritativos, geram configuração e aplicam mudanças por meio de revisão e testes.
O RANCID, depois ou em paralelo, lê o que o dispositivo realmente expõe. Ele confirma a aplicação da intenção, revela drift manual ou mostra que o sistema operacional do fornecedor normalizou o comando de forma diferente.
É perigoso transformar automaticamente a configuração coletada na nova intenção. O drift observado pode ser justamente um erro. Um processo maduro compara intenção e observação, explica a diferença e decide qual lado corrigir.
A independência do coletor tem valor de controle. Se o orquestrador, o repositório de intenções e o dispositivo compartilham o mesmo erro, uma leitura separada pode revelar o estado. Mas a independência precisa ser real: credenciais, parsers ou administradores compartilhados criam modos de falha comuns.
O Oxidized e os gerenciadores comerciais modernizam o fluxo, mas não eliminam a tarefa original
O Oxidized oferece uma arquitetura mais recente, APIs e integrações. As suítes comerciais acrescentam suporte, conformidade, orquestração e modelos de dados. Podem simplificar a operação e oferecer um contrato.
Nenhuma opção elimina a necessidade de obter a prova do que o dispositivo reporta. Elas apenas redistribuem o esforço entre código, licença, suporte e operações. A migração é avaliada pela cobertura, segredos, atualidade, filtros e retenção, não apenas pela modernidade da interface.
O RANCID pode continuar atendendo ao hardware legado enquanto outra ferramenta assume as plataformas novas. A coexistência temporária é mais segura do que um corte que perde anos de histórico. É preciso saber qual ferramenta responde por cada dispositivo e como as diferenças são conciliadas.
O diff por e-mail transforma o repositório em um fluxo de trabalho humano
O e-mail foi por muito tempo a camada de sinalização. Uma mudança gera um diff para uma lista ou equipe, inserindo a evidência em um canal familiar e permitindo revisão colaborativa.
O fluxo pode se tornar ruidoso. Normalização ruim, firmware verboso ou mudanças em massa criam um fluxo de e-mails que ninguém mais lê. As listas podem incluir pessoas demais, e o e-mail deixa cópias sensíveis fora do repositório.
Deve-se definir quais grupos recebem quais dispositivos, como os e-mails são classificados, como a mudança esperada se vincula a um ticket e qual resposta se espera diante da inesperada. Um diff não lido não é um controle.
Tickets, chat e pipelines podem substituir ou complementar o e-mail, mas a lógica é a mesma: a mudança de texto se converte em decisão humana. A automação pode acrescentar idade, janela de mudança e criticidade, sem decidir sozinha a legitimidade.
O looking glass mostra que até a leitura precisa de limites
O RANCID esteve historicamente ligado a funções de looking glass, que executavam comandos diagnósticos restritos. A ideia é útil: oferecer visibilidade sem acesso completo à CLI.
Mas "somente leitura" não significa "sem risco". Os comandos revelam topologia, rotas, políticas, nomes internos e relações de negócio. Uma entrada mal validada pode permitir comandos inesperados. Uma consulta pesada sobrecarrega o roteador. Os resultados podem se espalhar demais.
A interface deve restringir estritamente comandos, parâmetros, alvos e frequência, registrar o uso e, quando possível, usar credenciais separadas. A informação disponibilizada deve corresponder ao público.
A lição geral: o plano de gerenciamento contém dados sensíveis mesmo sem direito de alteração. A observação exige gestão tanto quanto a gravação.
A sustentabilidade repousa sobre um projeto canônico pequeno e muitas instalações invisíveis
O site canônico da Shrubbery Networks, no recorte, continuava apontando o RANCID 3.14 como versão atual, e a linha 3.14 era datada de 2025. Espelhos no GitHub e pacotes de distribuição existem, mas não substituem a fonte canônica de status.
Não há contagem auditada de instalações, orçamento ou lista completa de mantenedores. Grande parte do valor é invisível: instalações internas antigas, adaptações locais, pacotes, usuários que não participam publicamente.
A invisibilidade dificulta avaliar impacto e sucessão. Um software maduro pode funcionar por muito tempo com poucas mudanças, mas SSH, sistemas operacionais e saída de CLI evoluem. O conhecimento crítico pode estar concentrado em poucas pessoas.
Os usuários devem acompanhar versões, atividade do site, patches de distribuição, reação a relatórios, estado dos próprios módulos e capacidade de migração. Tranquilidade não significa abandono, mas também não deve ser considerada garantia sem verificação.
A migração deve preservar a evidência, não apenas trocar o coletor
Os repositórios podem conter anos de configurações, diffs, comentários e timestamps. Começar do zero interrompe a cronologia justamente quando ela é necessária, durante um incidente.
A migração define o formato de armazenamento, localiza os dispositivos antigos, concilia nomes e identidades e separa commits antigos e novos. Datas e branches precisam ser verificados.
Uma execução paralela em amostra é útil. As diferenças revelam comandos ausentes, filtros distintos e divergências de parser. Sucesso não é apenas conectar, mas preservar um campo de evidência equivalente e manter os erros visíveis.
As credenciais devem ser rotacionadas, não copiadas às cegas. Hosts antigos, backups, listas de e-mail e repositórios devem ser comprovadamente desativados. Segredos remanescentes aumentam o risco.
O texto de configuração não é o comportamento da rede
O arquivo pode parecer correto e o encaminhamento falhar. O comando pode ter sido parcialmente rejeitado, reescrito, sobreposto por estado dinâmico ou neutralizado pelo hardware. RIB, FIB, sessões, filas e estado físico não se reduzem ao texto.
Alguns módulos coletam saída operacional, mas o objeto principal é o snapshot textual. Para o comportamento, são necessários testes de alcançabilidade, telemetria, estado de protocolos e sondas ativas.
O inverso também vale: o comportamento parece normal e uma configuração perigosa aguarda a próxima falha. Por isso o diff importa — ele mostra a mudança estrutural antes ou depois do sintoma.
A interpretação correta liga intenção, configuração observada e runtime sem misturá-los. Cada um é uma pista separada. A investigação explica as coincidências e as lacunas.
O valor de auditoria depende da proveniência, da retenção e da explicabilidade do coletor
Para que o repositório sustente uma auditoria, é preciso explicar como os dados foram obtidos, com qual conta, com quais comandos, com que frequência, filtros e erros. Sem proveniência, um conjunto de arquivos não define cobertura.
A retenção precisa estar definida. Dispositivos e configurações antigos são necessários para investigações ou exigências, mas aumentam o risco de segredos e dados de clientes. Branches, backups e e-mails devem se submeter a uma política coerente.
Cópias imutáveis, controle de acesso, logs independentes e hashes elevam a integridade. Não tornam o arquivo infalível, mas dificultam alterações silenciosas e esclarecem a cadeia de custódia.
O coletor também se documenta: versão, módulos locais, mudanças de normalização e saúde. Caso contrário, os arquivos podem diferir porque o parser mudou, não o dispositivo. A auditoria precisa distinguir isso.
Equipamento legado mantém a necessidade de compatibilidade restrita
As redes mantêm dispositivos por mais tempo do que vivem os ciclos de ferramentas modernas. Alguns não têm gNMI, NETCONF confiável ou API. Continuam falando por CLI e, às vezes, por criptografia antiga. Enquanto carregarem tráfego, o estado precisa ser preservado.
O RANCID cobre esse nicho com módulos restritos. Isso não justifica exploração indefinida de hardware vulnerável. Pelo contrário, a ferramenta deve revelar a dívida: Telnet, algoritmos fracos, contas compartilhadas, módulos sem manutenção.
O isolamento é crítico. As exigências de um dispositivo antigo não devem enfraquecer o host de gerenciamento geral. Coletores separados, jump hosts e segmentação limitam o risco até a substituição.
A compatibilidade restrita torna-se um mecanismo de transição: preserva evidência e operação enquanto a saída é planejada, não um argumento contra a renovação.
Em muitos parques, os dispositivos novos oferecem telemetria estruturada, e os antigos continuam limitados à CLI e ao SNMP. O RANCID preserva os testemunhos para o segundo grupo, sem transformar a compatibilidade em afirmação de segurança ou de aptidão de longo prazo do equipamento.
Uma ferramenta estreita pode sobreviver a várias ondas de gerenciamento
O RANCID atravessou NMS, SDN, rede baseada em intenção, infraestrutura como código e GitOps. Sobreviveu não prometendo substituí-los, mas mantendo uma função restrita: obter o texto e mostrar a mudança.
Uma função estreita é fácil de explicar, verificar e migrar. Ela reduz a dependência de modelos proprietários. Texto e diff são lidos por ferramentas comuns, reduzindo o custo da continuidade.
A simplicidade torna-se fraqueza se novas plataformas, segurança ou sucessão não forem mantidas. A longevidade passada não garante o futuro. Cada organização verifica sua própria cobertura e plano de saída.
A lição não é que o simples é sempre melhor, e sim que a função essencial deve permanecer exportável e compreensível quando a grande plataforma muda.
O diff textual importa porque é uma evidência restrita e verificável
A grande vantagem do RANCID é não exigir fé em um modelo opaco. O arquivo mostra o texto obtido; o diff, as linhas adicionadas, removidas e alteradas; o histórico, as observações sucessivas. Um engenheiro pode verificar tudo com ferramentas comuns.
A legibilidade encurta a distância entre coleta e julgamento. O filtro pode ser contestado, a anomalia vista, a configuração antiga recuperada. O formato é portável entre produtos. Até o desaparecimento do RANCID não destruiria o repositório.
A evidência é restrita: um conjunto de comandos, um momento, um parser e um acesso. Ela não mostra tudo. Um limite explícito é mais saudável do que um painel que mistura observação, cálculo e conclusão sem origem clara.
O valor estratégico surge na independência em relação à intenção. A organização pode ter um pipeline moderno e manter o RANCID como testemunha. Uma alteração manual, uma falha do orquestrador ou uma diferença de fornecedor ganham um ponto de comparação.
O custo é real: credenciais, módulos, armazenamento, tratamento de erros e exposição de segredos. A questão não é a obsolescência do diff, e sim se o valor investigativo supera o custo e se os controles correspondem ao risco.
O teste final é simples. Depois do próximo incidente, a equipe conseguirá nomear a última mudança observada, o horário da coleta bem-sucedida, explicar as omissões do módulo e ligar o diff à intenção e aos eventos? Se sim, a ferramenta da era da CLI continua sendo infraestrutura útil de conhecimento.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance