摘要
- Pinkerton 的 1994 年原始论文记载,WebCrawler 的公开索引覆盖逾 9000 台服务器上的近 5 万份文档,每天回答 6000 多次查询,索引每周更新。
- 同一软件另有按查询实时追索模式:从索引中的相关结果出发,沿未访问的链接抓取新页面,再重新运行查询。Pinkerton 明确说这项模式没有向公众开放,因为让每个用户单独抓取会把负担推给网络。
抓一次,答许多次
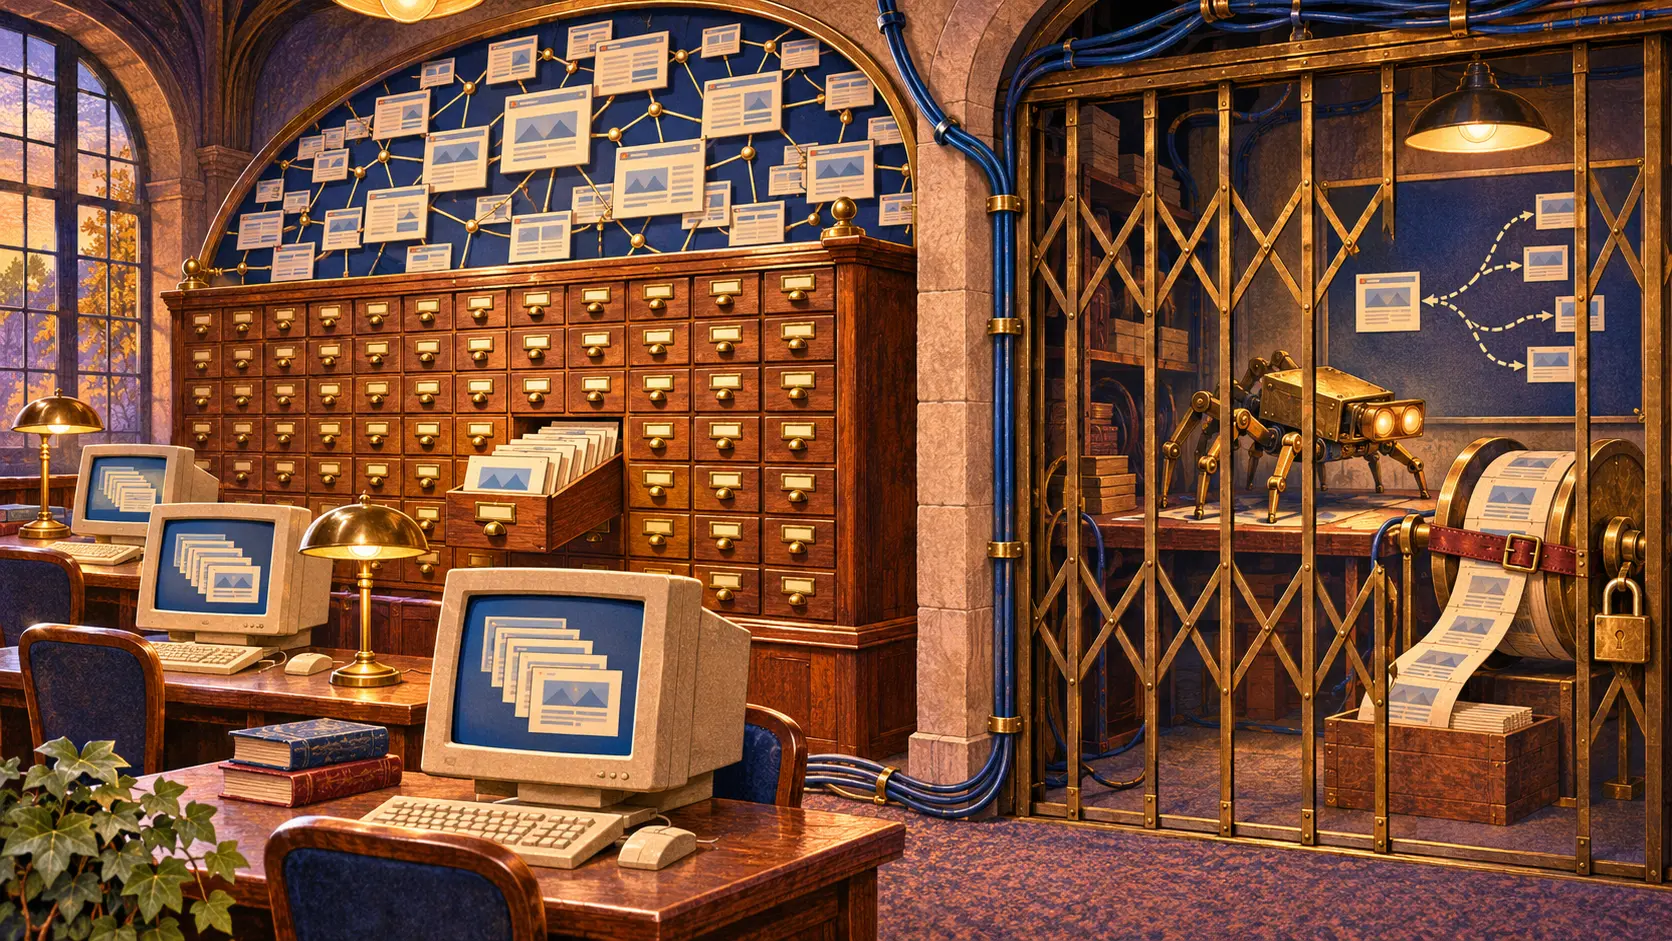
搜索引擎可以提前读完一批网页,做成公共目录,让后来的读者反复查询。它也可以等人提出具体问题,才出门寻找还没看过的页面。WebCrawler 的程序里,两条路都存在;公众看到的却是第一条。用户面对的是已经建好的全文索引,查询服务器从储存的文字中找结果,返回按相关性排列的标题和网址。
这份索引从来没有假装自己收尽所有网页。Pinkerton 在芝加哥会议发表的论文解释,机器人从已知页面出发追踪链接;每发现一台新服务器,会先取回它的一份文档,之后再逐步深入。系统同时保存全文索引和网页、链接、服务器构成的关系图。抓到一页,它记录访问、抽取外链、读入标题与正文。优先触达更多服务器,是有限储存空间下的取舍。
论文给出的当时规模是近 5 万份文档、逾 9000 台服务器、每日 6000 多次查询,以及每周一次的索引更新。这些是 1994 年那套服务的运行快照,不能拿来当整个万维网的总量。新页面可能要等下一轮抓取,深处的页面也可能根本排不上队。然而同一份已抓取页面,可以为许多毫不相识的读者回答不同问题,不必每次都再向原站要一份。
读正文尤其划算。Pinkerton 说,他的机器人访问过的文档中有 20% 没有标题。只靠标题建目录,就会错过这些页面的内容,也会被含糊标题牵着走。全文索引要占用本地磁盘与处理时间,却把单次抓取的价值分给后来的大量查询。索引不只是搜索功能,也是分摊网络成本的办法。
那个跟着问题跑的机器人
另一种模式从用户的查询开始:先在现有索引中找相近文档,再去追随它们尚未探查的链接。新页面进入索引后,系统重新运行同一个查询;若新结果值得继续挖,机器人再沿下一条链接前进,直到找到足够多相近文档或耗尽时间。Pinkerton 还尝试比较链接文字与查询词,把更可能相关的路径放在前面。
这个实验给索引的空白开了一个出口。一份每周更新的目录可能漏掉昨天刚出现的材料;实时追索可能顺着合适的链接把它找出来。Pinkerton 写道,实验中的搜索速度快、方向也较准。他紧接着说明:公众不能使用这项实时搜索。公开网站每天数千次查询用的是共同索引,并没有给每个提问者放出一只私人机器人。把二者混为一谈,就看不见当年决定产品边界的成本。
建公共索引时,WebCrawler 把访问分散到不同服务器。Pinkerton 估计,广泛爬取一轮时,每台服务器最密也可能隔数小时才遇到一次访问。索引建成后,许多人复用同一结果。私人实时搜索则会为单个读者派出抓取进程。若成千上万人同时这样做,远端站点可能一遍遍为不能共享的结果送出页面。Pinkerton 判断,以当时的网络承载能力,向公众广泛开放客户端发起的搜索还不现实。
这是一笔有得有失的账。共享索引回答得快,资料却会陈旧;私人追索可能更快找到新页,外部站点却要替每个读者承担新的请求。Pinkerton 考虑过让私人搜索的发现回流到主索引,使一次探查惠及后续用户。论文将它列为将来的工作,而不是已上线的功能。先问谁付账,再决定机器人能走多远,是这篇技术论文最有现实感的一页。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限战略圈层会员
战略圈层
所有读者均可浏览。加入并登录后可解锁档案简报。
加入战略圈层仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance