الخلاصة
- وصف بحث Pinkerton الأصلي عام 1994 فهرس WebCrawler العام: قرابة 50 ألف وثيقة على أكثر من 9 آلاف خادم، وأكثر من 6 آلاف بحث يومياً، مع تحديث أسبوعي.
- استطاع البرنامج أيضاً إجراء بحث فوري يبدأ من الفهرس ويتبع روابط جديدة ويضيف ما يجده ثم يعيد البحث. وكتب Pinkerton صراحة أن هذا الوضع لم يكن متاحاً للعموم، لأن إطلاق رحلات فردية لعدد كبير من المستخدمين كان سيزيد عبء الشبكة.
فهرس واحد لآلاف الأسئلة
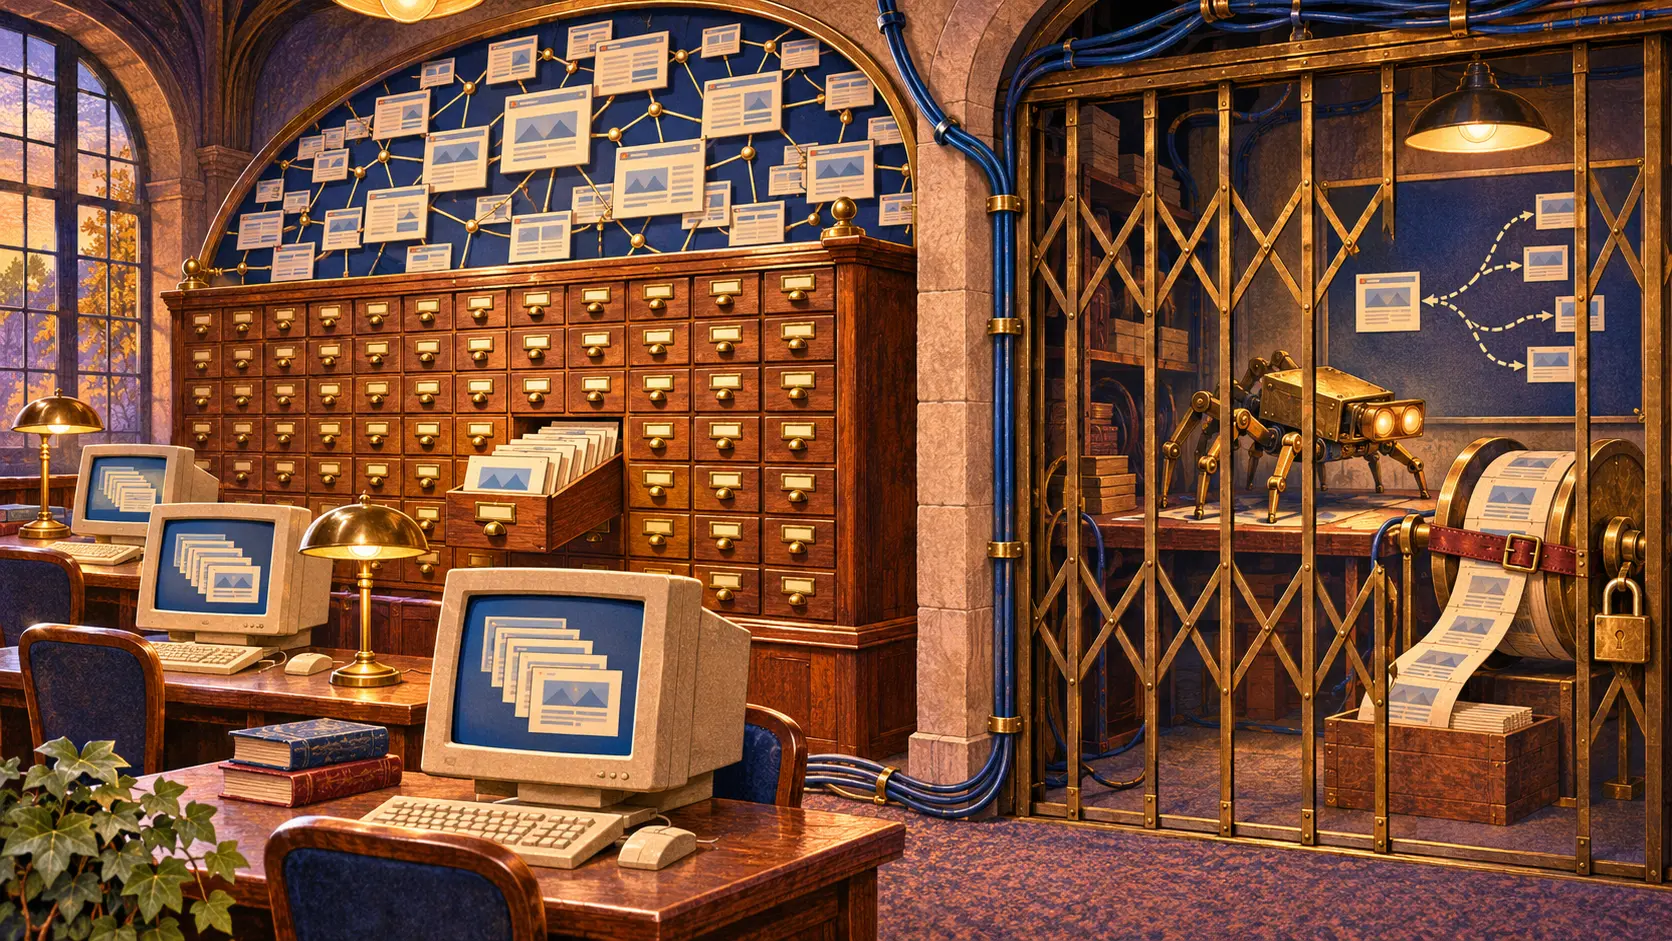
للبحث في الويب خيار يتعلق بموعد دفع كلفة القراءة. يستطيع البرنامج أن يجلب الصفحات مسبقاً ويخزن كلماتها، ثم يتيح للجمهور سؤال قاعدة البيانات. ويستطيع انتظار سؤال بعينه قبل الخروج وراء صفحات جديدة. جمع WebCrawler الطريقتين في البرنامج، لكن واجهته العامة استخدمت الفهرس الجاهز. كان خادم الاستعلام يعثر على كلمات محفوظة ويرد بعناوين الصفحات وروابطها مرتبة بحسب الصلة.
شرح البحث المقدم إلى مؤتمر شيكاغو كيف بُني هذا الفهرس. انطلق الروبوت من صفحات معروفة وتتبع روابطها؛ وكلما وجد خادماً جديداً أخذ منه وثيقة مبكراً قبل التوسع في خادم قديم. حفظ فهرساً كاملاً للكلمات وخريطة للوثائق والروابط والخوادم. وعند استرداد صفحة كان يسجل الزيارة ويستخرج الروابط الخارجة ويفهرس العنوان والمتن. كان الهدف توزيع الزيارات على خوادم كثيرة مع قبول أن المساحة المتاحة لن تستوعب كل صفحة.
أورد Pinkerton أرقاماً تخص خدمته آنذاك: قرابة 50 ألف وثيقة موزعة على أكثر من 9 آلاف خادم، وأكثر من 6 آلاف سؤال كل يوم، وتحديث الفهرس مرة في الأسبوع. تلك صورة تشغيلية من 1994، وليست عدّاً لكل الويب. الصفحة الجديدة قد تنتظر دورة الجمع التالية، وقد لا يصل الروبوت إلى صفحة بعيدة في سلسلة الروابط. ومع ذلك فإن جلب وثيقة واحدة ثم حفظ كلماتها يسمح لكثير من الناس بالسؤال عنها من دون مطالبة خادمها بإرسالها لكل شخص من جديد.
قراءة المتن كله رفعت قيمة الزيارة. قال Pinkerton إن 20% من الوثائق التي زارها الروبوت لم تكن تحمل عنواناً. لو اقتصر الفهرس على العناوين لضاعت موضوعات تلك الصفحات ولأصبحت العناوين الضعيفة حاكمة للعثور عليها. الفهرسة الكاملة تستهلك قرصاً وعملاً حسابياً محلياً، لكنها توزع كلفة الجلب الشبكي على عمليات بحث كثيرة. كانت قاعدة البيانات المشتركة أداة توفير بقدر ما كانت أداة اكتشاف.
روبوت آخر يلاحق السؤال
بدأ الوضع التجريبي الآخر بالبحث عن صفحات قريبة من كلمات المستخدم داخل الفهرس. ثم اتبع روابطها التي لم تُزر من قبل، وجلب صفحات جديدة، وأدخلها في الفهرس، وأعاد تنفيذ السؤال. الصفحات الجديدة ذات الصلة العالية قد تفتح مساراً آخر، حتى يجد ما يكفي أو تنتهي المهلة. جرّب Pinkerton أيضاً مقارنة كلمات الرابط نفسه بالسؤال لتفضيل فرع واعد على مسار عشوائي.
كانت الفكرة مغرية لأن فهرساً يُحدَّث أسبوعياً يترك فراغات. البحث الفوري قد يعثر على صفحة نُشرت قبل قليل إذا قاده إليها رابط مناسب. كتب Pinkerton أن تجاربه كانت سريعة وموجهة جيداً. وفي النص الأصلي نفسه قال إن هذا البحث غير متاح لمستخدمي الخدمة العامة. آلاف الأسئلة اليومية كانت تُجاب من الفهرس المشترك؛ لم تكن كل واحدة تطلق روبوتاً خاصاً. الفارق بين النمطين هو قرار تشغيل لا تفصيل مخفي في الشيفرة.
في وضع بناء الفهرس تتوزع الزيارات على الخوادم. قدّر Pinkerton أن خادماً واحداً قد يرى طلباً كل بضع ساعات في مسح واسع، ثم يُعاد استخدام ما جُمع لقراء كثيرين. أما طلب شخصي فيستدعي برامج جلب لصناعة نتيجة لذلك الشخص وحده. إذا كرره عشرات الآلاف، قد تتلقى الخوادم طلبات متشابهة مرة بعد أخرى من دون فائدة مشتركة. لذلك رأى Pinkerton أن تعميم البحث الذي يبدأه كل عميل غير عملي على الشبكة المتاحة وقتها.
أبقى هذا القرار ثغرة في التجربة العامة. الفهرس الأسبوعي سريع عند الإجابة، لكنه قد يفوّت جديد الويب. والروبوت الفوري يستطيع سد بعض النقص على حساب خوادم المواقع التي يزورها. فكر Pinkerton في إعادة اكتشافات الباحثين الأفراد إلى الفهرس الرئيسي ليستفيد منها القادمون لاحقاً. وضع الفكرة في باب العمل المقبل، لا في قائمة خصائص الخدمة العامة. لم تكن المشكلة قدرة الروبوت على السير، بل عدد المرات التي يمكن مطالبة الآخرين بتمويل سيره.
إحاطة الأعضاء
سياق أعمق للملف الشخصي
سجّل الدخول بمستوى العضوية المناسب لفتح الإحاطة الكاملة وملاحظات المصادر.
للدائرة الاستراتيجية فقط
الدائرة الاستراتيجية
مفتوح لجميع القراء. افتح إحاطات الملف الشخصي بعد الانضمام وتسجيل الدخول.
انضم إلى الدائرة الاستراتيجيةلأعضاء تحالف القيادات فقط
تحالف القيادات
لأصحاب الأصول الفكرية المؤهلين وللإدارة؛ سجّل الدخول للوصول إلى إحاطات التحالف.
انضم إلى تحالف القيادات