Zusammenfassung
- Brian Pinkerton beschrieb im Originalaufsatz von 1994 einen öffentlichen Index mit fast 50.000 Dokumenten auf über 9.000 Servern. Er beantwortete täglich mehr als 6.000 Anfragen und wurde wöchentlich erneuert.
- Die Software konnte auch in Echtzeit von Index-Treffern aus unbekannte Links verfolgen, neue Dokumente aufnehmen und erneut suchen. Pinkerton schrieb ausdrücklich, dass dieser Modus nicht öffentlich verfügbar war: viele individuelle Suchroboter hätten das Netz belastet.
Ein Vorrat für viele Leser
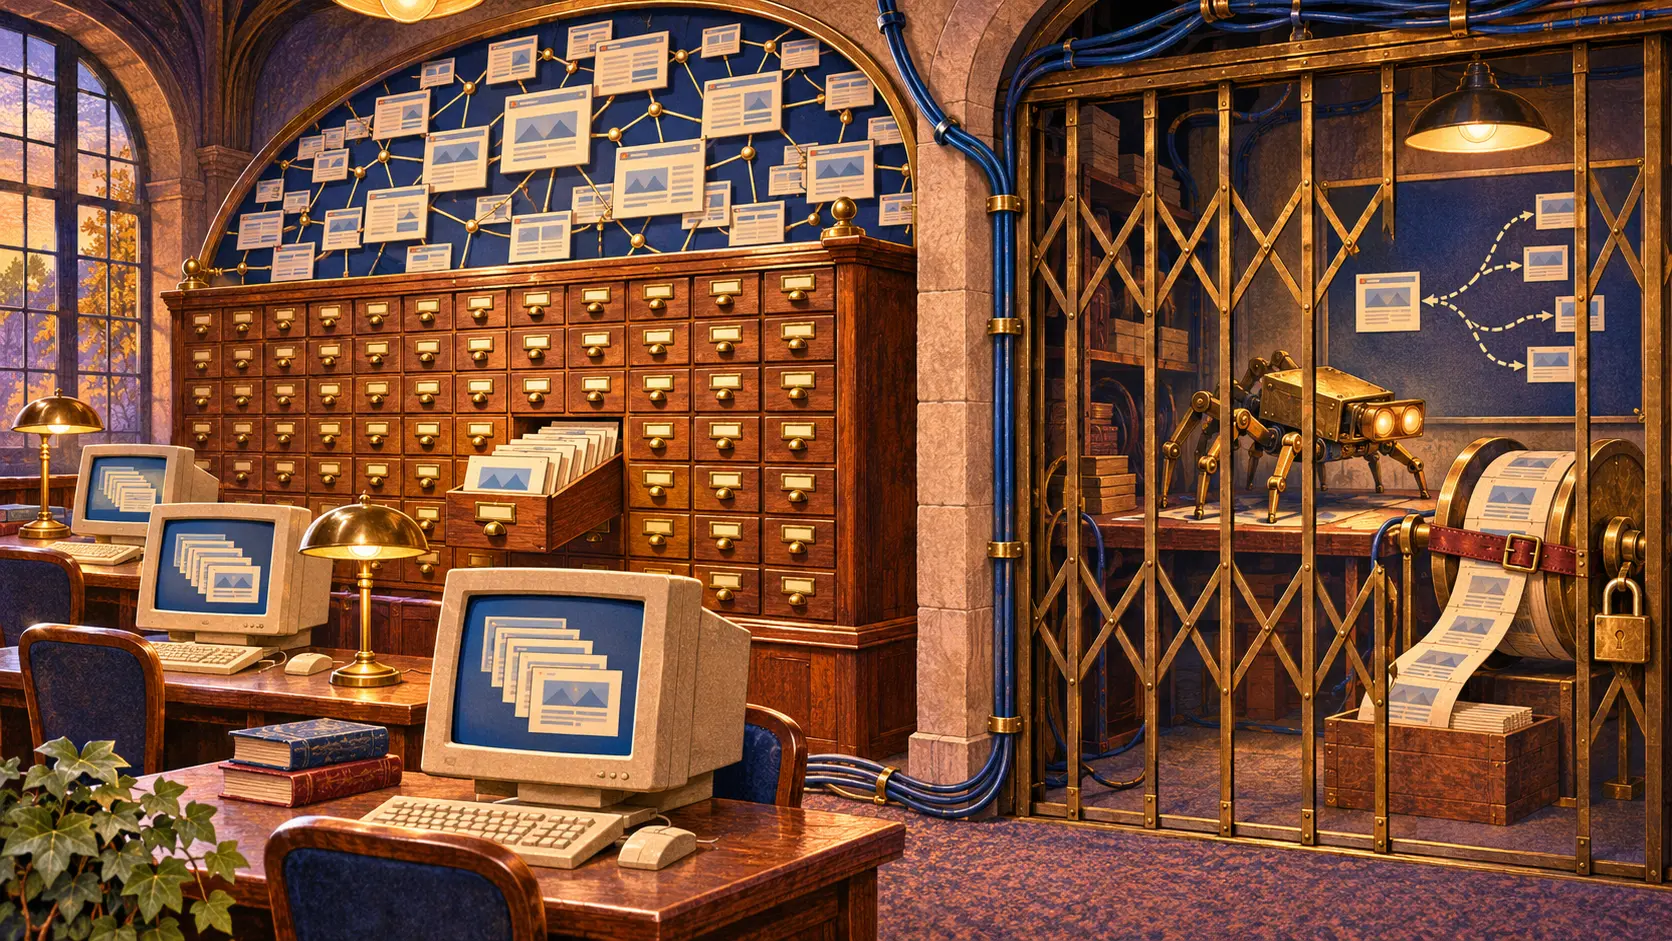
Eine Suchmaschine kann Seiten vorab lesen und ihre Wörter speichern. Spätere Fragen werden dann aus demselben Bestand beantwortet. Sie kann auch warten, bis eine Frage kommt, und erst dann neue Seiten aufsuchen. WebCrawler enthielt beide Wege. Die öffentlich erreichbare Suchseite benutzte den ersten. Ihr Query Server suchte in gespeicherten Texten und lieferte geordnete Titel und URLs zurück.
Wie der Bestand entstand, steht in Pinkertons Konferenzbeitrag. Der Roboter folgte Links von bekannten Dokumenten. Fand er einen neuen Server, holte er dort bald mindestens eine Seite, bevor er bekannte Server weiter vertiefte. Seine Datenbank enthielt einen Volltextindex sowie ein Modell von Dokumenten, Links und Servern. Nach dem Abruf einer Seite markierte WebCrawler den Besuch, sammelte ausgehende Verweise und indizierte Titel und Inhalt. Breite Abdeckung hatte Vorrang vor der vollständigen Erkundung einzelner Orte.
Pinkerton nannte fast 50.000 Dokumente auf mehr als 9.000 Servern, über 6.000 tägliche Anfragen und einen wöchentlichen Indexlauf. Das war eine Betriebsaufnahme von 1994, keine Zählung des gesamten Webs. Neue Seiten konnten bis zur nächsten Runde warten. Tiefer liegende Seiten blieben möglicherweise unbesucht. Aus den bereits geholten Seiten konnte der öffentliche Dienst dennoch wieder und wieder Antworten ziehen, ohne jeden Ursprungsserver für jedes neue Wort erneut zu fragen.
Der Volltext machte den einmaligen Abruf wertvoll. Pinkerton berichtete, dass 20 Prozent der besuchten Dokumente keinen Titel hatten. Ein auf Überschriften beschränkter Dienst hätte den Inhalt dieser Seiten kaum erschlossen. Das Speichern ganzer Texte kostete auf WebCrawlers eigener Maschine Platz und Rechenzeit. Den Netzwerkabruf einer Seite konnte der Betreiber dafür über viele Fragen verteilen. Der Index war zugleich Suchwerkzeug und Methode, eine geteilte Ausgabe nutzbar zu machen.
Der zweite Weg ging einer Frage nach
Im experimentellen Echtzeitmodus fragte WebCrawler zuerst den vorhandenen Index. Er nahm passende Ergebnisse als Ausgangspunkt und folgte von ihnen aus noch unbekannten Links. Neue Seiten wurden aufgenommen, die Anfrage erneut ausgeführt und weitere aussichtsreiche Treffer als Startpunkte gewählt. Der Prozess endete bei genügend ähnlichen Dokumenten oder nach einer Zeitgrenze. Pinkerton untersuchte auch den Text der Links, um eher relevante Wege zu wählen statt blind jede Abzweigung zu nehmen.
Eine wöchentlich aktualisierte Datenbank hat Lücken. Der zweite Weg hätte manche davon genau im Moment der Frage schließen können. Pinkerton hielt seine Versuche für schnell und gut ausgerichtet. In derselben Primärquelle stellte er klar, dass die Echtzeitsuche nicht für das Publikum offenstand. Die Tausenden täglichen Abfragen des öffentlichen Dienstes starteten keine Tausenden privaten Expeditionen. Sie nutzten den gemeinsamen Vorrat.
Der Unterschied lag bei den Empfängern der Netzlast. Beim Aufbau des Index verteilte WebCrawler Besuche auf viele Server; Pinkerton schätzte, dass ein Server bei einem breiten Lauf höchstens alle paar Stunden einen solchen Zugriff sah. Die Ergebnisse blieben für kommende Leser gespeichert. Eine persönliche Suche schickte Abrufprogramme für eine einzelne Antwort los. Wenn Zehntausende Nutzer das gleichzeitig täten, müssten fremde Server wiederholt Seiten für Ergebnisse liefern, die kaum jemand sonst verwenden könnte. Pinkerton sah die breite Freigabe dieser Client-Suche unter den damaligen Netzbedingungen als unpraktisch an.
Die Sperre hatte einen Preis. Ein gemeinsamer Index antwortet schnell, verpasst aber Neuigkeiten zwischen seinen wöchentlichen Aktualisierungen. Ein Roboter auf Anfrage könnte einem aktuellen Link folgen und eine frische Seite entdecken. Dafür müsste der Ursprungssite erneut liefern. Pinkerton erwog, Funde aus individuellen Suchen dem gemeinsamen Index zurückzugeben, damit eine Erkundung später vielen hilft. Der Aufsatz nennt dies als künftige Arbeit. Die ausgelieferte öffentliche Funktion war weiterhin der geteilte Bestand.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für den Strategischen Kreis
Strategischer Kreis
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategischem Kreis beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten