摘要
#后的片段在请求资源前就与地址分开,由客户端依照收到的内容类型来解释。- 从 HTML 锚点到纯文本的字符、行区间,片段让写链接的人指向文档内部,而不必等待服务器为每一段另开入口。
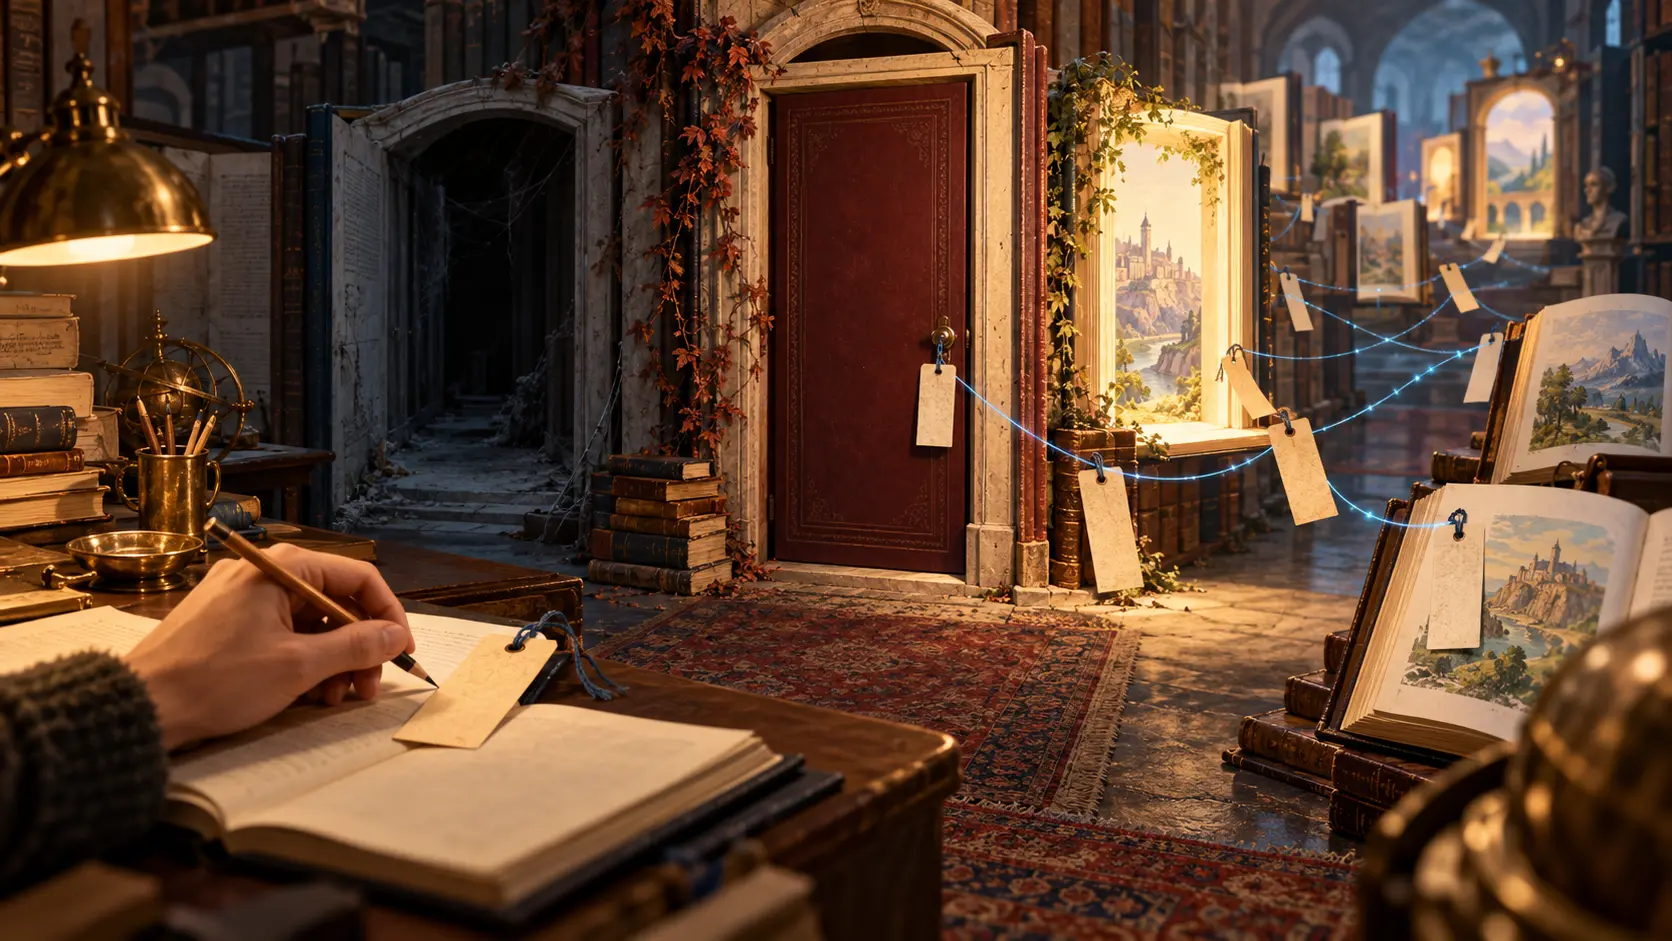
把一篇三万字的网页甩给朋友,再说“重点在里面”,跟把人带到图书馆门口就挥手告别差不多。地址末尾加上 # 和目标,就像夹进一枚书签:服务器仍送来整份文档,浏览器负责翻到你指的地方。改变读者视线的那个小动作,发生在客户端。
1995 年 6 月的 RFC 1808已经把这条分工写进相对 URL 的解析步骤。解析器遇到 #,先把它和后续片段取出,再处理余下的 URL。同年的 HTML 2.0 规范 RFC 1866给出最熟悉的用法:#fragment可以指向同一文档的锚点;在当时的 HTML 中,它对应 NAME 值相同的 A 元素。服务器回答“这是这份文件”,浏览器接着回答“你要看的位置在这里”。
Tim Berners-Lee 在1997 年 4 月的 W3C 架构笔记里把接力过程拆开:客户端取得资源的某种表示,再把片段交给懂这种媒体类型的软件;HTTP 服务器不会收到片段。他还提醒,fragment 这个名字容易把人带偏。# 后面可以表示一部分、一种视图,甚至由文件格式定义的其他对象。翻到某个段落很常见,却不是语法能做的全部。
2005 年的 URI 通用语法 RFC 3986进一步讲清它为何重要。片段通过主资源间接标识一个次级资源;怎么解释,取决于最终得到的表示及其媒体类型。规范指出,这种客户端侧的间接引用,让写链接的人有能力挑出既有内容中的某个方面,而无须等发布者替每个段落都建一条新的服务器路径。发布者决定文档长什么样,引用者也能决定把读者带到其中哪里。
这项能力后来走出 HTML。2008 年的 RFC 5147为 text/plain 文件定义了按字符位置、行位置及区间定位的片段。纯文本没有 HTML 的命名锚点,却有行和字符。客户端据此也能把一个地址解释成指向某段内容的路标。相同的 #,遇到不同类型的材料,就拿出不同的地图。
现行 HTTP 语义 RFC 9110继续维持传输界线:HTTP 请求的目标 URI 不包含片段。源站收到的是对主资源的请求,读者端负责处理地址最后的定位信息。文档若改动,锚点或行号可能失效;书签的准确性依赖它所指的内容。这个脆弱性也解释了为什么稳定的段落标识值得认真维护。
井号只有一个字,却给网页引用增加了第二层作者。第一层把文档放上网,第二层写下“请从这里开始”。没有它,许多讨论只能停在文章首页,再让别人自己找证据。有了它,一个人可以把另一人直接带到论点、表格、注释所在的位置。服务器给了书,读者也有权放自己的书签。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance