
摘要
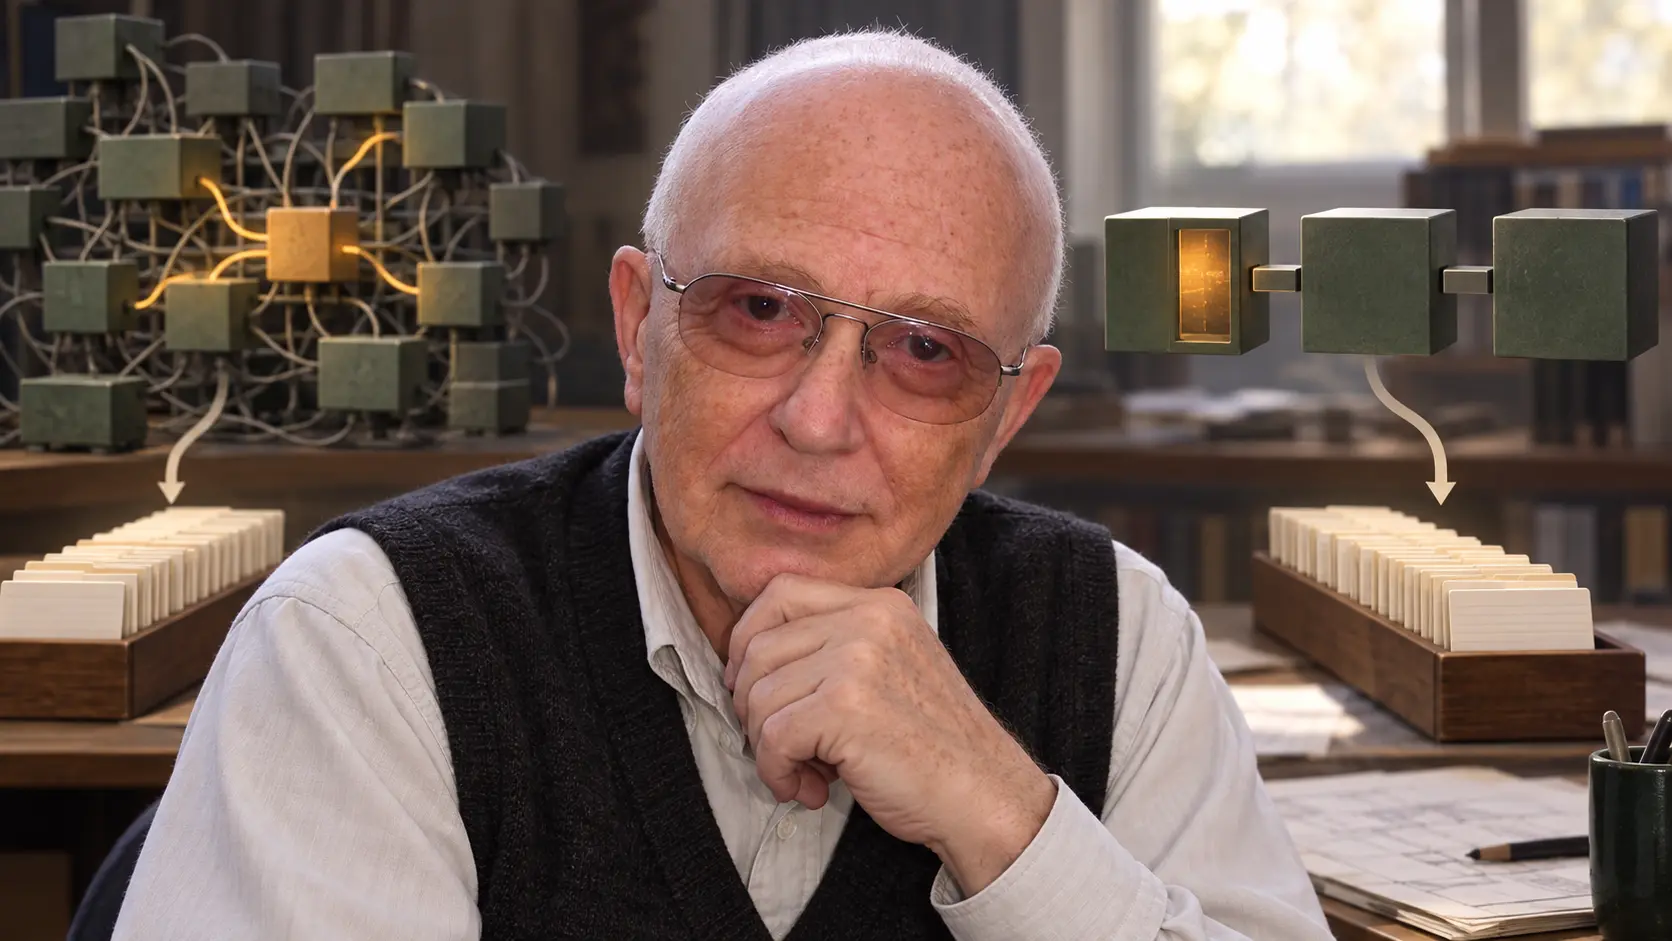
- Parnas 并列了两套都能工作的 KWIC 分解:一套按输入、移位、排序、输出的处理步骤分工;另一套把可能变化的存储、移位和排序决定分别交给模块。两者甚至可能使用相同算法并生成相同的可执行表示。
- 变化清单给出了实质差异:不再把全部行留在内存,或改变字符打包方式,会波及第一套设计的所有模块,却只涉及第二套的 Line Storage;改变循环移位表示,前者涉及三个模块,后者只涉及 Circular Shifter。
- 信息隐藏限制的是“谁必须知道某项设计决定”,不是保密、权限、加密、运行时隔离或面向对象的别名。接口仍可能泄露过多信息,模块边界也不会自动带来更高性能。
先让验收结果打平
KWIC 是 Key Word in Context 的缩写。H. P. Luhn 在 1960 年发表过这种自动索引方法:把关键词置于标题上下文中,便于机械生成更新及时的检索入口。Parnas 没有发明 KWIC;他选择了一个足够小、人人都能看懂的既有问题,来比较不同分解准则。
简化后的系统读入若干行,把每行的首词不断移到末尾,得到全部循环移位,再按字母序输出。Parnas 估计优秀程序员一两周就能完成它。也正因为小,设计决定藏在哪里才容易被看见。
1972 年论文明确说,两套方案都能工作。它们可以共享数据表示和算法,组装后的可执行程序甚至可能完全相同。差别存在于修改、记录和理解系统时所使用的表示:工作怎样分配,接口携带了哪些决定,某项决定变化后谁必须跟着改变。
因此,今天若用测试演示这篇论文,第一步应当故意让两套实现的输出一致。那只是解释性装置,不是声称 Parnas 当年运行过现代测试框架。真正的架构测试从绿灯之后开始:换掉一项存储或算法决定,再数有多少模块、测试和责任人需要重写自己的判断。
按时间顺序切出的模块
第一套分解沿处理流程展开。Input 读入并保存文本;Circular Shift 建立移位索引;Alphabetizing 对索引排序;Output 格式化结果;Master Control 安排执行顺序。
它看上去已经模块化,每个步骤也足够小。然而接口中包含内存布局、共享数组、指针和表格式。Input 把四个字符打包进一个机器字;后续模块知道此前数组的具体形态;Output 同时使用 Input 与 Alphabetizing 产生的数据。
流程被分开了,表示知识却散布在接缝中。流程图给出了控制边界,却没有给出变化边界。
第二套分解从可能变化的决定出发。Line Storage 独占行的内部表示,只提供访问字符、词和行的操作。Circular Shifter 让调用者看到“一组移位行”,但无需知道这些行是预先保存、通过索引表示,还是在请求时计算。Alphabetizer 掌握排序策略,Input 与 Output 使用这些抽象服务。
这里的 module 是责任分配,不等于 subroutine。一个模块可以包含多项可调用操作;最终程序也可以把来自不同模块的代码组装在一起。类、包、进程、仓库或团队都可能承载这种边界,但名称本身不会自动隐藏决定。
五项变化把代价摊开
输入格式改变时,两套方案都只需要修改 Input。Parnas 并没有把传统方案描写成每一项都失败。
当系统不能再把全部行留在内存中,第一套方案的每个模块都使用共享的行格式,因此全部受影响。第二套方案只有 Line Storage 知道行究竟驻留内存、分块读取还是采用其他表示。同样,取消“四字符一个机器字”的打包方式,前者仍要改遍所有模块,后者只改 Line Storage。
循环移位也可以换表示:完整存储每条移位行,只保存原行与偏移的索引,或者按需计算字符。在第一套方案中,Circular Shift、Alphabetizer 与 Output 都知道这个决定;第二套把它限制在 Circular Shifter。
排序的时机也可改变:一次性完成、需要时再寻找下一项,或把工作分散到整个索引生成期。第一套的 Output 期待一个已完成的索引。第二套则不允许调用者观察排序到底何时发生,于是变化留在 Alphabetizer 内部。
信息并没有凭空消失。它被交给一个明确的所有者,而其他模块失去了依赖该决定的资格。
有接口,不代表隐藏得好
论文对第二套方案也有一段关键自我批评。Circular Shifter 的接口规定:较早输入行的移位排在前面;每一行又必须先出现原句,再出现逐词旋转。调用者其实不需要这个顺序。它排除了“直接按字母序生成移位、让 Alphabetizer 近乎空操作”的实现。
Parnas 把这称为设计错误。存储或计算方法虽然藏住了,不必要的顺序保证却泄露出来。由此可见,把字段改成私有、再套一层 getter,并不等于完成信息隐藏。方法名、返回形状、枚举顺序、时间保证和错误分类,都可能复制内部实现的波动。
接口评审应追问的不是“有没有封装”,而是“每一项公开事实是否真有调用者必须依赖”。
隐藏的不是秘密
“信息隐藏”很容易被误读成安全术语。它不是访问控制、加密、沙箱或进程隔离。秘密数据即使受到严密保护,其模式仍可能迫使每个模块理解;完全公开的决定也可以被良好地限制在一个编程接口之后。
它也不是面向对象的同义词。抽象数据类型、类与封装机制可以帮助保护表示,也可能把持久化格式、处理顺序或易变分类法全部暴露出去。内聚与耦合是后来常用的评价词,但仍不能取代“究竟隐藏哪项决定”这一问题。
编译依赖与知识依赖同样不同。库变化后,客户端可能被机械重编译,却无需修改源码或推理;两个服务可以各自部署,却共同依赖一条未写明的排序惯例。运行时性能也不是免费收益。Parnas 明确警告,若把每次细粒度操作都实现为复杂的过程调用,第二套方案可能更慢,并提出代码插入或专用转移等实现思路。边界设计不能替代性能工程。
经典案例也会漏掉决定
在后来的自述中,Parnas 指出原 KWIC 设计仍让各模块知道“字符串是一串字符”。这个共享假设会妨碍把常见字符串压成整数表示。一个著名的信息隐藏案例,仍然没有一次找全所有值得隐藏的决定。
这恰好阻止原则变成仪式。画出模块框图并不是证据;设计者只能在不确定中判断哪些决定会变,并持续检查接口是否泄露了新的依赖。
历史也不是单人直线。Parnas 1971 年关于信息分布的论文,把模块连接描述为彼此作出的假设。1976 年的程序族工作把视野扩展到一组相关版本。1985 年,Parnas 与 Paul C. Clements、David M. Weiss 共同发表 The Modular Structure of Complex Systems,区分模块结构、使用结构与进程结构,并以模块指南帮助维护者只阅读真正相关的部分。
此后,软件架构社群又用 KWIC 比较共享数据、管道过滤器、事件驱动等风格。抽象数据类型、封装、架构描述与产品线方法继续拓展讨论。不能把这些后来的发展倒写成 1972 年原文,但可以保留那项最耐用的实验:固定外部输出,扰动一项决定,观察“必须知道”传播了多远。
来源
- David L. Parnas,《On the Criteria To Be Used in Decomposing Systems into Modules》
- David L. Parnas,《Information Distribution Aspects of Design Methodology》
- David L. Parnas,《On the Design and Development of Program Families》
- Parnas、Paul C. Clements 与 David M. Weiss,《The Modular Structure of Complex Systems》
- Peter J. Denning 对 David Parnas 的访谈
- David Garlan 与 Mary Shaw,《An Introduction to Software Architecture》
- H. P. Luhn,《Key word-in-context index for technical literature》
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance