
Résumé
- Les deux systèmes KWIC de Parnas pouvaient employer les mêmes algorithmes et aboutir à une représentation exécutable identique. Ce qui changeait était la distribution du savoir nécessaire pour les modifier.
- Dans le découpage par étapes, modifier le stockage des lignes ou le paquetage des caractères touchait tous les modules ; dans le découpage par décisions, Line Storage absorbait seul ces changements.
- La dissimulation d’information n’est ni du secret, ni du chiffrement, ni un synonyme de l’orienté objet. Une interface peut révéler trop de détails, et la séparation peut même coûter en performance si elle est implémentée naïvement.
Le test décisif vient après le résultat correct
Le problème KWIC, pour Key Word in Context, n’était pas une invention de circonstance. H. P. Luhn avait publié en 1960 une méthode d’indexation automatique qui plaçait un mot-clé dans le contexte de son titre. Parnas en a retenu une version assez petite pour que l’architecture reste visible : lire des lignes, former leurs rotations circulaires, les classer, puis les imprimer.
Son article de 1972 commence par une concession souvent perdue dans les résumés : les deux découpages fonctionnent. Ils peuvent partager algorithmes et représentations de données, voire donner, après assemblage, le même programme exécutable. La différence se trouve dans les formes utilisées pour comprendre, documenter et changer le système.
Supposons donc que les tests d’acceptation soient tous verts. Remplaçons ensuite une représentation. Combien de responsables doivent-ils apprendre la nouvelle règle ? Combien d’interfaces, de tests et de raisonnements deviennent caducs ? C’est cette propagation qui révèle la structure.
Un premier découpage calqué sur le déroulement
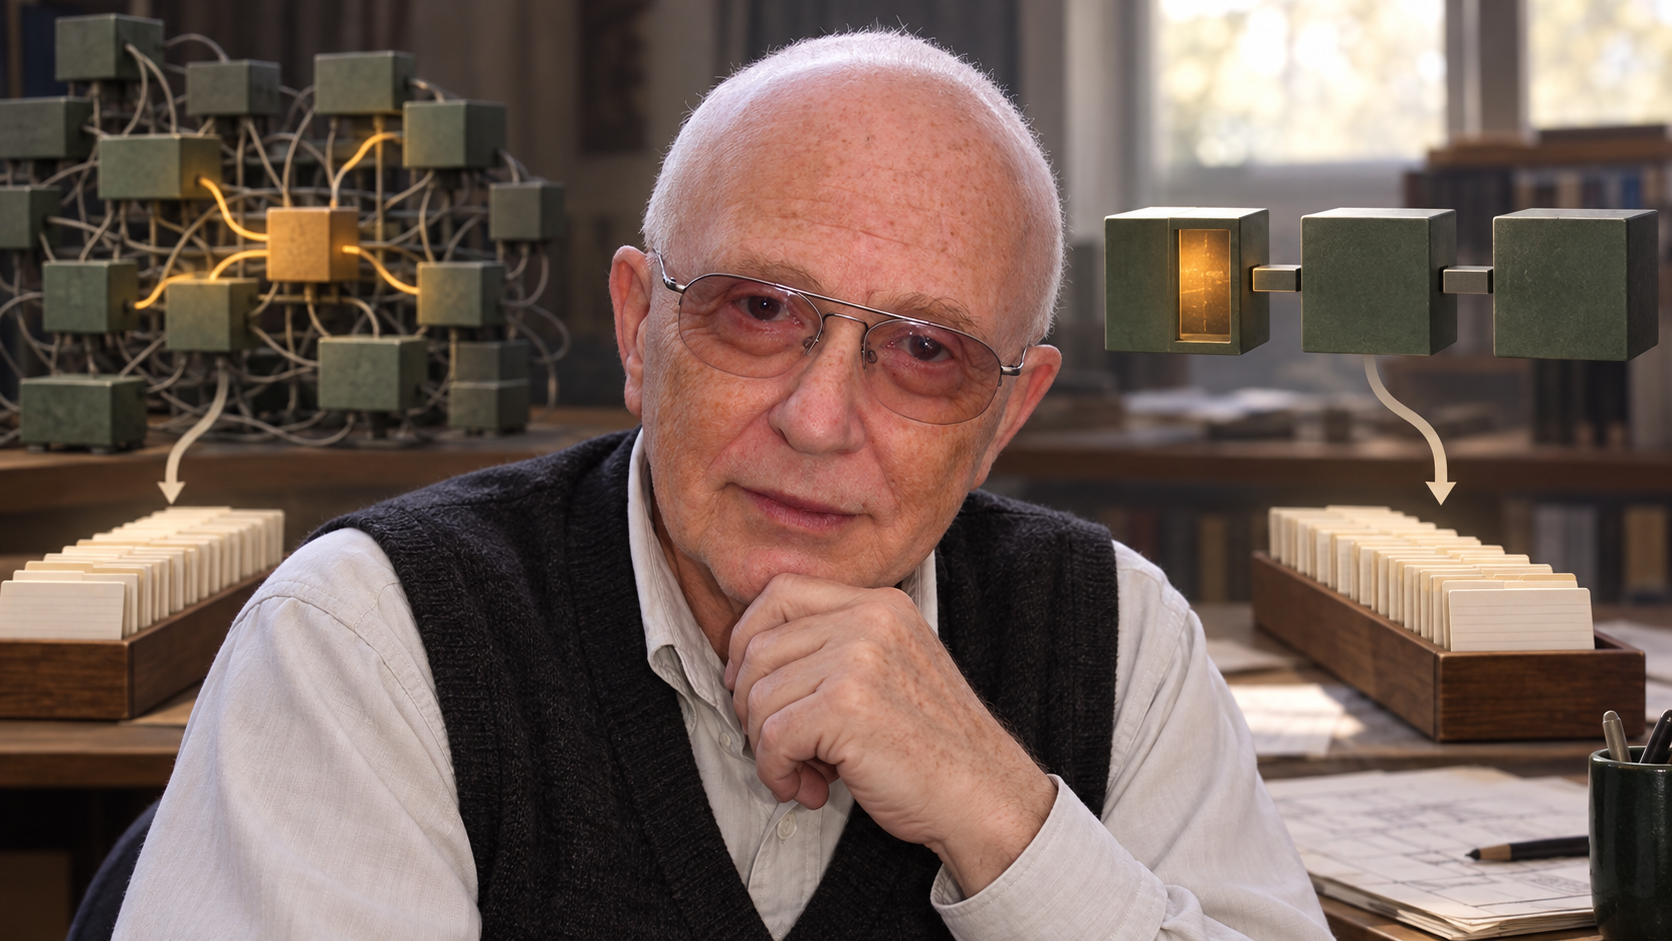
La solution conventionnelle suivait le temps d’exécution. Input lisait et stockait les lignes. Circular Shift préparait un index des rotations. Alphabetizing ordonnait cet index. Output mettait le résultat en forme. Master Control pilotait l’ensemble.
Les tâches avaient des noms distincts, mais leurs frontières transportaient des décisions fragiles : disposition en mémoire, tableaux partagés, index, pointeurs et conventions d’appel. Les caractères étaient regroupés quatre par mot machine. L’alphabetiseur et la sortie connaissaient les formats produits avant eux. Le contrôle était découpé ; le savoir sur les données restait distribué.
Le second découpage partait des décisions susceptibles de changer. Line Storage possédait la représentation des lignes et proposait des opérations sur caractères, mots et lignes. Circular Shifter donnait l’illusion d’un ensemble de rotations, sans imposer aux clients de savoir si elles étaient stockées, indexées ou calculées à la demande. Alphabetizer possédait la stratégie d’ordre. Input et Output consommaient ces services.
Pour Parnas, un module était une attribution de responsabilité, pas un sous-programme. Plusieurs routines pouvaient appartenir à un module ; un exécutable pouvait mêler du code issu de plusieurs modules. Une classe, un paquet ou un service peut matérialiser cette frontière, mais aucun ne le fait automatiquement.
Les cinq changements ne racontaient pas la même histoire
Le changement du format d’entrée restait dans Input dans les deux solutions. Le découpage conventionnel n’était donc pas mauvais partout.
En revanche, renoncer à garder toutes les lignes en mémoire obligeait à modifier tous les modules de la première solution, car tous connaissaient le format commun. Dans la seconde, Line Storage était seul concerné. Il en allait de même pour le choix de regrouper quatre caractères dans un mot.
Changer la représentation des rotations—les stocker explicitement, conserver seulement un index ou les calculer à la demande—touchait Circular Shift, Alphabetizer et Output dans le premier découpage. La seconde conception confinait ce choix à Circular Shifter.
Enfin, remplacer un classement total effectué une fois par une recherche au besoin ou par un classement progressif heurtait l’attente d’Output dans la première solution. Dans la seconde, le moment du classement restait indétectable pour les clients d’Alphabetizer.
La leçon n’est pas qu’une évolution correspondra toujours à un seul fichier. Elle est plus précise : on peut attribuer délibérément la connaissance d’une décision et mesurer le coût de sa fuite.
Même la « bonne » interface révélait trop
Parnas a critiqué son propre Circular Shifter. L’interface imposait un ordre aux rotations : les lignes antérieures devaient précéder les suivantes, et la ligne originale précédait ses rotations. Les clients n’avaient pas besoin de cette promesse. Elle empêchait notamment une implémentation produisant d’emblée les rotations dans l’ordre alphabétique.
Il qualifia ce choix d’erreur de conception. La méthode de calcul était cachée, mais un ordre inutile était devenu public. Passer par des fonctions d’accès ne suffit donc pas. Une API peut recopier la volatilité de son implémentation dans ses valeurs de retour, son ordre d’énumération ou ses garanties temporelles.
Ce qui est caché n’est pas un secret
L’expression information hiding ne désigne pas un contrôle d’accès, un chiffrement ou une isolation à l’exécution. Elle borne les personnes et les composants qui doivent connaître une décision de conception. Une information publique peut être correctement confinée ; une donnée secrète peut au contraire imposer son schéma à tout le système.
Ce n’est pas davantage un autre nom pour la programmation orientée objet. Un type abstrait ou une classe peut aider à protéger une représentation, mais aussi exposer un ordre, un format persistant ou une taxonomie instable. Les notions de cohésion et de couplage apportent un vocabulaire ultérieur ; elles ne remplacent pas l’identification de la décision cachée.
Une dépendance de compilation n’est pas non plus une dépendance de connaissance. Un client peut être recompilé sans devoir être réécrit. À l’inverse, deux services déployables séparément peuvent rester liés par une convention implicite. Enfin, Parnas avertissait que des appels de procédure très fréquents pouvaient ralentir le second découpage. La séparation ne garantit donc pas la performance ; elle oblige à traiter le coût d’implémentation consciemment.
Une idée corrigée puis prolongée
Dans un retour ultérieur, Parnas a relevé une autre fuite : son exemple laissait encore tous les modules supposer qu’une chaîne était une suite de caractères, ce qui gênait une représentation compacte par entiers. Le diagramme ne prouvait pas que toutes les bonnes décisions avaient été cachées.
Le travail de 1971 sur la distribution de l’information décrivait déjà les connexions entre modules comme les hypothèses qu’ils formulent les uns sur les autres. En 1976, la notion de familles de programmes étendit le problème à des versions apparentées. Puis, en 1985, Parnas, Paul C. Clements et David M. Weiss distinguèrent ensemble les structures de modules, d’utilisation et de processus et proposèrent un guide des modules pour orienter les mainteneurs.
D’autres chercheurs ont ensuite comparé KWIC sous forme de données partagées, de filtres, d’événements et d’autres styles. Les types abstraits, l’encapsulation et l’architecture logicielle ont élargi le champ. Il serait anachronique de tout attribuer au texte de 1972. Son expérience reste néanmoins intacte : conserver le même résultat, déplacer une décision, puis observer jusqu’où l’obligation de savoir se propage.
Sources
- David L. Parnas, On the Criteria To Be Used in Decomposing Systems into Modules, ACM
- David L. Parnas, Information Distribution Aspects of Design Methodology
- David L. Parnas, On the Design and Development of Program Families
- Parnas, Paul C. Clements et David M. Weiss, The Modular Structure of Complex Systems
- Entretien de Peter J. Denning avec David Parnas
- David Garlan et Mary Shaw, An Introduction to Software Architecture
- H. P. Luhn, Key word-in-context index for technical literature
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance