
Resumo
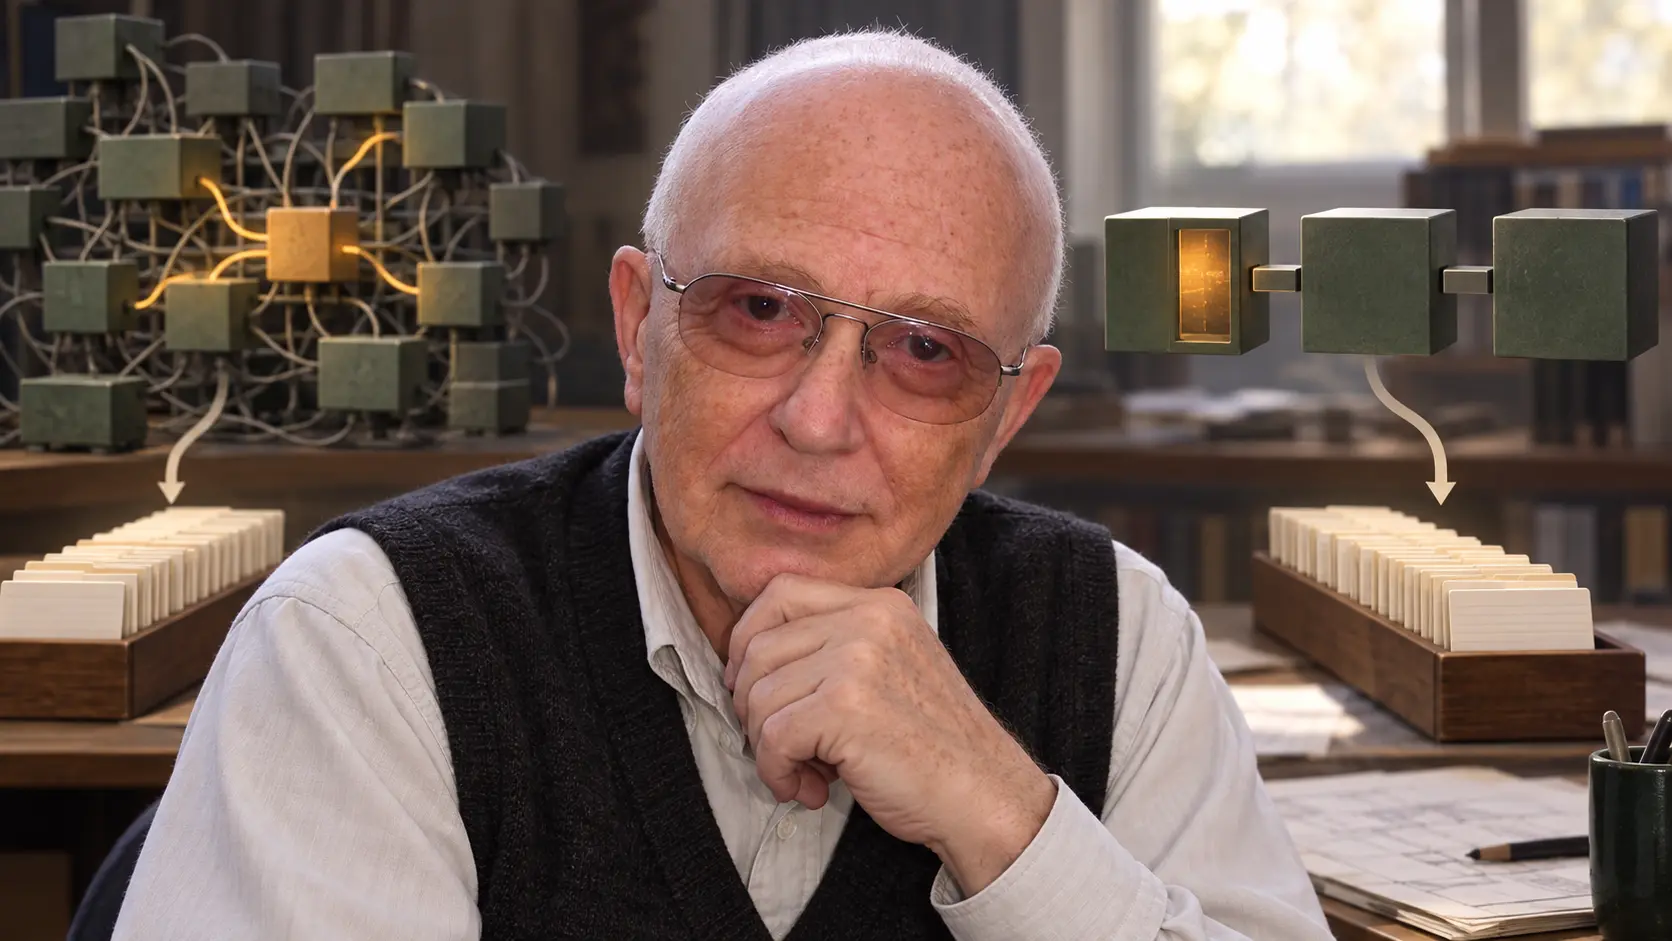
- Parnas contrapôs uma divisão por etapas de processamento a outra organizada pelas decisões sujeitas a mudança. As duas podiam usar os mesmos algoritmos e até gerar a mesma representação executável.
- Deixar de manter todas as linhas na memória ou mudar o empacotamento de caracteres afetava todos os módulos do primeiro desenho, mas somente Line Storage no segundo. Mudar a representação dos deslocamentos afetava três módulos contra um.
- Ocultação de informação limita quem precisa conhecer uma decisão. Não é segredo, criptografia, isolamento em execução nem sinônimo de orientação a objetos; interfaces também podem revelar detalhes demais.
A arquitetura aparece depois do teste verde
KWIC significa Key Word in Context. H. P. Luhn publicou em 1960 um índice produzido por máquina que apresentava uma palavra no contexto do título. Parnas escolheu uma versão pequena desse problema conhecido: ler linhas, gerar seus deslocamentos circulares, colocá-los em ordem alfabética e imprimi-los.
O artigo de 1972 afirma algo mais rigoroso do que “uma solução funciona melhor”. As duas funcionam. Elas podem compartilhar algoritmos e representações de dados. Depois de montadas, podem até ser idênticas para a máquina. A diferença surge nas representações usadas para compreender, documentar e modificar o programa.
Por isso, uma demonstração atual deveria começar empatando o comportamento observável. Em seguida, troca-se uma decisão e se pergunta quais módulos, testes e responsáveis precisam mudar sua compreensão. O teste moderno seria apenas uma ilustração do argumento, não um relato sobre as ferramentas históricas de Parnas.
O primeiro corte seguia o fluxo
A decomposição convencional tinha Input, Circular Shift, Alphabetizing, Output e Master Control. As tarefas eram distintas, mas suas interfaces transportavam layouts de memória, arrays, índices, ponteiros e convenções. Input empacotava quatro caracteres em uma palavra; os estágios posteriores conheciam a forma dos dados anteriores.
O fluxo de controle havia sido dividido. O conhecimento das decisões voláteis, não.
Na segunda decomposição, Line Storage possuía a representação das linhas e oferecia operações sobre caracteres, palavras e linhas. Circular Shifter fazia existir, para o cliente, um conjunto de linhas deslocadas, sem revelar se estavam armazenadas, indexadas ou calculadas quando solicitadas. Alphabetizer possuía a estratégia de ordenação. Input e Output consumiam esses serviços.
“Módulo” significava atribuição de responsabilidade, não sub-rotina. Um módulo podia oferecer várias rotinas, e o código final podia reunir trechos de módulos diferentes. Classe, pacote, processo ou serviço são mecanismos possíveis, não provas de que a decisão certa foi confinada.
Cinco mudanças mediram a propagação
Uma alteração no formato de entrada permanecia em Input nos dois projetos. A primeira decomposição não perdia em todos os casos.
Quando todas as linhas deixavam de caber ou permanecer na memória, porém, cada módulo do primeiro projeto precisava mudar porque todos conheciam o formato compartilhado. No segundo, só Line Storage conhecia a política. O mesmo valia para substituir a escolha de quatro caracteres por palavra.
Se os deslocamentos passassem de índices para linhas armazenadas—ou fossem calculados sob demanda—Circular Shift, Alphabetizer e Output eram afetados no primeiro projeto. No segundo, a decisão ficava dentro de Circular Shifter.
Também era possível deixar de ordenar a lista toda de uma vez, buscar cada próximo item quando necessário ou distribuir a ordenação ao longo do trabalho. O primeiro Output esperava um índice pronto. No segundo desenho, os clientes não observavam quando Alphabetizer realizava a tarefa.
A informação não some: recebe um proprietário. O ganho é retirar dos demais a necessidade, e o direito, de depender do detalhe.
Uma interface ainda pode contar demais
Parnas criticou o próprio segundo desenho. Circular Shifter especificava que deslocamentos de linhas anteriores viriam primeiro e que a linha original precederia suas rotações. Os clientes não precisavam dessa ordem. A promessa impedia uma implementação que já produzisse os deslocamentos em ordem alfabética.
O texto chama isso de erro de projeto. O método de cálculo estava oculto, mas uma sequência acidental tinha escapado. Campos privados e métodos de acesso não bastam se formatos de retorno, ordem de enumeração, temporização ou erros reproduzem a implementação.
Não se trata de sigilo
Em information hiding, “hiding” não significa autorização, criptografia, sandbox ou separação de processos. Um dado secreto pode impor seu esquema a todos os módulos; uma decisão pública pode ser localizada atrás de uma interface.
Também não é outro nome para orientação a objetos. Tipos abstratos, classes e encapsulamento podem realizar parte do objetivo, ou podem expor persistência e taxonomias instáveis. Coesão e acoplamento são vocabulário posterior útil, mas não nomeiam a decisão. Dependência de compilação também difere de dependência de conhecimento: recompilar não implica reescrever, e implantar separadamente não elimina uma suposição compartilhada.
O princípio não garante velocidade. Parnas alertou que chamadas de procedimento muito frequentes poderiam tornar o segundo desenho mais lento e sugeriu inserção de código ou transferências especializadas. A fronteira de conhecimento e a execução eficiente exigem decisões próprias.
O próprio exemplo precisou de revisão
Mais tarde, Parnas observou que seu KWIC ainda permitia a todos os módulos saber que strings eram sequências de caracteres. Essa premissa dificultava representar strings frequentes por inteiros compactos. O caso clássico não descobrira de uma só vez toda decisão relevante.
O desenvolvimento também foi coletivo. O trabalho de 1971 tratou conexões como suposições entre módulos. Em 1976, famílias de programas ampliaram a análise a versões relacionadas. Em 1985, Parnas, Paul C. Clements e David M. Weiss distinguiram estrutura de módulos, estrutura de usos e estrutura de processos, além de propor um guia de módulos para manutenção.
Pesquisadores posteriores voltaram ao KWIC para comparar dados compartilhados, filtros, eventos e outros estilos. Esses avanços não devem ser projetados retroativamente no artigo de 1972. O experimento, contudo, permanece: fixar o resultado, perturbar uma decisão e acompanhar até onde viaja a obrigação de conhecê-la.
Fontes
- David L. Parnas, On the Criteria To Be Used in Decomposing Systems into Modules
- David L. Parnas, Information Distribution Aspects of Design Methodology
- David L. Parnas, On the Design and Development of Program Families
- Parnas, Paul C. Clements e David M. Weiss, The Modular Structure of Complex Systems
- Entrevista de Peter J. Denning com David Parnas
- David Garlan e Mary Shaw, An Introduction to Software Architecture
- H. P. Luhn, Key word-in-context index for technical literature
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance