
要約
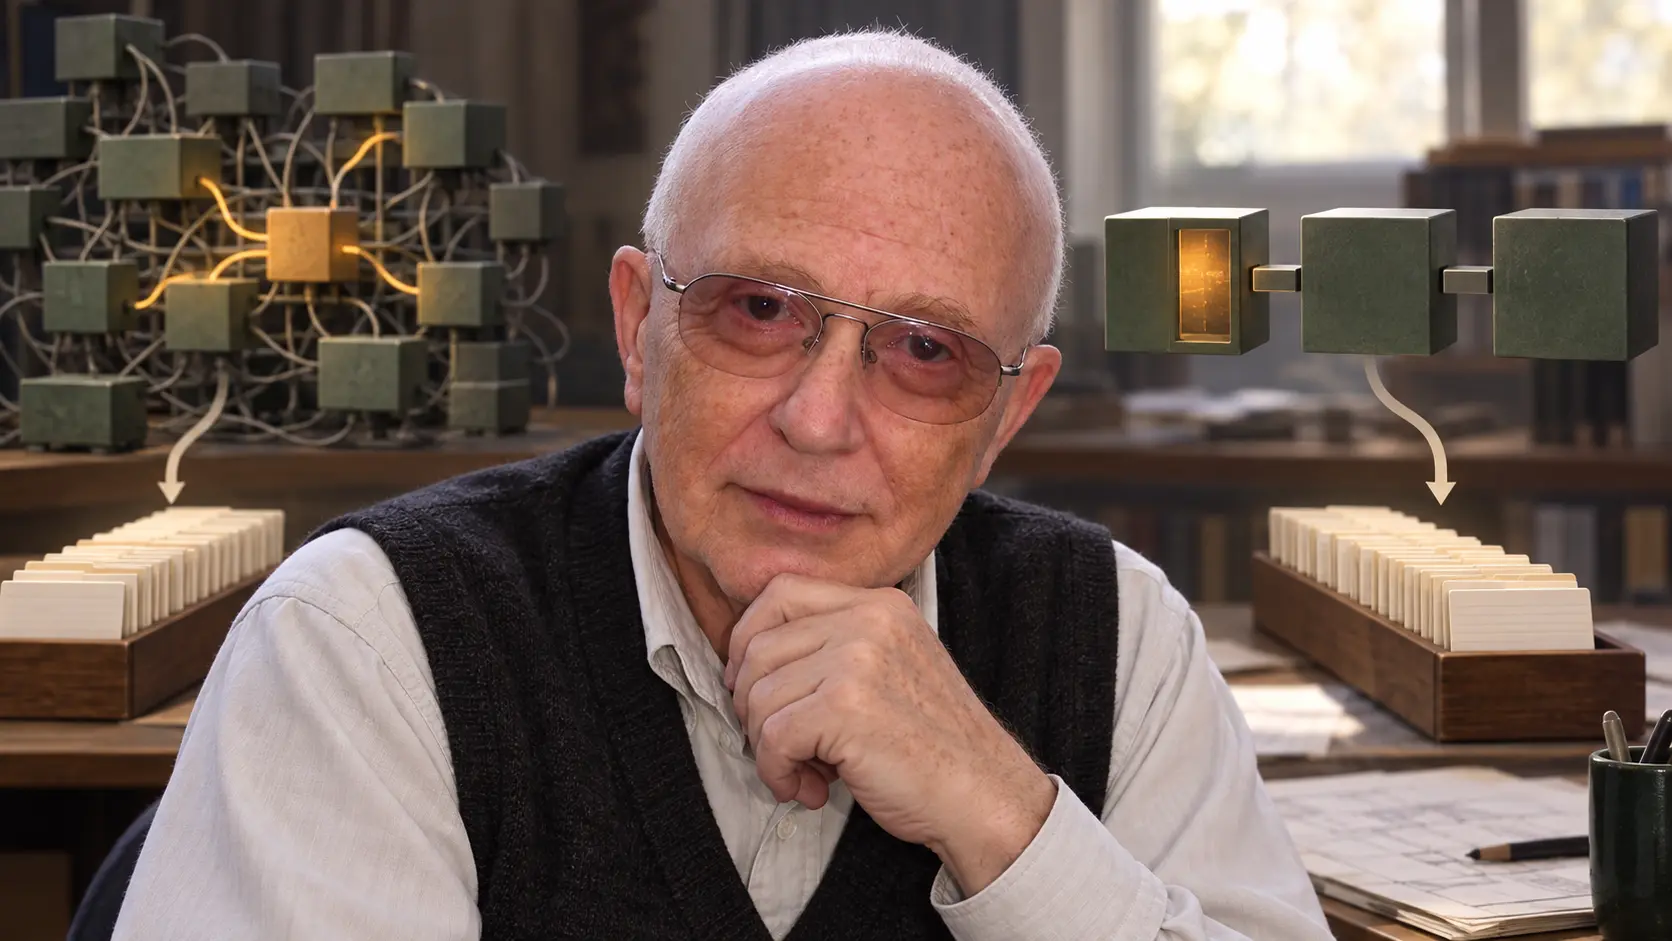
- Parnasは、入力、循環シフト、整列、出力という処理段階で分ける構成と、変更し得る設計判断ごとに責任を置く構成を比較した。両者は同じアルゴリズムを使い、実行時には同一の形になり得た。
- 全行を主記憶に置く判断や文字の詰め方を変えると、第一の構成では全モジュールが影響を受け、第二の構成ではLine Storageだけで済む。シフト表現の変更も三モジュール対一モジュールだった。
- 情報隠蔽は秘密保持、暗号化、実行時隔離、オブジェクト指向の別名ではない。インターフェースは不要な順序を漏らし得るし、素朴な実装では性能コストも生じる。
正しい出力は出発点にすぎない
KWICは Key Word in Context の略である。H. P. Luhnは1960年、語を見出しの文脈とともに示す機械生成索引を発表した。Parnasは新しい検索方式を発明するためではなく、構造を肉眼で追える小さな既知の課題としてKWICを選んだ。
単純化されたシステムは複数の行を読み、各行の先頭語を末尾へ順に移して循環シフトを作り、すべてをアルファベット順に並べて出力する。1972年の論文は、比較する二案がどちらも動くとはっきり述べている。データ表現やアルゴリズムを共有し、組み立て後の実行表現が同じになることさえある。
違いは、変更、文書化、理解のための構造にある。作業をどう割り当て、どの判断をインターフェースに持ち出し、その判断が変わったとき誰の理解を更新するのか。現代的なテストで説明するなら、まず出力を同一にしてから格納判断を変える。これは説明のための思考実験であり、Parnasが当時のテスト基盤を使ったという主張ではない。
処理順に沿った第一の切り方
従来案はInput、Circular Shift、Alphabetizing、Output、Master Controlに分かれていた。各処理は小さく、名前も明確だった。しかし境界には主記憶の配置、共有配列、索引、ポインタ、呼び出し規約が含まれていた。Inputは一語に四文字を詰め、後段は前段が作った表の形を知っていた。
制御の流れは分割されていても、変わりやすい表現の知識は分割されていない。フローチャートは実行の境界を描いたが、変更の境界を描かなかった。
第二案ではLine Storageが行の内部表現を所有し、文字、語、行へアクセスする操作を提供した。Circular Shifterは、シフトを保存していても、索引だけを持っていても、要求時に計算していても、利用側には「シフト済みの行の集合」として見せた。Alphabetizerは整列方法を所有し、InputとOutputはそれらのサービスを利用した。
ここでいうmoduleは責任の割り当てであり、subroutineと同義ではない。一つのモジュールが複数のルーチンを持てるし、最終コードが複数モジュール由来の断片を含むこともある。クラス、パッケージ、プロセス、チームの名前だけでは、この知識境界は成立しない。
五つの変更が境界を検査した
入力形式の変更は両案ともInputだけに収まった。第一案が何でも悪いわけではない。
全行を主記憶へ置くのをやめる場合、第一案では全モジュールが共有形式を使っていたため、すべてが変わる。第二案ではLine Storageだけが格納方式を知っていた。四文字を一つの機械語へ詰める判断を変える場合も同じである。
循環シフトを完全な行として保存するか、元の行への索引として持つか、文字を要求時に計算するかを変えると、第一案ではCircular Shift、Alphabetizer、Outputが影響を受ける。第二案ではCircular Shifterだけが変わる。
一度に全件を整列する代わりに、必要時に次の項目を探す、あるいは処理期間に整列作業を分散する変更もある。第一案のOutputは完成した索引を期待した。第二案の利用側は整列がいつ行われたか観測できなかった。
隠した情報は消えたのではない。所有者を限定し、他のモジュールがその判断へ依存する権利を失ったのである。
インターフェース自身が漏えい源になる
Parnasは第二案も完全とはしなかった。Circular Shifterの定義は、先の入力行のシフトが先に並び、各行では元の行の後に一語ずつ回した結果が続くと規定した。利用側に不要な順序だった。この約束のため、最初からアルファベット順でシフトを生成し、Alphabetizerをほぼ空にする実装が排除された。
論文はこれを設計誤りと呼ぶ。計算方法は隠しても、偶然の順序を公開してしまった。フィールドを非公開にしてアクセサを設けるだけでは足りない。戻り値の形、列挙順、時間保証、エラー分類が内部判断を写していれば、変更は再び外へ広がる。
セキュリティでも万能最適化でもない
information hidingの「hiding」は、アクセス制御、暗号化、サンドボックス、プロセス隔離を意味しない。秘密データでもスキーマを全員に知らせれば設計知識は拡散する。公知の判断でも一つの境界内に閉じ込められる。
オブジェクト指向とも同義ではない。抽象データ型やクラスは実現手段になり得るが、永続形式や不安定な分類を露出することもある。凝集度と結合度は後世の有用な語彙だが、「何の判断を隠すか」に代わるものではない。
コンパイル依存と意味上の依存も別である。再コンパイルされても利用側のソースや論理は変わらない場合がある。逆に、独立配備できるサービス同士が暗黙の順序へ強く依存する場合もある。
性能も自動ではない。Parnasは細かな操作をすべて重い手続き呼び出しにすると第二案が遅くなり得ると警告し、コード挿入や専用転送を実装候補に挙げた。設計境界は性能設計を不要にしない。
後から見つかった、もう一つの知識
Parnasは後年、元のKWICでも各モジュールが文字列を「文字の列」と知っていたと振り返った。この共有前提は、頻出文字列を整数で表現する最適化を妨げ得る。代表例でさえ、隠すべき判断を一度にすべて見つけたわけではなかった。
考え方は共同で発展した。1971年の情報分配に関する論文は、モジュール間の接続を互いに置く仮定として扱った。1976年のプログラム族は複数版に時間軸を広げた。1985年にはParnas、Paul C. Clements、David M. Weissが共同で、モジュール構造、uses構造、プロセス構造を区別し、保守者が必要な知識へ到達するmodule guideを示した。
その後もソフトウェアアーキテクチャ研究はKWICを共有データ、パイプとフィルター、イベントなどで比較した。後世の成果を1972年へ書き戻すべきではない。それでも、観測可能な出力を固定し、判断を一つ動かし、「知る必要」がどこまで伝わるかを見る方法は今も有効である。
出典
- David L. Parnas, On the Criteria To Be Used in Decomposing Systems into Modules
- David L. Parnas, Information Distribution Aspects of Design Methodology
- David L. Parnas, On the Design and Development of Program Families
- Parnas、Paul C. Clements、David M. Weiss, The Modular Structure of Complex Systems
- Peter J. DenningによるDavid Parnasへのインタビュー
- David Garlan、Mary Shaw, An Introduction to Software Architecture
- H. P. Luhn, Key word-in-context index for technical literature
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加