
要約
- OCIはTerraform、イベント、パッチ管理、セキュリティ検知、復旧計画を組み合わせて、反復的なインフラ作業の一部をコードとワークフローへ移せる。
- しかしAI導入では、GPUの形状、サービス上限、予約容量、ネットワーク、データ所在地が別々の制約として残る。自動化は構成変更を速くしても、容量やアプリケーションの正しさを保証しない。
自動化されるのは「手順」であり、目的ではない
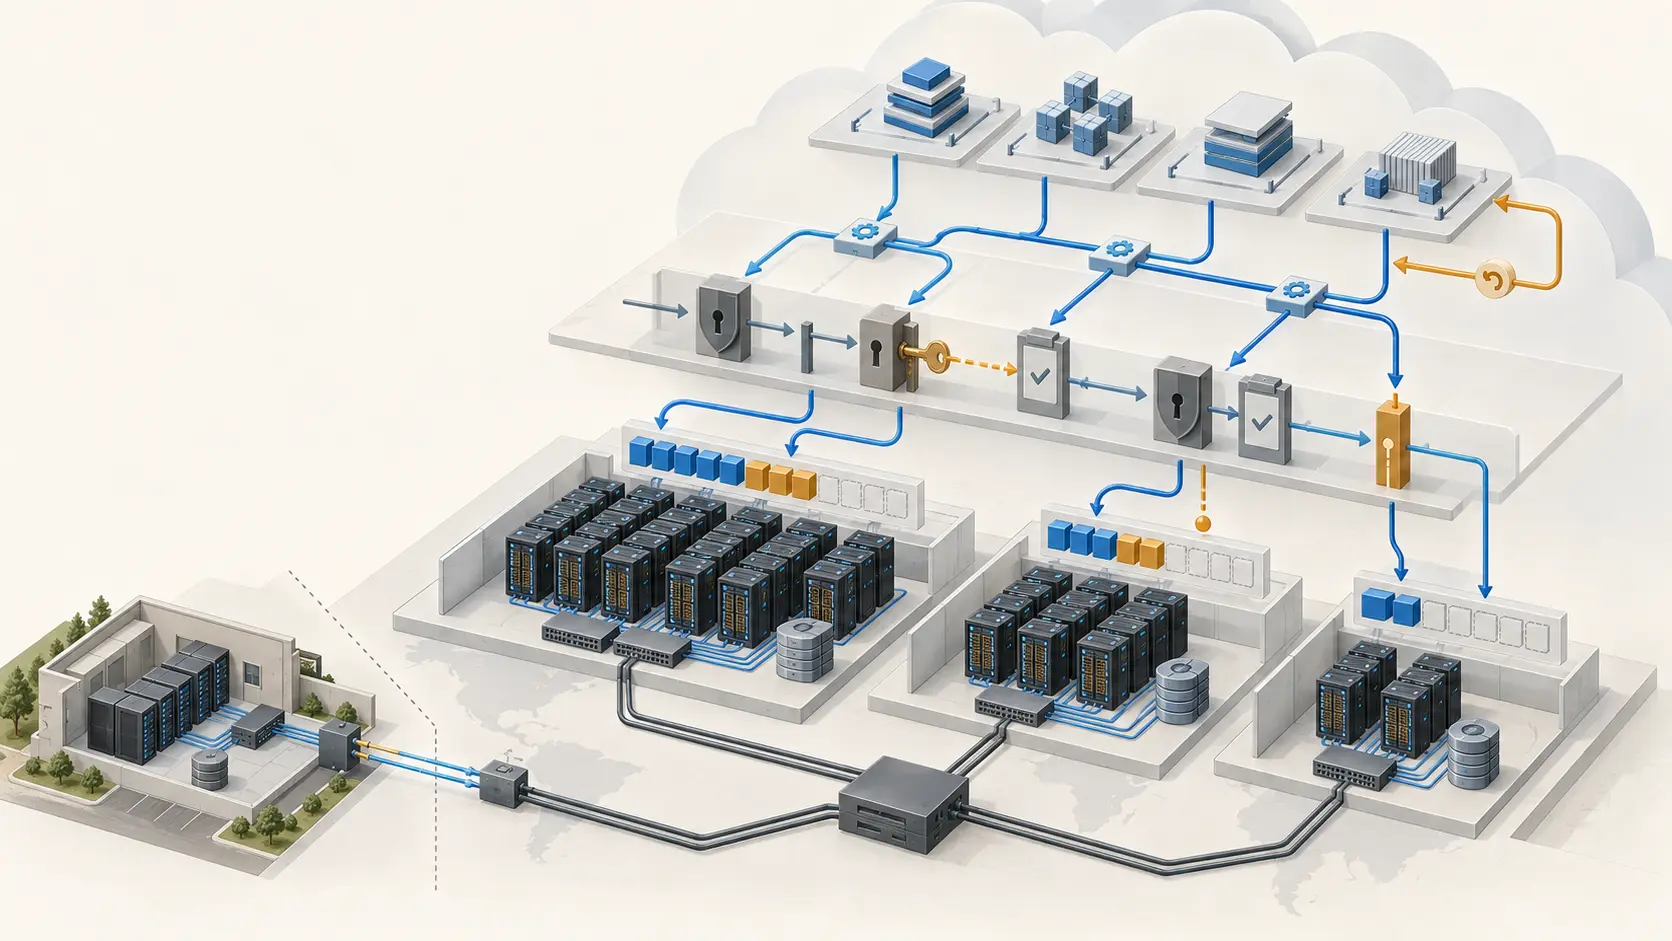
OCI Resource ManagerはTerraform構成を使ったリソースのプロビジョニングと管理を支援する。計画、適用、破棄、インポート、状態管理、ジョブの記録などは、コンソール上の反復作業をコード化するための部品になる。Terraformプロバイダーも、OCIを宣言的な構成として外部から操作する経路を提供する。これらの機能は、構成の再現性と変更履歴を高めるが、チームが構成を作り、権限を設計し、計画結果を確認する責任までは消さない。[https://docs.oracle.com/en-us/iaas/Content/ResourceManager/Concepts/resourcemanager.htm] [https://registry.terraform.io/providers/oracle/oci/latest/docs]
Eventsは、対応するリソース状態の変化をFunctions、Notifications、Streamingなどへ渡すトリガー層として機能する。Cloud Guardは定義された検知条件に応じて、通知や一部の応答を自動化できる。OS Management Hubは、対応するOracle Linuxシステムのインベントリー、更新、エラータ、スケジュールされたジョブを集中管理する。つまりOCIは、プロビジョニング、検知、通知、パッチ、応答を連結できる。ただし、イベントの対象範囲、権限、冪等性、失敗時の処理は運用側が設計しなければならない。[https://docs.oracle.com/en-us/iaas/Content/Events/Concepts/eventsoverview.htm] [https://docs.oracle.com/en-us/iaas/osmh/doc/overview-os-management-hub.html] [https://docs.oracle.com/en-us/iaas/Content/CloudGuard/Concepts/cloudguard.htm]
Full Stack Disaster Recoveryも、保護グループと復旧計画を使って、切り替えやフェイルオーバーの手順を編成する。Network Path Analyzerは、実際の通信を流すのではなく、経路、ルート、セキュリティリスト、ネットワーク・セキュリティ・グループ、ゲートウェイの構成から到達可能性を分析する。この差は重要だ。構成上の到達可能性は、遅延、パケット損失、アプリケーションの健全性、復旧目標の達成を意味しない。[https://docs.oracle.com/en-us/iaas/Content/Network/Concepts/path_analyzer.htm]
AI基盤では、構成よりも容量がボトルネックになる
AIワークロードでは、GPUの種類、メモリー、ローカルストレージ、ネットワーク性能、配置可能なリージョンが同時に適合しなければならない。OCIのコンピュート形状カタログとクラスターネットワークは、対応する形状を高帯域・低遅延の構成へ配置するための基盤を示す。しかし、カタログに形状が載っていることは、顧客のテナンシーやリージョンで直ちに利用できることを意味しない。[https://docs.oracle.com/en-us/iaas/Content/Compute/Tasks/managingclusternetworks.htm] [https://docs.oracle.com/en-us/iaas/Content/Compute/References/computeshapes.htm]
サービス上限、コンパートメントの制御、可用性ドメインの在庫は、技術的に可能な構成と、実際に開始できる構成を分ける。容量予約は、計画したインスタンス起動に備えて対応する計算資源を確保する手段になり得るが、対応形状、上限、地域、課金条件に左右される。予約の存在自体が、AI基盤の供給をオンデマンドで無制限とみなせないことを示している。[https://docs.oracle.com/en-us/iaas/Content/Compute/Tasks/reserve-capacity.htm] [https://docs.oracle.com/en-us/iaas/Content/General/Concepts/servicelimits.htm]
専用AIクラスターは、対応モデルのファインチューニングやホスティングに向けた容量分離を提供する設計だが、対応モデル、単位サイズ、地域、最低利用条件が導入範囲を決める。これは顧客がGPUクラスター全体を直接所有・運用することとは異なる。OCIのAIインフラ製品ページやHPC向けのリファレンス構成も、GPU、RDMA、ストレージ、クラスター管理を組み合わせる方向を示すが、マーケティング上の最大構成やリファレンス実装は、一般的な在庫、性能、費用、外部顧客の稼働率を証明しない。[https://github.com/oracle-quickstart/oci-hpc] [https://docs.oracle.com/en-us/iaas/Content/generative-ai/dedicated-ai-cluster.htm]
ハイブリッド配置は制約の除去ではなく、制約の移動である
Compute Cloud@CustomerやOCI Dedicated Regionは、データ所在地、規制、レイテンシー、既存設備の制約を考慮した配置を可能にする。これはすべてのデータとアプリケーションを公的リージョンへ移せない組織にとって意味がある。一方で、現地へのハードウェア導入、容量計画、接続、サービスカタログの範囲、Oracleの運用関与が新しい依存関係になる。ローカルに置けることは、パブリックリージョンと同じサービスやAI機能が使えることを意味しない。[https://www.oracle.com/news/announcement/q4fy25-earnings-release-2025-06-11/] [https://www.oracle.com/news/announcement/q1fy26-earnings-release-2025-09-09/]
したがってOCIの採用メカニズムは、単純な「クラウドへ移行する」ことではない。チームは、構成をコード化し、検知と復旧をワークフロー化し、容量を事前に確保し、データ所在地に応じて配置形態を選ぶ。その代わり、権限、上限、在庫、アプリケーション依存関係、ロールバック、人的な承認を運用モデルに残す。自動化の価値は作業を消すことではなく、判断可能な状態を再現可能な手順へ変えることにある。
出典
- https://docs.oracle.com/en-us/iaas/Content/ResourceManager/Concepts/resourcemanager.htm
- https://registry.terraform.io/providers/oracle/oci/latest/docs
- https://docs.oracle.com/en-us/iaas/Content/Events/Concepts/eventsoverview.htm
- https://docs.oracle.com/en-us/iaas/osmh/doc/overview-os-management-hub.html
- https://docs.oracle.com/en-us/iaas/disaster-recovery/doc/overview-full-stack-disaster-recovery.html
- https://docs.oracle.com/en-us/iaas/Content/CloudGuard/Concepts/cloudguard.htm
- https://docs.oracle.com/en-us/iaas/Content/Network/Concepts/path_analyzer.htm
- https://github.com/oracle-quickstart/oci-hpc
- https://docs.oracle.com/en-us/iaas/Content/Compute/Tasks/managingclusternetworks.htm
- https://docs.oracle.com/en-us/iaas/Content/Compute/References/computeshapes.htm
- https://docs.oracle.com/en-us/iaas/Content/Compute/Tasks/reserve-capacity.htm
- https://docs.oracle.com/en-us/iaas/Content/General/Concepts/servicelimits.htm
- https://docs.oracle.com/en-us/iaas/Content/generative-ai/dedicated-ai-cluster.htm
- https://www.oracle.com/artificial-intelligence/ai-infrastructure/
- https://www.oracle.com/news/announcement/q4fy25-earnings-release-2025-06-11/
- https://www.oracle.com/news/announcement/q1fy26-earnings-release-2025-09-09/
- https://www.reuters.com/business/oracle-forecasts-annual-revenue-above-estimates-ai-demand-boosts-cloud-growth-2025-06-11/
- https://www.oracle.com/cloud/cloud-at-customer/dedicated-region/
- https://www.srgresearch.com/articles/cloud-market-jumped-to-330-billion-in-2024-genai-is-now-driving-half-of-the-growth
- https://docs.oracle.com/en-us/iaas/compute-cloud-at-customer/topics/overview/overview.htm
- https://www.oracle.com/customers/cohere/
- https://www.oracle.com/news/announcement/openai-selects-oracle-cloud-infrastructure-to-extend-microsoft-azure-ai-platform-2024-06-11/
- https://openai.com/index/announcing-the-stargate-project/
- https://openai.com/index/stargate-advances-with-partnership-with-oracle/
- https://www.reuters.com/technology/uber-signs-cloud-deals-with-google-oracle-2023-02-13/
- https://www.sec.gov/edgar/browse/?CIK=1341439&owner=exclude
- https://btw.media/ja/directory/oracle-cloud
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加