
Résumé
- OCI automatise le provisionnement, les workflows déclenchés par événements, certaines opérations de sécurité, les mises à jour de systèmes et la reprise après sinistre, mais ces fonctions exigent toujours des configurations, des permissions et des procédures d’exploitation.
- Pour l’IA, la contrainte déterminante n’est pas seulement la disponibilité d’un GPU : elle inclut la capacité réservée, les limites du compte, le réseau de cluster, le stockage, la localisation des données et la validation du service en production.
La différence entre une fonction cloud et une adoption opérationnelle tient au travail qui reste à la charge de l’équipe. Oracle Resource Manager s’appuie sur Terraform et des stacks gérées pour provisionner et administrer des ressources OCI. Les équipes peuvent planifier, appliquer, détruire ou importer des configurations, consulter les journaux d’exécution et détecter certains écarts entre l’état déclaré et l’état observé (documentation Resource Manager). Le fournisseur Terraform OCI étend cette logique à de nombreuses ressources et permet de piloter l’infrastructure par du code plutôt que par la seule console (registre Terraform OCI).
Ce mécanisme automatise une séquence répétable, pas la décision d’architecture. Une équipe doit toujours écrire ou sélectionner le code, définir les politiques d’accès, examiner le plan, gérer l’état et traiter les erreurs. Le bénéfice est donc un déplacement du contrôle : le geste manuel devient une modification versionnée, auditable et potentiellement reproductible. Le risque correspondant est qu’une erreur de configuration puisse également être propagée avec la même reproductibilité.
OCI Events ajoute une couche de déclenchement. Des changements d’état peuvent être filtrés puis envoyés vers Functions, Notifications ou Streaming (documentation Events). Cela peut lancer une notification, une remédiation ou un workflow. Cependant, les actions en aval doivent être conçues séparément. L’idempotence, les permissions, les échecs partiels et la possibilité d’une réponse indésirable restent des problèmes d’exploitation, et non des détails éliminés par le service.
La même limite apparaît dans les fonctions de gestion. OS Management Hub centralise l’inventaire, les sources logicielles, les correctifs et les tâches planifiées pour les systèmes pris en charge (documentation OS Management Hub). Full Stack Disaster Recovery organise des groupes de protection et des plans capables d’enchaîner des opérations de basculement et de reprise (documentation Full Stack Disaster Recovery). Cloud Guard peut détecter des problèmes définis et déclencher des réponses configurées (documentation Cloud Guard). Ces fonctions réduisent la séquence manuelle, mais ne remplacent ni les tests, ni la vérification de compatibilité des applications, ni la supervision des conséquences.
Pour les réseaux, Network Path Analyzer vérifie si une source et une destination devraient être atteignables selon la configuration des routes, des listes de sécurité, des groupes de sécurité réseau et des passerelles (documentation Network Path Analyzer). C’est plus précis qu’une simple description de la topologie. Mais le résultat reste une analyse de configuration : il ne prouve ni la livraison réelle des paquets, ni la latence, ni la perte, ni la santé de l’application.
L’IA rend cette distinction plus coûteuse. Les réseaux de cluster OCI sont conçus pour relier des instances compatibles avec un débit élevé et une faible latence, et peuvent être administrés avec des pools d’instances (documentation des réseaux de cluster). Le catalogue des formes de calcul décrit les combinaisons de CPU, mémoire, GPU, stockage local et réseau qui bornent le placement d’une charge (catalogue des formes). Une configuration théoriquement compatible n’est toutefois pas une garantie d’inventaire immédiat dans une région ou un domaine de disponibilité.
Les réservations de capacité répondent directement à cette incertitude : elles permettent de réserver une capacité de calcul prise en charge dans un domaine de disponibilité pour des lancements ultérieurs (documentation des réservations). Les limites de service et les quotas ajoutent une autre contrainte ; un déploiement GPU important peut nécessiter une demande d’augmentation sans que cette approbation garantisse l’inventaire physique (documentation des limites de service). La capacité devient donc un objet de planification et de gouvernance, pas une simple ligne dans une architecture.
Oracle présente également des clusters IA dédiés, des infrastructures GPU et des architectures de réseau et de stockage à haut débit. Ces offres peuvent isoler une capacité destinée à l’entraînement ou à l’hébergement de modèles. Elles ne signifient pas que le client contrôle le cluster GPU sous-jacent, ni que les modèles pris en charge, les régions, les unités de capacité et les engagements commerciaux sont uniformes.
Cette logique explique aussi les offres hybrides. Compute Cloud@Customer et OCI Dedicated Region ciblent les organisations qui doivent conserver certaines données ou certains traitements dans leur propre centre de données. Elles peuvent rapprocher l’environnement cloud des systèmes locaux ou des exigences de souveraineté. Mais elles ajoutent installation matérielle, connectivité, planification de capacité, gouvernance et dépendance à l’intervention du fournisseur. Une région dédiée n’abolit pas la migration applicative ni le besoin d’équipes capables de l’exploiter.
Les annonces de clients et de partenariats donnent un signal d’adoption, mais elles ne doivent pas être confondues avec une mesure indépendante de l’utilisation. Les références à Cohere, OpenAI ou Uber peuvent montrer que des charges et des relations commerciales existent autour d’OCI ; elles ne suffisent pas à établir le coût, la disponibilité régionale, la performance livrée ou la réussite de chaque déploiement.
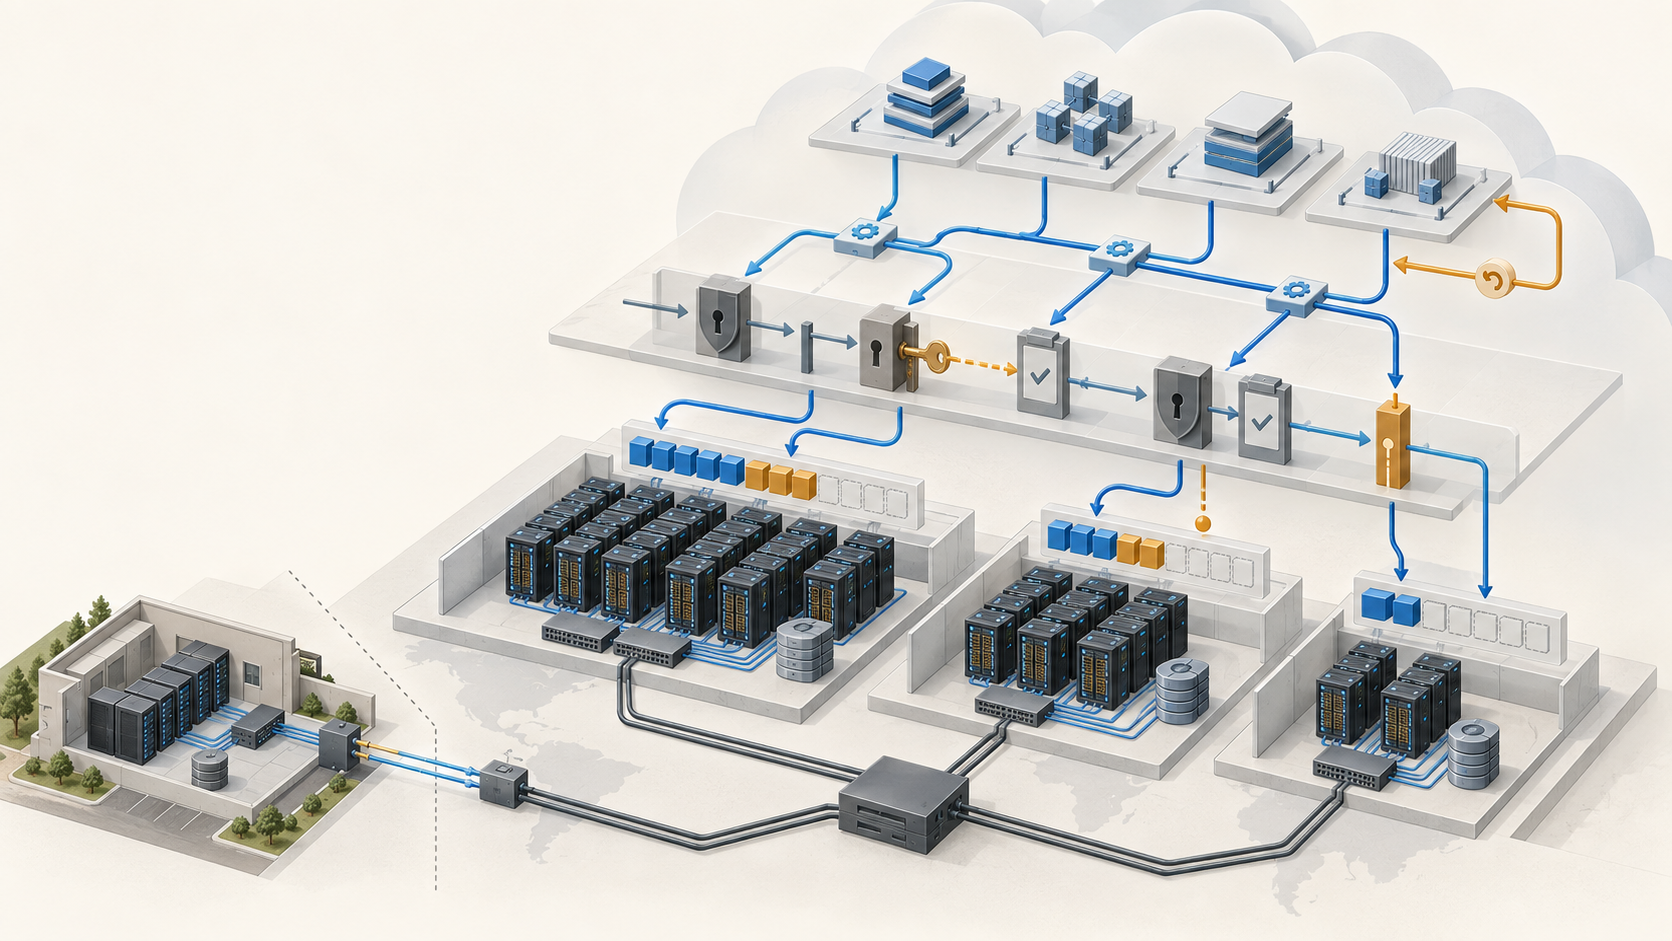
Le point nouveau par rapport à la couverture antérieure de BTW sur Transit Routing est donc le suivant : OCI doit être évalué comme une chaîne de contrôle opérationnel. Le code provisionne, l’événement déclenche, l’outil analyse, la réservation sécurise une partie de la capacité et l’orchestrateur séquence la reprise. À chaque étape, une décision humaine, une limite de service ou une dépendance applicative peut encore interrompre l’automatisation.
Sources
- https://docs.oracle.com/en-us/iaas/Content/CloudGuard/Concepts/cloudguard.htm
- https://docs.oracle.com/en-us/iaas/Content/Compute/References/computeshapes.htm
- https://docs.oracle.com/en-us/iaas/Content/Compute/Tasks/managingclusternetworks.htm
- https://docs.oracle.com/en-us/iaas/Content/Compute/Tasks/reserve-capacity.htm
- https://docs.oracle.com/en-us/iaas/Content/Events/Concepts/eventsoverview.htm
- https://docs.oracle.com/en-us/iaas/Content/General/Concepts/servicelimits.htm
- https://docs.oracle.com/en-us/iaas/Content/Network/Concepts/path_analyzer.htm
- https://docs.oracle.com/en-us/iaas/Content/ResourceManager/Concepts/resourcemanager.htm
- https://docs.oracle.com/en-us/iaas/Content/generative-ai/dedicated-ai-cluster.htm
- https://docs.oracle.com/en-us/iaas/compute-cloud-at-customer/topics/overview/overview.htm
- https://docs.oracle.com/en-us/iaas/disaster-recovery/doc/overview-full-stack-disaster-recovery.html
- https://docs.oracle.com/en-us/iaas/osmh/doc/overview-os-management-hub.html
- https://github.com/oracle-quickstart/oci-hpc
- https://openai.com/index/announcing-the-stargate-project/
- https://openai.com/index/stargate-advances-with-partnership-with-oracle/
- https://registry.terraform.io/providers/oracle/oci/latest/docs
- https://www.reuters.com/business/oracle-forecasts-annual-revenue-above-estimates-ai-demand-boosts-cloud-growth-2025-06-11/
- https://www.oracle.com/artificial-intelligence/ai-infrastructure/
- https://www.oracle.com/customers/cohere/
- https://www.oracle.com/news/announcement/openai-selects-oracle-cloud-infrastructure-to-extend-microsoft-azure-ai-platform-2024-06-11/
- https://www.oracle.com/news/announcement/q1fy26-earnings-release-2025-09-09/
- https://www.oracle.com/news/announcement/q4fy25-earnings-release-2025-06-11/
- https://www.reuters.com/business/oracle-forecasts-annual-revenue-above-estimates-ai-demand-boosts-cloud-growth-2025-06-11/
- https://www.reuters.com/technology/uber-signs-cloud-deals-with-google-oracle-2023-02-13/
- https://www.sec.gov/edgar/browse/?CIK=1341439&owner=exclude
- https://www.srgresearch.com/articles/cloud-market-jumped-to-330-billion-in-2024-genai-is-now-driving-half-of-the-growth
- https://www.oracle.com/cloud/cloud-at-customer/dedicated-region/
- https://btw.media/fr/directory/oracle-cloud
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance