
Résumé
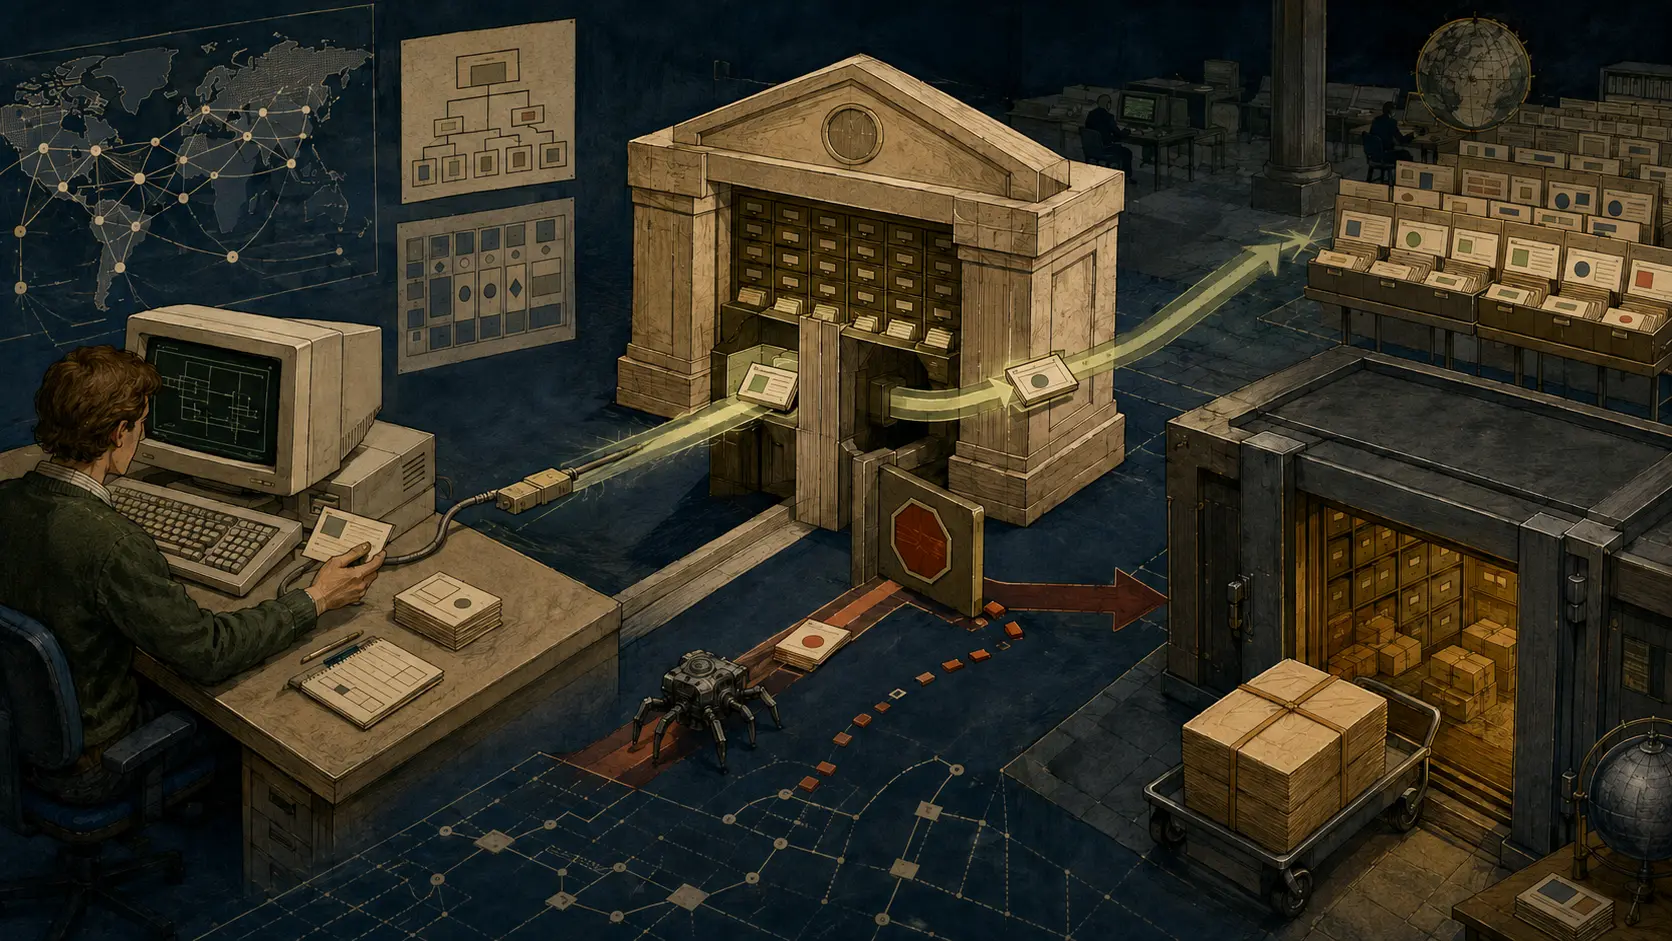
- Le RFC 1862 séparait la recherche, la fabrication des index et la consultation de l’objet ; le droit restait appliqué sur l’objet, mais l’index devait recevoir assez d’information pour ne pas divulguer trop tôt.
- Le rapport conservait un désaccord réel entre une réponse identique pour tous, utile à la manière du DNS, et les systèmes documentaires qui refusent même d’avouer qu’un dossier protégé existe.
- Un résultat attestait seulement la réponse d’un index, dans un contexte et à un instant donnés ; il ne prouvait ni visibilité universelle, ni autorisation, ni emplacement actuel, ni intégrité, ni exhaustivité.
Le titre secret que le serveur n’avait pas encore protégé
Un serveur peut refuser impeccablement l’ouverture d’un document et avoir déjà perdu l’essentiel. L’index a montré son titre, son auteur ou sa relation avec une affaire sensible. Le refus intervient sur le contenu ; la fuite s’est produite dans le catalogue.
Le RFC 1862 formule cette séparation sans confier toute l’autorité à l’index. Le contrôle d’accès doit être effectué sur l’objet, dit le rapport, mais l’information de contrôle doit aussi se propager dans les index. Ceux-ci doivent pouvoir répondre que la question n’est pas autorisée avant que l’utilisateur ne tente la consultation.
Deux décisions apparaissent. L’autorité de l’objet décide si elle sert une représentation. L’opérateur de l’index décide ce que la requête peut apprendre au sujet de l’existence et du chemin vers cet objet. Les politiques peuvent être coordonnées ; les responsabilités ne deviennent pas interchangeables.
Une conversation d’architecture, pas une loi du réseau
L’IAB avait réuni l’atelier chez MCI, à Tysons Corner, du 12 au 14 octobre 1994. Trente-quatre participants, répartis en trois groupes, venaient notamment du Web, de Gopher, de WAIS, des noms, de la recherche, de l’indexation et des bibliothèques, avec des membres de l’IAB et des responsables de domaines de l’IESG.
Le texte publié en novembre 1995 rend compte de leurs accords, de leurs divergences et de recommandations de recherche. La notice du RFC Editor le classe « Informational » et le document déclare ne spécifier aucune norme Internet. Les contraintes logistiques avaient en outre laissé de nombreux experts hors de la salle.
On peut donc y lire une carte précoce des problèmes, non la preuve qu’une architecture fut déployée. La publication stabilisa le débat ; elle ne transforma ni les participants en représentants universels ni leurs propositions en obligation.
Chercher revenait à interroger des répertoires
Le groupe 2B commença par distinguer les opérations. Chercher consistait à parcourir des répertoires pointant vers l’information. Indexer consistait à analyser l’information pour créer ces répertoires. Un répertoire unifié combinait plusieurs index.
Le résultat était donc un objet intermédiaire. Il pouvait contenir un nom, un emplacement, un type, un résumé ou un lien, sans être le document. Il pouvait dater, employer le vocabulaire d’une autre communauté ou provenir d’un catalogue humain plutôt que d’un calcul automatique. L’obtenir ne constituait pas une consultation.
Le rapport ne cherchait pas un protocole unique de recherche. Les techniques et leurs qualités différaient trop. Il souhaitait plutôt que les résultats puissent être fusionnés grâce à des formats communs, par exemple des URN. La coordination portait sur la comparabilité des enregistrements, non sur la création d’un moteur souverain.
Qui paie le passage du robot ?
L’indexation répétée du même contenu paraissait gaspilleuse. Tant que le coût marginal restait invisible, plusieurs services pouvaient parcourir les mêmes serveurs. Avec une tarification à l’usage, le fournisseur d’information risquait pourtant de payer pour le travail d’indexeurs tiers.
Le groupe estima que le fournisseur devait généralement garder la maîtrise de la manière dont son information était indexée. Il préférait un résumé calculé localement puis transmis au serveur de recherche à un robot obligé de parcourir le réseau. Le choix distribuait le coût et la capacité de divulgation vers l’acteur qui connaissait l’objet.
Il ne rendait pas le résumé infaillible. Un éditeur peut omettre ce qui le gêne ; un robot indépendant peut franchir une limite, conserver une ancienne version ou imposer sa facture à autrui. L’origine de la notice — éditeur, humain, robot ou autre index — doit donc rester attachée au résultat.
On ne cherchait jamais « tout Internet »
Le RFC jugeait trompeuse l’expression « chercher Internet ». Une requête explorait certains espaces publics. La frontière entre espaces publics et privés restait à étudier.
Cette limite change le sens du vide. Aucun résultat peut signifier que rien n’existe dans l’espace couvert, que l’index ignore cet espace, que son vocabulaire diffère, que la mise à jour n’est pas arrivée, que la politique cache l’entrée à cette personne ou que le service a échoué. Le silence n’est pas un inventaire mondial.
Un résultat positif reste tout aussi borné. Il montre qu’un répertoire a renvoyé une notice. Il ne garantit pas que le contenu est public, actuel ou authentique, ni que l’adresse fonctionne, ni que le demandeur possède un droit d’usage.
Même réponse pour tous, ou existence cachée
Une proposition de l’atelier voulait qu’une requête produise le même résultat quel que soit le demandeur. Le DNS montrait l’intérêt d’une réponse indépendante de l’identité : elle se compare, se met en cache et se diagnostique plus facilement.
Mais certains systèmes d’archives d’entreprise ne souhaitaient pas révéler l’existence de documents interdits. Une liste identique pour tous exposerait le secret avant que le serveur de documents puisse le protéger.
Le texte ne tranche pas cette tension par un slogan. Un refus explicite aide un utilisateur légitime à comprendre la panne, mais confirme qu’une règle protège quelque chose. La dissimulation limite cet indice, mais rend « aucun résultat » opaque. Personnaliser les réponses exige en outre d’identifier le demandeur et peut multiplier les journaux de requêtes. Le modèle de menace doit précéder le choix.
Un nom n’était ni un lieu ni un droit
La séparation devenait plus nette dans les travaux contemporains sur les identifiants. Le RFC 1737 distinguait l’URN qui nomme la ressource, l’URL qui désigne un emplacement ou un contenant, et l’URC qui porte des caractéristiques telles que le propriétaire, l’encodage, le coût ou les restrictions d’accès. Une ressource nommée pouvait avoir zéro, un ou plusieurs emplacements.
Le RFC 1630 proposait une syntaxe commune sans prétendre donner les mêmes propriétés à tous les noms et adresses : chaque schéma gardait ses conventions. Le RFC 1738 avertissait ensuite qu’une URL ne garantissait pas de continuer à pointer vers le même objet. Une URL NNTP pouvait même désigner un serveur réservé aux clients locaux.
Une notice ne peut donc emprunter l’autorité des champs qu’elle assemble. Le nom persistant n’est pas l’emplacement actuel ; l’emplacement n’est pas l’autorisation ; une mention de restriction n’est pas l’application de la règle.
La mise à jour faisait partie de la réponse
Pour la résolution des URN, RFC 1862 insistait sur deux problèmes simultanés : effectuer la recherche en base et entretenir cette base. Résoudre vite sans savoir corriger produirait une certitude périmée.
Il en va de même pour l’index. Qui retire l’ancien emplacement ? Qui répercute une nouvelle classification dans les répliques ? Combien de temps une notice cachée peut-elle survivre ? Un index fusionné conserve-t-il la restriction de sa source ? L’accès n’est cohérent que si un acteur répond de chaque transition.
La bonne preuve reste donc modeste : tel index, alimenté par telle source, sous telle politique, a rendu telle notice à tel moment. Tout le reste — identité du contenu, emplacement actuel, permission, intégrité et exhaustivité — demande un autre témoin.
Le RFC 1862 ne livra pas un système achevé. Il montra pourquoi le catalogue devait être gouverné avant même que le document ne s’ouvre.
Sources
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance