
Zusammenfassung
- RFC 1862 unterschied Suche, Indexierung und Objektabruf. Die endgültige Zugriffskontrolle blieb am Objekt, doch Einschränkungen sollten bis zum Index gelangen, weil bereits die Existenz schutzwürdig sein konnte.
- Der Workshop hielt den Konflikt zwischen identischen, DNS-ähnlichen Antworten und privaten Aktensystemen fest, die unbefugten Personen nicht einmal die Existenz eines Dokuments bestätigen dürfen.
- Ein Treffer belegte nur, was ein bestimmter Index zu einem Zeitpunkt, in einem Umfang und unter einer Richtlinie ausgab; er bewies weder universelle Existenz noch Erlaubnis, aktuellen Ort, Inhaltsidentität, Wahrheit oder Vollständigkeit.
Wenn die Ablehnung nach der Offenlegung kommt
Eine Angestellte sucht nach dem Namen einer internen Untersuchung. Der Dokumentserver verweigert ihr den Inhalt ordnungsgemäß. Doch die Trefferliste hat bereits Aktenzeichen, Eigentümer und Datum gezeigt. Die Kontrolle am Objekt war korrekt, nur schützte sie nicht die vorgelagerte Aussage des Katalogs.
RFC 1862 zog genau diese Grenze. Zugriffskontrolle müsse am Objekt durchgeführt werden, hieß es; die dafür nötigen Informationen sollten zugleich durch die Indizes weitergegeben werden. So könne ein Index mitteilen, dass die Frage nicht erlaubt sei, bevor ein Nutzer den Abruf versuche.
Der Index ersetzte die Autorität des Objekts nicht. Der Objektserver entschied über Bytes oder Darstellung. Der Index entschied, welche Namen, Beschreibungen und Hinweise auf Orte eine Anfrage erfahren durfte. Gemeinsame Regeln machten daraus nicht dieselbe Entscheidung.
Eine Werkstattnotiz, kein Internetgesetz
Die IAB veranstaltete den Workshop vom 12. bis 14. Oktober 1994 bei MCI in Tysons Corner, Virginia. Vierunddreißig Teilnehmer arbeiteten in drei Gruppen. Vertreten waren Erfahrungen mit Web, Gopher, WAIS, Benennung, Suche, Indexierung und Bibliotheksdiensten sowie Mitglieder der IAB und zuständige IESG Area Directors.
Der Bericht erschien im November 1995. Der RFC-Editor-Eintrag führt ihn als Informational; das Dokument selbst legt keinen Internet Standard fest. Logistische Grenzen hatten weitere Fachleute von der Teilnahme ausgeschlossen.
Damit belegt der Text, welche Probleme die Beteiligten bereits sahen. Er belegt weder spätere Umsetzung noch vollständige Einigkeit oder allgemeine Verpflichtung. Gerade als Protokoll offener Entscheidungen ist er historisch belastbar.
Gesucht wurde in Verzeichnissen
Der Bericht definierte Suche als Durchsicht von Verzeichnissen, die auf Information verweisen. Indexierung war das Scannen von Information, um solche Verzeichnisse zu erzeugen. Mehrere Indizes ließen sich zu einem einheitlichen Verzeichnis verbinden. Der Treffer blieb deshalb ein Datensatz über einen Verweis, nicht das verwiesene Objekt.
Daraus folgen klare Grenzen. Ein Eintrag ist keine Leseberechtigung. Ein aufgelöster Ort garantiert nicht, dass dort noch derselbe Inhalt liegt. Ein leeres Ergebnis beweist keine Nichtexistenz: Der Raum kann außerhalb der Abdeckung liegen, die Aktualisierung fehlen, der Dienst gestört oder die Antwort absichtlich verborgen sein.
Menschlich kuratierte Indizes konnten nach Einschätzung des Workshops höhere Qualität liefern, kosteten aber Arbeit. Maschinelle Indizes skalierten besser, hatten nicht zwingend dieselbe Urteilskraft. Gemeinsame Formate wie URNs sollten das Zusammenführen erleichtern. Das war ein Interoperabilitätsziel, kein Nachweis eines vollständigen Weltkatalogs.
Wer den Roboter laufen lässt, verteilt auch Kosten
Die allgemeine Tendenz ging dahin, dem Informationsanbieter Kontrolle über die Indexierung zu geben. Statt einen Roboter ständig durchs Netz laufen zu lassen, könne der Anbieter eine lokale Zusammenfassung erstellen und an den Index senden. Das spare Netz- und Serverlast und gebe dem Anbieter Einfluss auf Beschreibung und Sichtbarkeit.
Dies war ein Vorschlag, keine dokumentierte allgemeine Praxis. Er machte jedoch einen Anreizkonflikt sichtbar: Der Aggregator erhielt den Nutzen der Auffindbarkeit, während Anbieter Bandbreite, Rechenaufwand, Aktualisierung und Offenlegungsrisiko tragen konnten. Die lokale Zusammenfassung koppelte einen Teil der Entscheidung wieder an den Kostenträger.
Auch der Anbieter war nicht neutral. Er konnte auslassen, verzögern oder beschönigen. Ein unabhängiger Index konnte breiter erfassen, dafür veraltete Einträge bewahren oder ungewollte Entdeckung ermöglichen. RFC 1862 löste den Gegensatz nicht; es legte seine Kosten offen.
„Das Internet durchsuchen“ war zu groß formuliert
Der Workshop hielt die Wendung „das Internet durchsuchen“ für unpassend. Tatsächlich wurden bestimmte öffentliche Informationsräume durchsucht. Selbst die Grenze zwischen öffentlichen und privaten Räumen bedurfte weiterer Forschung. Ein Index sprach nur für seine Abdeckung, Quellen, Aktualisierung und Antwortregeln.
Darum ist Null ohne Kontext mehrdeutig. Es kann Nichtaufnahme, Richtlinienschweigen, anderen Namen, Verzögerung oder Störung bedeuten. Auch ein positiver Treffer bleibt lokal: Er belegt einen zurückgegebenen Verweis, nicht Zustimmung anderer Verzeichnisse, Abrufrecht oder unveränderten Inhalt.
Gleiche Antwort für alle oder verborgene Existenz
Eine Position verlangte eine vom Fragenden unabhängige Antwort, ähnlich dem DNS. Das erleichterte Caching, Reproduzierbarkeit und einen gemeinsamen Namensraum. Die Gegenposition verwies auf Unternehmensarchive, in denen schon die Bestätigung einer Akte unzulässig sein konnte.
Identitätsabhängige Antworten erforderten Erkennung des Fragenden, konnten Abfragen protokollieren und erschwerten Cache und Audit. Weil der Bericht auch Anonymität schätzte, hatte zusätzliche Vertraulichkeit einen Datenschutzpreis. Identische Antworten wiederum konnten empfindliche Metadaten verraten. Der Bericht bewahrte den Konflikt, statt einen Scheinkonsens zu erzeugen.
Name, Ort und Einschränkung waren verschiedene Dinge
RFC 1737 trennte den dauerhaften Ressourcennamen URN, den Ort URL und Metadaten im URC, zu denen Zugriffsbeschränkungen und Kosten gehören konnten. Eine Ressource konnte keinen, einen oder mehrere Orte besitzen. Namensauflösung war daher weder Erlaubnis noch Inhaltsgarantie.
RFC 1738 warnte, dass eine URL künftig nicht dasselbe Objekt liefern müsse, und nannte NNTP-Artikel, die nur lokal verfügbar sein konnten. RFC 1630 bot eine gemeinsame Syntax, ohne allen Namen und Adressen gleiche Eigenschaften zuzuschreiben; Sicherheit wurde dort nicht behandelt.
Gemeinsam ergeben die Texte eine Beweiskette: Der Index beschreibt, die Auflösung nennt einen möglichen Ort, das Objekt trifft die letzte Entscheidung. Kein erfolgreiches Glied ersetzt den Nachweis des folgenden.
Auflösung ohne Pflege blieb eine halbe Infrastruktur
RFC 1862 verlangte für URNs sowohl Nachschlagen als auch Aktualisieren. Ohne Pflege erschienen alte Orte, zurückgezogene Zusammenfassungen und frühere Beschränkungen als Gegenwart. Aktualisierung war kein Nebenbetrieb, sondern bestimmte die zeitliche Aussage eines Ergebnisses.
Eine belastbare Beobachtung nennt deshalb Uhrzeit, Index, Umfang und Identitätskontext. Ändert sich der Treffer, können Objekt, Zuordnung, Index oder Richtlinie die Ursache sein. Die Aussage, „das Internet“ habe etwas entfernt, würde gerade die untersuchbaren Schichten verwischen.
Was ein Treffer tatsächlich trägt
Die saubere Aussage lautet: Dieser Index lieferte zu diesem Zeitpunkt unter diesen Bedingungen diesen Datensatz. Daraus folgen nicht universelle Sichtbarkeit, Leseerlaubnis, dauerhafter Ort, unveränderter Inhalt oder Nichtexistenz bei einem Nullergebnis.
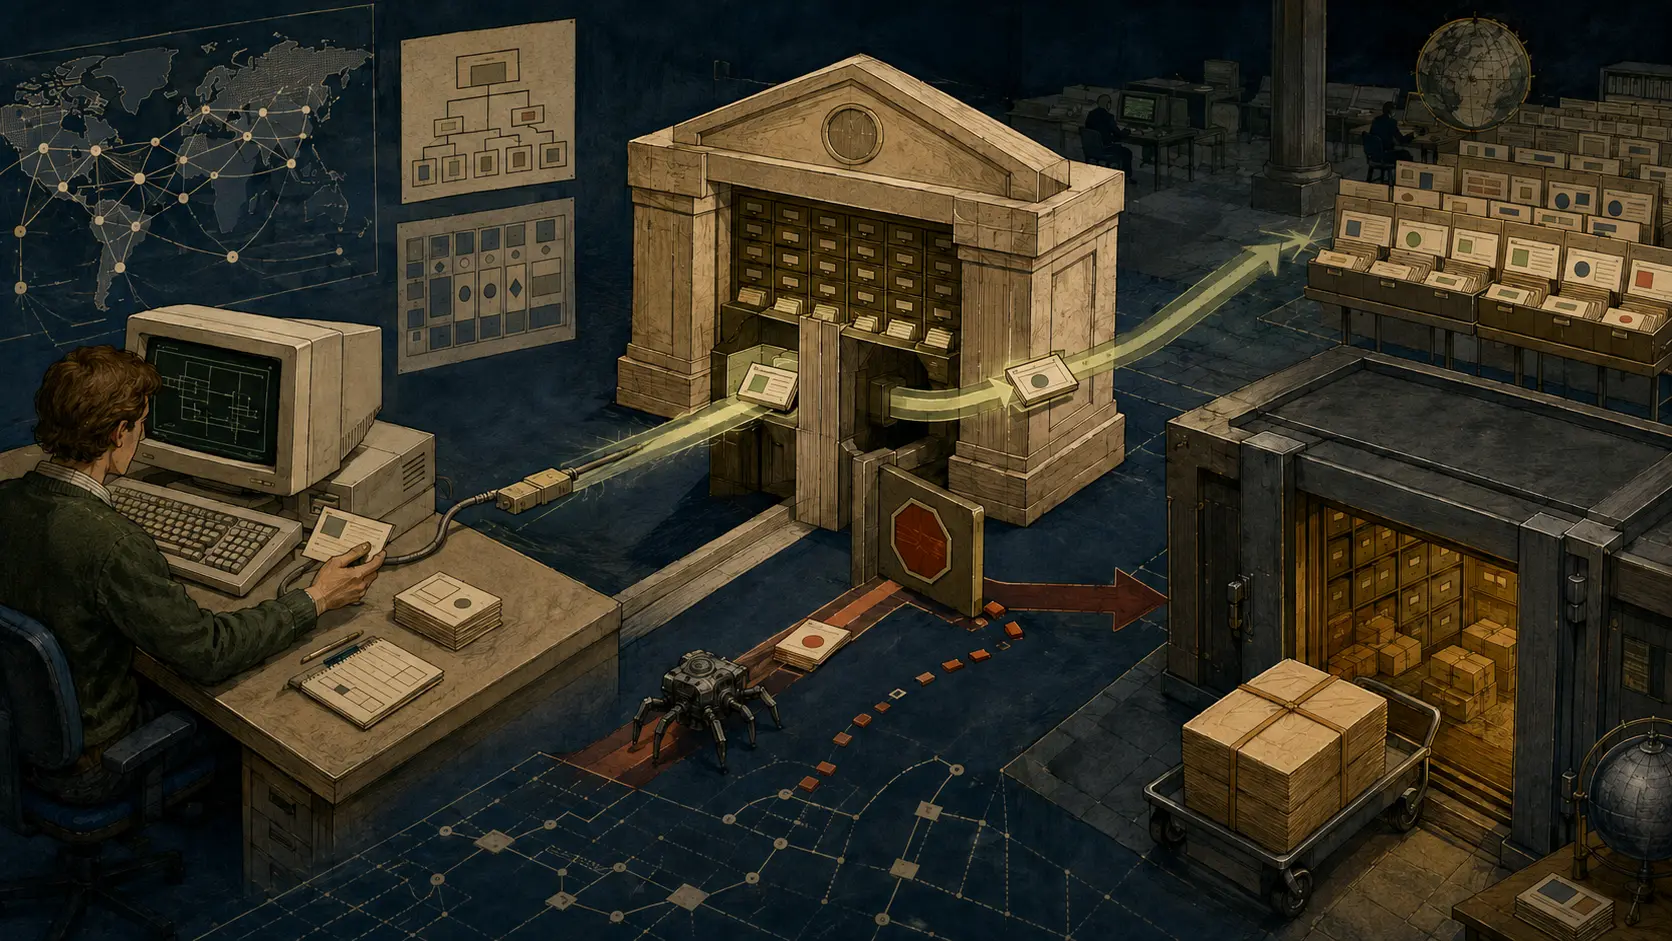
RFC 1862 war kein Bauplan für heutige Suchdienste. Seine historische Stärke liegt in der Trennung von Entdeckung, Lokalisierung und Abruf. Das Tor des Indexes ersetzte das Schloss am Dokument nicht. Es zeigte, dass Offenlegung schon beginnt, bevor jemand dieses Schloss erreicht.
Quellen
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten