Summary
- Dans son guide de 2001, Google présentait le lien « cached » comme une façon de lire l'instantané d'une page même lorsque le site d'origine était inaccessible. La recherche offrait ainsi un autre accès à un contenu publié ailleurs.
- Les consignes de Google de 2007 et 2010 distinguaient la page en ligne, sa fiche dans l'index, son extrait et sa copie. En 2024, l'entreprise a retiré le lien vers la copie des résultats puis abandonné l'opérateur
cache:; une URL pouvait toujours rester dans les résultats.
Le serveur de l'éditeur ne répond pas. Dans la recherche Google du début des années 2000, cela ne condamnait pas forcément la lecture. Le guide Google de 2001 invitait à ouvrir une version « cached » : un instantané conservé par le moteur, avec les mots cherchés mis en évidence. La promesse avait la modestie d'une astuce pratique. Elle donnait pourtant à Google une place nouvelle entre l'auteur d'une page et son lecteur : celle qui fournit la copie de secours.
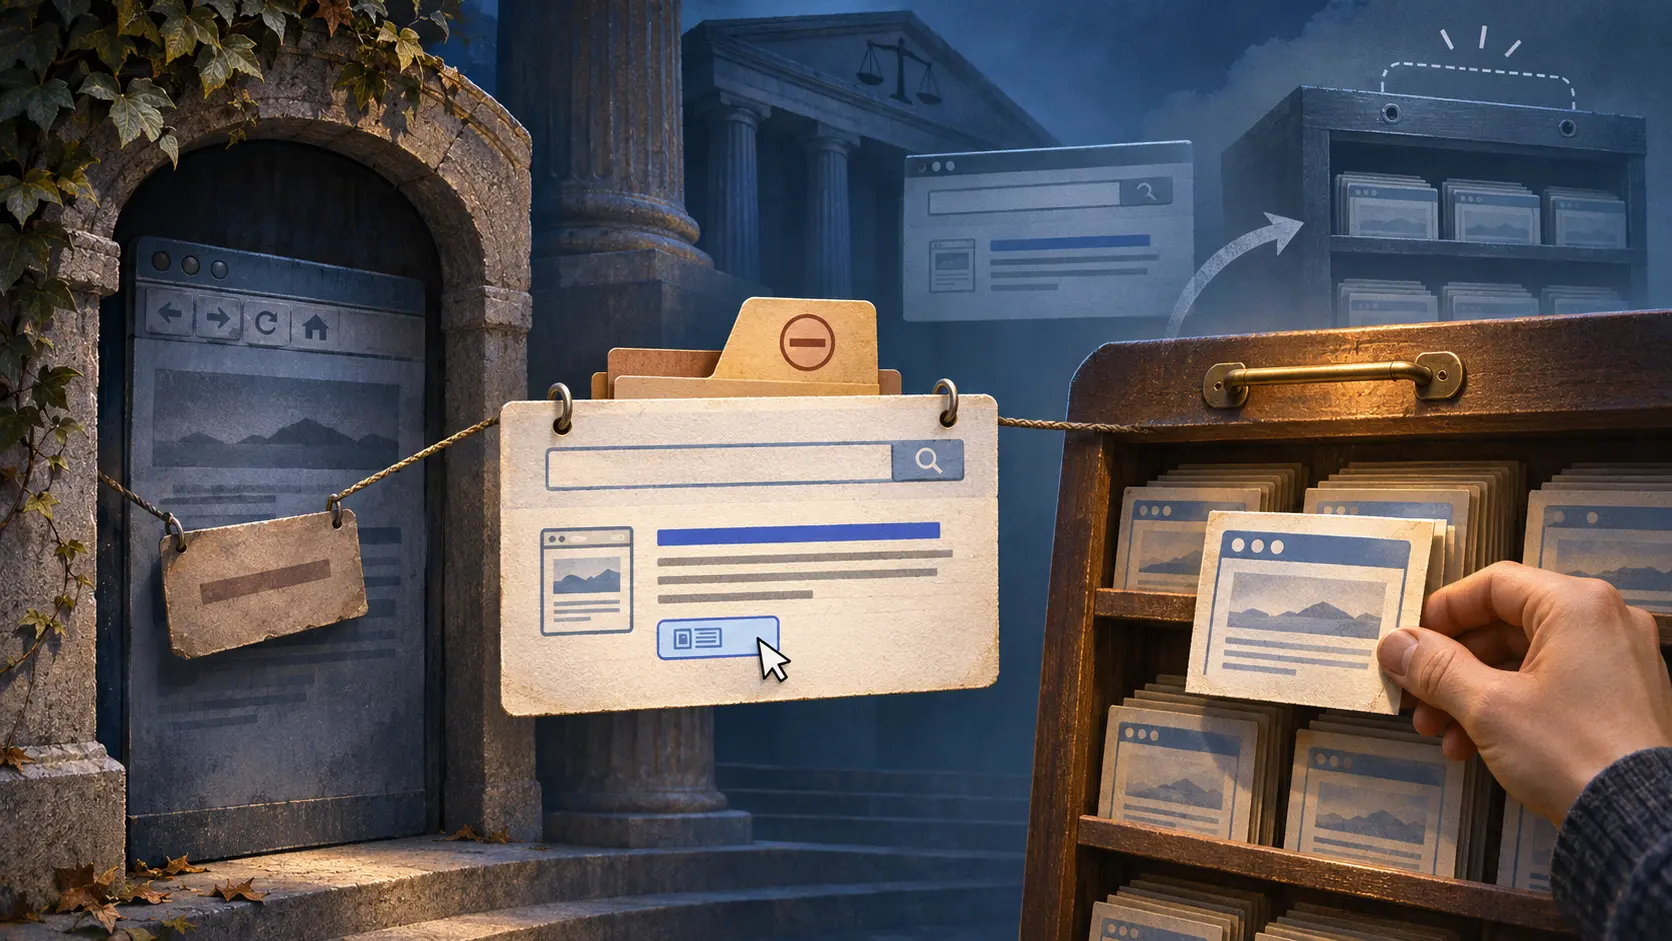
Une URL se retrouvait alors sur trois scènes. Le site de l'éditeur affichait sa version actuelle. L'index de recherche montrait le titre et l'extrait. Le lien de cache menait à un état antérieur stocké par Google. Ces scènes ne se mettaient pas à jour ensemble. Un site pouvait tomber en panne tandis que son instantané restait lisible. Il pouvait aussi être corrigé sans que l'ancienne phrase disparaisse aussitôt du résultat.
Les instructions de retrait publiées en 2007 traitaient la copie comme un objet distinct. Pour qu'elle ne soit plus proposée, l'éditeur pouvait ajouter la balise noarchive à sa page, puis demander un retrait accéléré. Si le contenu avait changé, il pouvait faire supprimer l'ancienne copie après vérification de la différence avec la page en ligne. Google précisait que la nouvelle version du cache pourrait réapparaître six mois plus tard ou après un nouveau passage de son robot. Retirer la copie vieillie ne revenait pas à faire disparaître la fiche de recherche.
Cette procédure répartissait le pouvoir et le délai. L'éditeur modifiait sa page et posait une consigne ; Google décidait quand son robot ou son outil de retrait la refléterait dans son produit ; le lecteur voyait le résultat de cette synchronisation. Posséder le texte original ne donnait pas la main immédiate sur la version déjà exposée par un autre serveur.
En 2010, Google expliquait le retrait de passages sensibles. L'ancien extrait et l'ancienne copie pouvaient persister jusqu'à un nouveau passage du robot. Un propriétaire de site vérifié pouvait accélérer leur retrait, mais le titre et l'URL pouvaient rester visibles. Le même texte rappelait l'intérêt inverse du cache : donner accès à une page lorsque le serveur d'origine est indisponible. Le service utile au lecteur et la correction exigée par l'éditeur portaient sur le même instantané.
Puis Google a fermé cette porte au lecteur. Dans ses permanences d'avril 2024, un représentant indiquait que l'entreprise avait commencé à retirer des résultats le lien vers la version en cache, tandis que l'index et l'extrait pouvaient subsister. Le journal des changements a ensuite daté deux décisions : le 24 septembre, l'opérateur cache: ne fonctionnait plus ; le 2 octobre, noarchive passait dans la documentation historique parce que le lien de cache avait disparu des résultats.
Ce journal ne dresse pas l'inventaire des copies internes de Google. Il décrit avec précision ce que le public a perdu : le chemin affiché dans la recherche vers l'instantané de Google. Il rappelle aussi que d'autres services pouvaient encore tenir compte de noarchive. Le bouton qui venait de disparaître n'épuisait donc pas toutes les questions de copie sur le Web.
Le premier guide avait confié au lecteur une issue lorsque le site d'origine était fermé. Les outils de retrait avaient donné à l'éditeur une voie de contestation, avec Google comme opérateur du délai. Enfin Google a retiré l'issue de ses résultats. La page était écrite ailleurs ; la porte de secours, elle, appartenait au moteur.
Documents originaux
- Guide Google de 2001 : l'instantané accessible quand le site d'origine ne répond pas.
- Consignes de retrait de 2007 et explication de 2010 :
noarchive, nouvelle exploration et distinction entre copie et résultat. - Permanences d'avril 2024 et journal de documentation de 2024 : disparition du lien et de l'opérateur
cache:.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé au Cercle stratégique
Cercle stratégique
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre le Cercle stratégiqueRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance