Summary
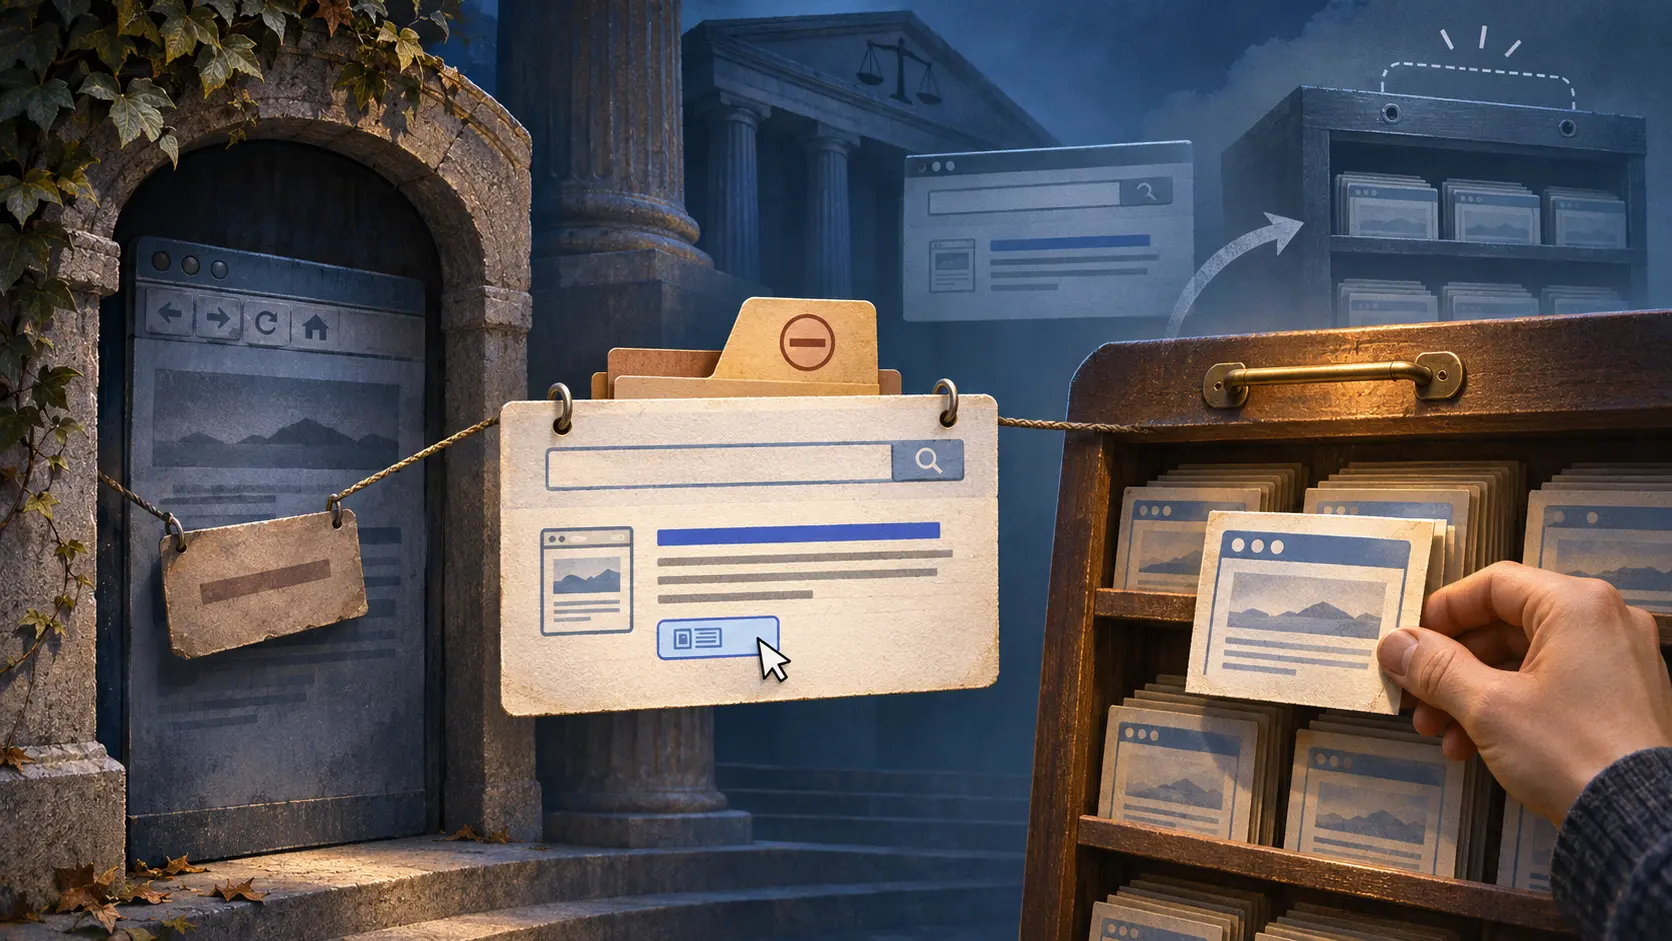
- En su guía de 2001, Google presentaba el enlace «cached» como una captura que podía leerse incluso si la web original no estaba disponible. La ficha del buscador conducía así tanto al editor como a una copia en manos de Google.
- Las instrucciones de Google de 2007 y 2010 separaban la página viva, la ficha indexada, el fragmento y la copia. En 2024 retiró el enlace a la copia de los resultados y dejó de funcionar el operador
cache:; la dirección original podía seguir indexada.
Una web podía fallar y, aun así, entregar algo al lector. El manual de búsqueda de Google de 2001 enseñaba a pulsar «cached» para ver una captura de la página cuando el sitio real no estaba accesible. La captura resaltaba los términos buscados. Aquella línea bajo el resultado era útil de una manera muy concreta: permitía leer mientras el servidor del editor guardaba silencio.
Pero el resultado reunía cosas que vivían en relojes distintos. La web del editor mostraba lo que había publicado ahora. El índice de Google conservaba un título y un fragmento. El enlace de caché llevaba a una versión anterior almacenada por otra empresa. Si el editor corregía un error o retiraba un dato, la copia no cambiaba por arte de magia. La misma duplicación que salvaba una lectura durante una avería podía enseñar después un texto vencido.
Google describió una salida para el editor en sus instrucciones de retirada de 2007. Una etiqueta noarchive en la página, combinada con una solicitud urgente, permitía quitar la copia almacenada. Si el editor ya había cambiado el contenido, podía pedir la retirada de la versión antigua una vez que Google comprobara la diferencia. La empresa advertía que la copia más reciente podía reaparecer tras seis meses o cuando el robot volviera a visitar la página. Retirar una captura vieja y retirar la dirección del buscador eran trabajos separados.
Ahí se ve el reparto del mando. El editor decide qué dice su servidor y puede dejar una instrucción para el robot. Google controla cuándo su propia ficha y su propia copia reflejan esa instrucción. El lector recibe una u otra versión según el momento en que se cruzan los dos sistemas. Nadie había escrito un gran tratado en la palabra «cached», pero contenía una disputa práctica sobre la vigencia de una página.
La explicación de Google de 2010 sobre textos sensibles siguió esa separación. Tras una corrección, podían persistir el fragmento y la copia anteriores hasta que Google rastreara de nuevo la URL. El propietario verificado podía acelerar la retirada de ambos; el título y la dirección podían continuar en los resultados. Google defendía al mismo tiempo la utilidad de la copia si el servidor de origen no respondía. La ayuda al lector y la necesidad del editor de borrar una frase antigua recaían sobre el mismo objeto.
En 2024 cambió la parte visible para el público. En sus sesiones de preguntas de abril, un portavoz de Google dijo que la empresa había empezado a retirar el enlace a la versión en caché, aunque podían permanecer la URL indexada y su fragmento. El registro oficial de cambios fechó el resto: el 24 de septiembre dejó de funcionar cache: y el 2 de octubre noarchive pasó a la sección histórica porque el enlace a la copia ya no estaba en los resultados.
Los documentos hablan del acceso público desde Google Search. No enumeran todas las copias que sus sistemas pudieran guardar para otros fines. Para quien buscaba una página durante una caída, el efecto era más sencillo: desapareció la puerta que el manual de 2001 había recomendado. Google añadió que otros servicios podían seguir atendiendo noarchive, de modo que su cambio no anulaba toda razón posible para conservar la etiqueta.
La dirección de la página podía seguir en pantalla. Lo que se fue fue la posibilidad de abrir desde ese resultado la instantánea de Google. El editor poseía la página; el buscador había sido dueño del segundo picaporte.
Documentos originales
- Guía de Google de 2001: la captura como vía de lectura si falla la web original.
- Instrucciones de retirada de 2007 y explicación de 2010: etiqueta
noarchive, rastreo y diferencias entre copia, fragmento e índice. - Preguntas de abril de 2024 y registro de cambios de 2024: retirada del enlace público y del operador
cache:.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para el Círculo Estratégico
Círculo Estratégico
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete al Círculo EstratégicoSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance