Summary
- 2015 年,W3C 首份公开草案把退出登录的家务事摊开:同一网站的数据散落在浏览器不同角落,网页脚本够不到其中一些地方。
- 2017 年工作草案提出
Clear-Site-Data响应头,让网站指明要清理cache、cookies、storage、executionContexts,或者用*请求全部已知类别。
一个人点下退出,页面宣布结束。服务器也许已经让会话失效,但浏览器还可能保留本地数据库、缓存资源和另一个仍在运行的标签页。门口的“下班了”标语贴得再大,也不会自己走进储藏室扫地。
W3C 在 2015 年 8 月公布的首份草案正是从这间储藏室写起。网页脚本能删掉一部分本地数据,却碰不到标为 HttpOnly 的 Cookie;这个限制本来就是为防脚本读取敏感 Cookie。要靠 HTTP 响应逐个使其过期,网站又得记清自己设过哪些 Cookie。缓存、离线数据、页面运行状态另有各自的清理办法。一次登出,被拆成几套不太合群的清洁工具。
草案换了一个发号施令的地方:网站在 HTTP 响应里提出请求,浏览器负责执行。网站知道何时该退出、何时该修复事故;浏览器知道东西放在哪儿。让写纸条的人亲自钻进每个抽屉,原本就不合理。
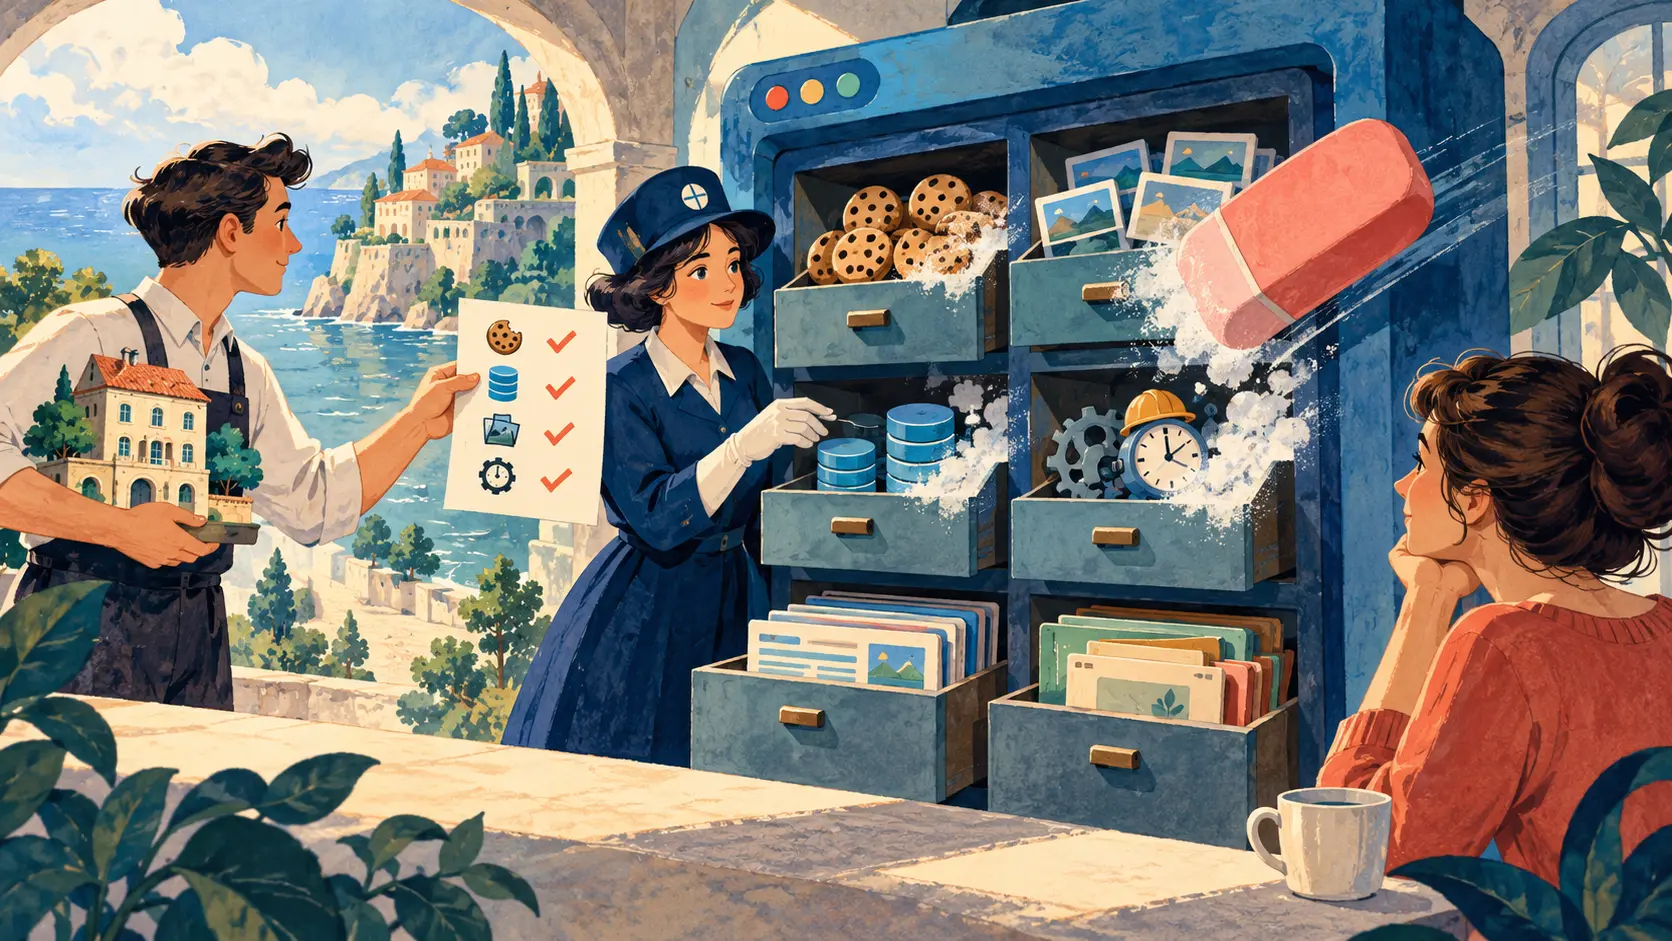
到了 2017 年 11 月的工作草案,纸条有了正式写法。Clear-Site-Data 后面列出带引号的类别:"cookies" 是 Cookie,"storage" 是本地存储,"cache" 是缓存资源,"executionContexts" 涉及还在运行的页面和工作线程。一个响应可以写多个类别。"*" 则要求清掉这套机制认识的全部类别,未来新增类别也包括在内。简短的一行响应头,递给浏览器一张分门别类的打扫清单。
普通的退出可以选择 Cookie 和存储:身份证明与保存在本地的资料一起退场。草案还设想更糟的日子——网站发现攻击者可能把恶意状态留在访问者的浏览器中,便请求更彻底的清理,包括缓存和运行中的环境。两种场景所需的扫帚大小不同,清单让网站把理由落实为具体动作。
抽屉之间的边界也不同。存储按响应的源来认领;Cookie 会跨子域使用,因此草案的 Cookie 清理程序触及整个注册域;网络缓存按主机挑出条目。草案要求由经过认证的安全响应触发清理。一个网站只能请求浏览器处理自己范围内的东西,不能把隔壁网站的文件柜顺手搬空。
最容易被忽略的是还在运行的代码。清掉 Cookie 的一刻,打开着的旧标签页未必停工;工作线程也可能继续持有旧状态。2017 年草案安排先处理相关运行环境,再清除指定数据,并在请求 "executionContexts" 时重新加载受影响的页面。否则刚扫完地,另一个房间又有人把灰倒回来。
清得越广,代价越实在。删掉缓存,下次访问要重新下载资源;删掉同一注册域的 Cookie,多个子域上的会话都可能结束;删掉存储,离线应用积攒的本地资料也会消失。草案把类别分开,是为了让网站按事情大小选择工具,而不是每次退出都拉响全楼的消防警报。
W3C 的发布记录列出 2015、2016、2017 年三次公开工作草案。它们记录了网页逐渐变成应用后的一个新麻烦:浏览器不再只是看一眼就走的窗口,已经是带抽屉、仓库和夜班人员的办公室。退出登录,终于需要一份办公室清场单。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance