
摘要
- RFC 3205 把 HTTP 复用视为一种带有继承行为的架构选择,而不是自动获得互操作或安全性的捷径。
- 它把一项具体责任交给协议设计者:说明服务身份、代理交互、缓存行为,以及 HTTP 错误与应用结果之间的界线。
这笔交易还有另一方
2002 年初,HTTP 为新的应用层协议提供了一套诱人的现成工具:开发者熟悉它,浏览器能够使用它,客户端库和服务器也早已存在。TLS 与熟悉的认证机制有时可以沿用;若组织本来就要运行 Web 服务,同一套基础设施看起来能降低原型开发成本。穿过防火墙也是当时被列举的优势之一。
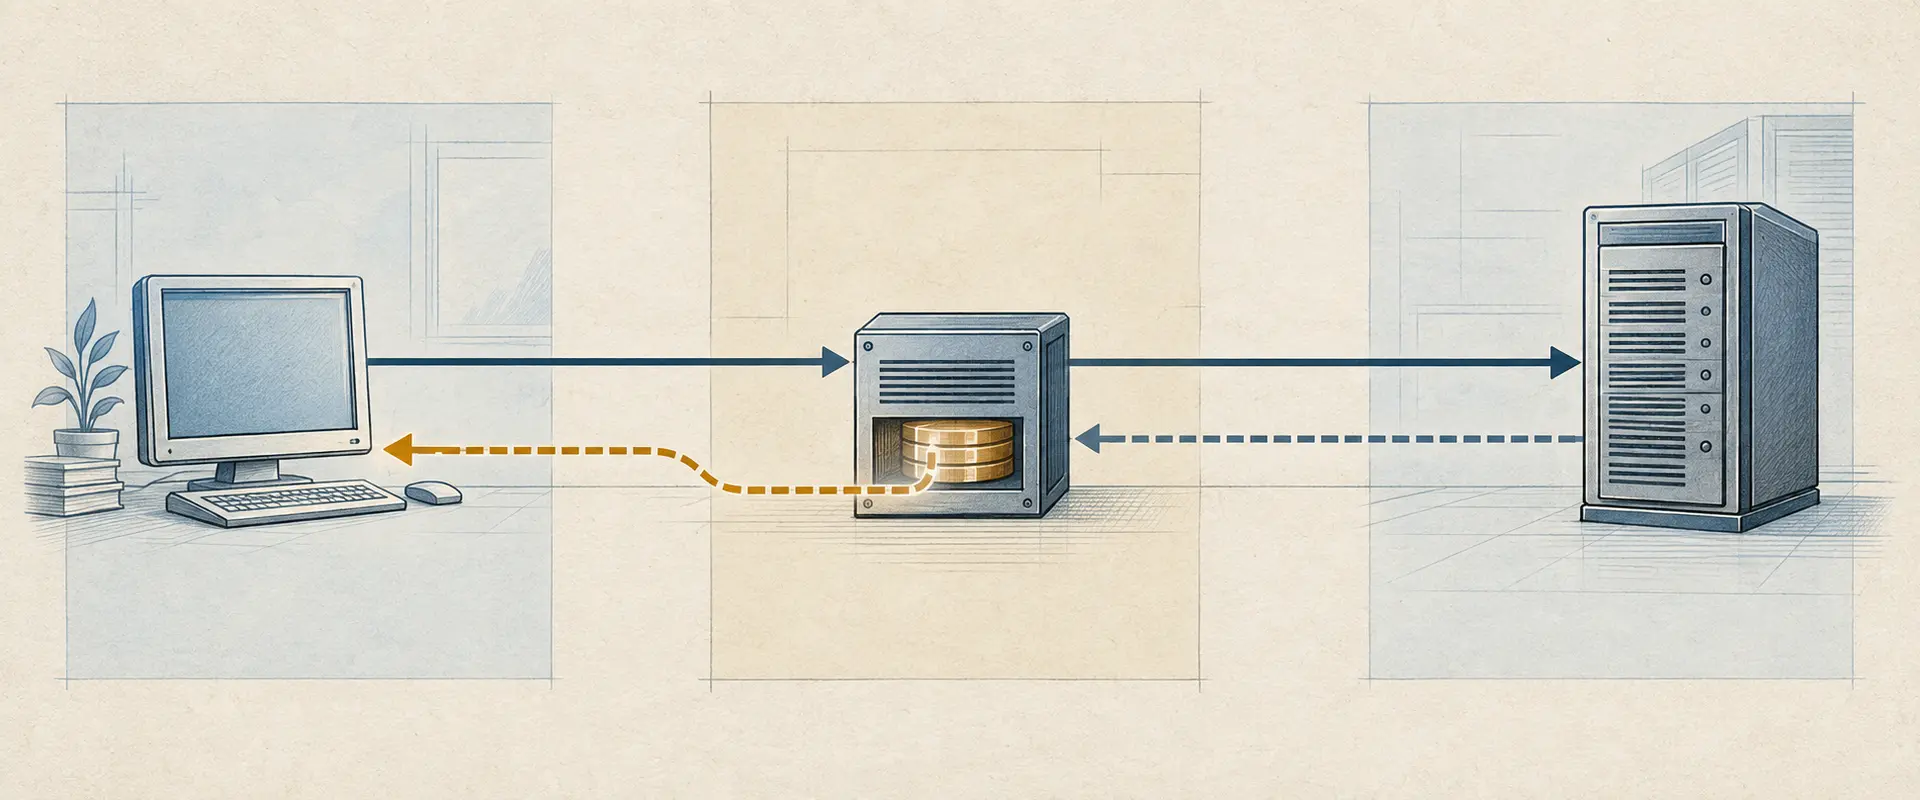
Keith Moore 撰写的 BCP 56 把另一方带进了设计讨论:位于两个应用端点之间的整个 HTTP 生态。一条请求可能先后经过客户端库、代理、缓存、防火墙、地址转换设备、Web 服务器,再到应用代码。每个环节都会按自己熟悉的通用规则解释字段。在一个组件上省下的工作,并不会让其他组件自动理解应用自己的含义。
这份备忘录刻意定位为建议,而非合规性规范;它没有使用 RFC 2119 定义的大写规范用语。因此,它不是在要求所有应用放弃 HTTP,而是在要求把选择的完整成本摊开来看。HTTP 已经累积了持久连接、字节范围、内容协商和缓存等功能。叠加在其上的应用可能继承并不需要的机制,然后花精力加以限制。若交易很小而频率很高,TCP 与 HTTP 的额外开销可能重要;若能在同一条持久连接上完成多次交换,连接成本也可以摊薄。
熟悉的状态码可能讲错故事
问题会出现在 HTTP 层的成功不等于应用层成功时。代理不必理解新应用协议,也能依照 HTTP 规则行事。在适当条件下,它可以缓存一个成功响应,再把它交给相似请求;它也可能替换或补充错误响应的正文。于是客户端得到的 HTTP 响应格式无误,应用层的含义却可能已经过时、被遮蔽或发生改变。
RFC 3205 区分了 HTTP 请求行、请求头中的协议错误与应用正文承载的结果。如果应用用通用的 200 或 500 表达正文处理结果,就必须说明如何避免有害缓存,以及错误正文被中间设备改写时如何继续工作。如果协议无法容忍代理缓存响应或修改错误内容,备忘录建议不要把 HTTP 用作底层承载。问题并不是“HTTP 状态码不好”,而是两层对成功与失败的定义可能不同。
方法和媒体类型也有同样的边界。内容类型说明一个对象是什么,并不会单独授权接收方对它执行什么动作;动作必须明确表达。定义新的 HTTP 方法,也不足以单独决定服务是否需要自己的端口或 URI 方案。
复用也在决定如何标识服务
端口 80 和 http: 对运维人员、软件与用户早已有既定含义。RFC 3205 要求设计者判断:新服务是否拥有独立数据、代码、进程或流量控制需求;若是,专用端口可能更合适。若一种广泛使用的服务有不同的配置、凭证或资源开通方式,也可能需要自己的 URI 方案。这不是命名上的美观问题,而是运营中如何识别服务。
库本身也带着假设。客户端为了调用 HTTP 库,可能先把服务 URI 转成看起来像 HTTP 的地址;随后代理便可能看到完整的绝对 URI,并按普通 Web 请求处理。库可能发送 HTTP/1.1,而应用协议仍须明确这个版本标识在本协议中的含义。应该由规范说明客户端、服务器与代理如何交互,而不是把互操作寄托在对复用代码的乐观猜测上。
因此,复用只是转移成本。既有代码能缩短首个实现的时间,但其通用行为随即进入系统边界。独立实现越多,一个客户端的小捷径就越可能撞上缓存规则或服务器预期。这是对 RFC 3205 设计分析的推论,不是实测开发开销,也不能证明某个具体协议失败过。
后来的规范说明这类问题并未消失
2022 年,RFC 9205 作为 BCP 56 的后继文件取代了 RFC 3205。HTTP 经历二十年演进后,新文件讨论了由不同团队分别实现的 HTTP API、客户端与服务器不同步的演进、扩展机制、缓存、状态、认证,以及协议与 Web 浏览如何共存。它表明这类设计问题值得更新指引;但不能据此断言这些建议已普遍采用,也不能说 2002 年的文件预言了后来所有 API 实践。
更有限、也更可靠的历史结论是:复用协议不会抹去边界,而是把工作移到共享软件的语义上。两个实现可以调用同一套 HTTP 库,仍然对响应代表什么意见不一。要实现互操作,规范必须说明周边 HTTP 组件可以做什么、应用必须做什么,以及每种结果由哪一层负责。
中间设备的体系结构术语见 RFC 3234。当时的 HTTP/1.1 背景见 RFC 2616;RFC 3205 刻意不采用的规范关键词约定见 RFC 2119。权威资料包括 RFC 3205、RFC Editor 记录、IETF Datatracker 记录、RFC 9205 及其 RFC Editor 记录。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance