
Résumé
- La RFC 3205 présente la réutilisation de HTTP comme un choix de conception assorti d’un comportement hérité, et non comme une garantie automatique d’interopérabilité ou de sécurité.
- Elle confie une tâche précise aux concepteurs : documenter l’identité du service, les mandataires, la mise en cache et la frontière entre erreurs HTTP et résultats applicatifs.
La négociation comptait un autre interlocuteur
Au début de 2002, HTTP offrait un ensemble d’outils séduisant pour de nouveaux protocoles applicatifs. Les développeurs connaissaient déjà le protocole ; les navigateurs pouvaient l’utiliser ; serveurs et bibliothèques clientes étaient disponibles. TLS et des mécanismes d’authentification familiers pouvaient parfois être repris. Un service Web existant semblait fournir une base de prototypage à faible coût. Le passage à travers un pare-feu était également présenté comme un avantage.
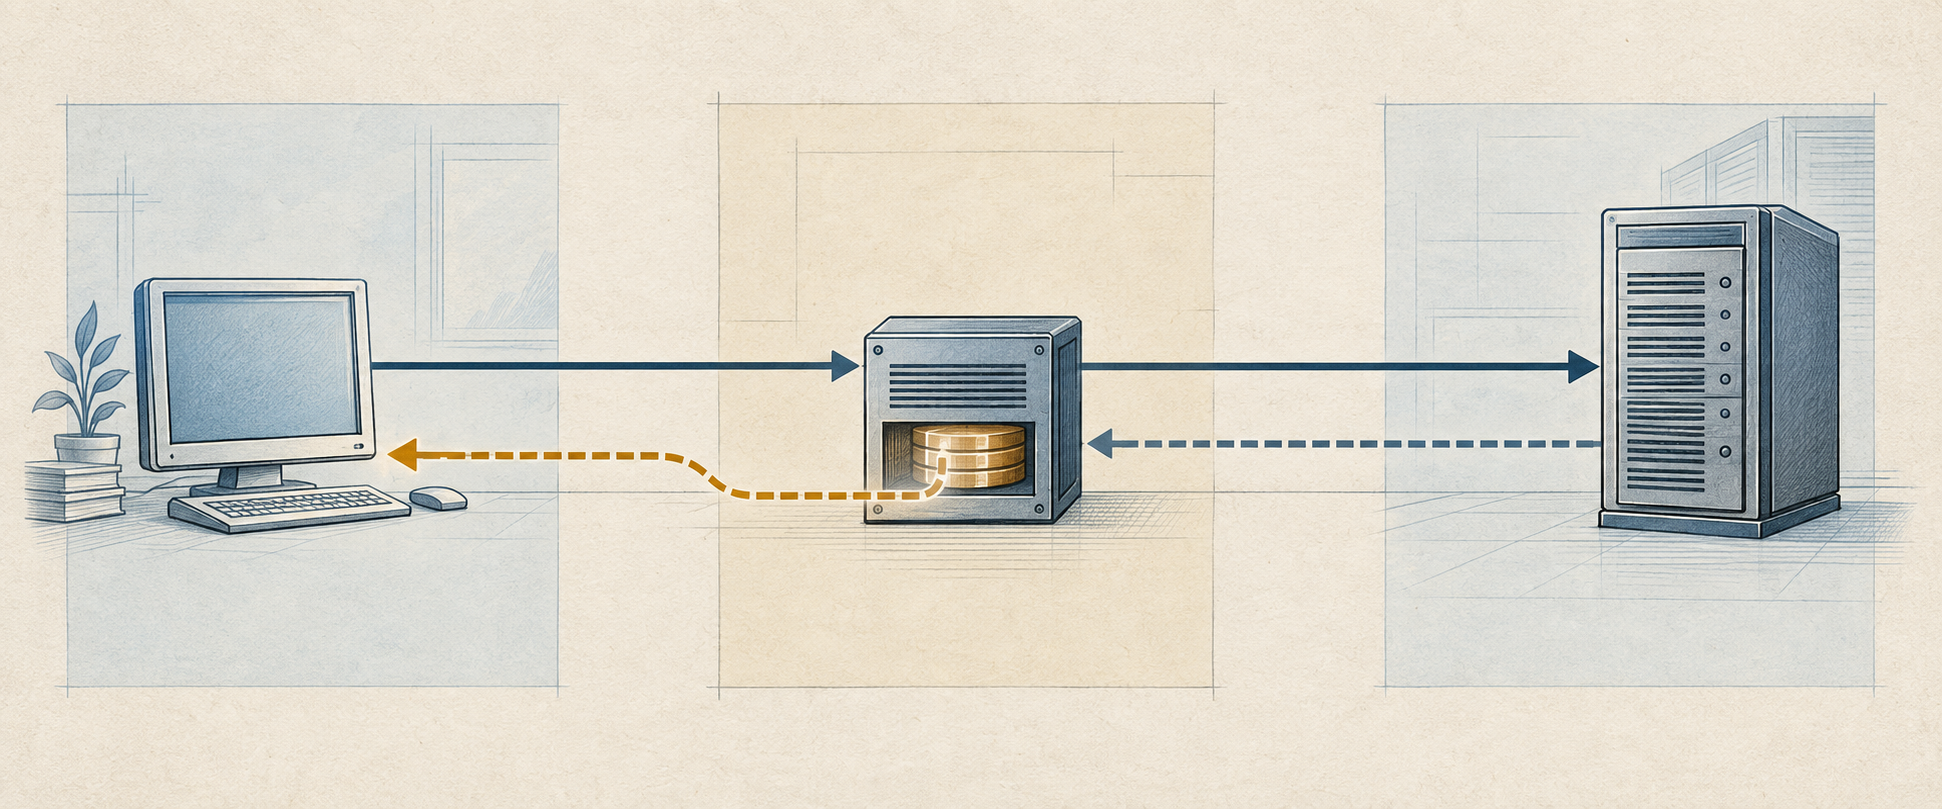
La BCP 56 de Keith Moore rendait visible un interlocuteur moins évident : tout l’écosystème HTTP situé entre les deux applications. Une requête peut traverser une bibliothèque cliente, un mandataire, un cache, un pare-feu, un traducteur d’adresses, un serveur Web puis le code métier. Chacun interprète des champs qui ont déjà un sens générique. Réduire l’effort d’un composant ne suffit pas à faire partager aux autres le sens propre à l’application.
La RFC se présente comme un conseil, et non comme une spécification de conformité ; elle évite délibérément les termes normatifs majuscules de la RFC 2119. Elle ne dit donc pas que toute application doit renoncer à HTTP. Elle demande d’évaluer le coût complet de ce choix. Le protocole avait accumulé des fonctions — connexions persistantes, requêtes par plages, négociation de contenu, caches — qui pouvaient compliquer une couche applicative sans lui être utiles. Pour de petites transactions fréquentes, TCP et HTTP pouvaient ajouter un coût notable ; des connexions persistantes pouvaient, à l’inverse, répartir ce coût sur plusieurs échanges.
Un code d’état familier pouvait raconter la mauvaise histoire
La difficulté apparaissait lorsque le succès HTTP ne correspondait pas au résultat de l’application. Un mandataire n’a pas besoin de connaître le protocole ajouté pour appliquer les règles HTTP. Dans certaines conditions, il peut conserver une réponse réussie puis la restituer à une requête similaire. Il peut aussi remplacer ou compléter le corps d’une réponse d’erreur. Le client reçoit alors une réponse HTTP valide, mais son sens applicatif peut être périmé, masqué ou modifié.
La RFC distinguait les erreurs de la ligne de requête et des en-têtes HTTP des résultats portés par le protocole applicatif. Si ce dernier utilisait les codes génériques 200 ou 500 pour les résultats du corps, sa spécification devait expliquer comment éviter une mise en cache nuisible et comment fonctionner si le corps d’erreur était transformé. Si l’application ne pouvait tolérer ces comportements d’intermédiaire, le conseil était de ne pas prendre HTTP comme support. Le risque ne se résumait pas à « les codes HTTP sont mauvais » : il naissait du décalage entre deux définitions du succès.
La même distinction concernait les méthodes et les types MIME. Un type de contenu indique la nature d’un objet, pas l’opération à exécuter sur celui-ci. L’action doit être explicite. Ajouter une méthode HTTP ne répond pas non plus, à lui seul, à la question du port ou du schéma d’URI qui convient au service.
Réutiliser, c’était aussi choisir une identité
Le port 80 et le schéma http: avaient déjà une signification pour les administrateurs, les logiciels et les usagers. La RFC demandait si un service avait ses propres données, processus, code ou besoins de contrôle du trafic : ces différences pouvaient justifier un port distinct. Un service largement utilisé avec une configuration, des justificatifs ou un provisionnement particuliers pouvait également mériter son propre schéma d’URI. Il s’agissait d’identifier correctement le service dans l’exploitation, pas simplement de choisir un nom élégant.
Les bibliothèques transportaient elles aussi des présupposés. Un client pouvait convertir une URL de service en une URL à allure HTTP pour appeler une bibliothèque ; un mandataire pouvait ensuite voir l’URL absolue et l’interpréter comme une requête Web ordinaire. Une bibliothèque pouvait transmettre HTTP/1.1, même si l’application devait préciser ce que cette étiquette de version signifiait pour elle. La spécification, et non l’espoir placé dans le code réutilisé, devait décrire les échanges entre client, serveur et mandataire.
La réutilisation déplace donc une partie du coût. Le code existant peut accélérer une première implémentation, mais son comportement générique entre alors dans la frontière du système. Plus les implémentations sont indépendantes, plus un raccourci du client peut entrer en conflit avec une règle de cache ou une attente du serveur. C’est une déduction tirée de l’analyse de la RFC, pas une mesure des budgets d’ingénierie ni la preuve qu’un protocole donné ait échoué.
Un successeur montre que le problème a persisté
En 2022, la RFC 9205 a remplacé la RFC 3205 comme BCP 56. Après deux décennies d’évolution de HTTP, elle traite des API fondées sur HTTP déployées par des équipes distinctes, de l’évolution asynchrone des clients et serveurs, de l’extensibilité, des caches, de l’état, de l’authentification et de la coexistence avec la navigation Web. Cette révision montre que le sujet méritait une nouvelle formulation. Elle ne prouve ni l’adoption universelle de ces recommandations ni que le texte de 2002 ait prédit toutes les pratiques ultérieures.
La leçon historique reste circonscrite : réutiliser un protocole ne supprime pas ses frontières ; cela reporte une partie du travail sur les sémantiques du logiciel partagé. Deux implémentations peuvent s’appuyer sur la même bibliothèque HTTP et ne pas s’accorder sur le sens d’une réponse. L’interopérabilité exige donc de préciser le rôle des mandataires, ce que l’application doit faire et la couche responsable de chaque résultat.
Pour le vocabulaire architectural des intermédiaires, voir la RFC 3234. Le contexte HTTP/1.1 de l’époque figure dans la RFC 2616 ; la convention des mots-clés normatifs écartée par la RFC 3205 vient de la RFC 2119. Les documents officiels sont la RFC 3205, sa notice RFC Editor, sa fiche Datatracker, la RFC 9205 et sa notice RFC Editor.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance