
Zusammenfassung
- RFC 3205 behandelte die Wiederverwendung von HTTP als Architekturentscheidung mit übernommenem Verhalten, nicht als automatische Garantie für Interoperabilität oder Sicherheit.
- Die praktische Pflicht lag bei den Designern: Dienstidentität, Proxy-Interaktion, Caching und die Trennlinie zwischen HTTP-Fehlern und Anwendungsergebnissen festzulegen.
An dem Geschäft war noch eine weitere Seite beteiligt
Anfang 2002 bot HTTP ein verlockendes Werkzeugset für neue Anwendungsprotokolle. Entwickler kannten es, Browser konnten es verwenden, und Client- sowie Serverbibliotheken waren bereits verfügbar. Mitunter ließen sich TLS und vertraute Authentifizierungsverfahren ebenfalls nutzen. Wenn eine Organisation ohnehin einen Webdienst betrieb, schien dieselbe Infrastruktur den Prototyp günstiger zu machen. Auch die Durchquerung von Firewalls wurde als Vorteil genannt.
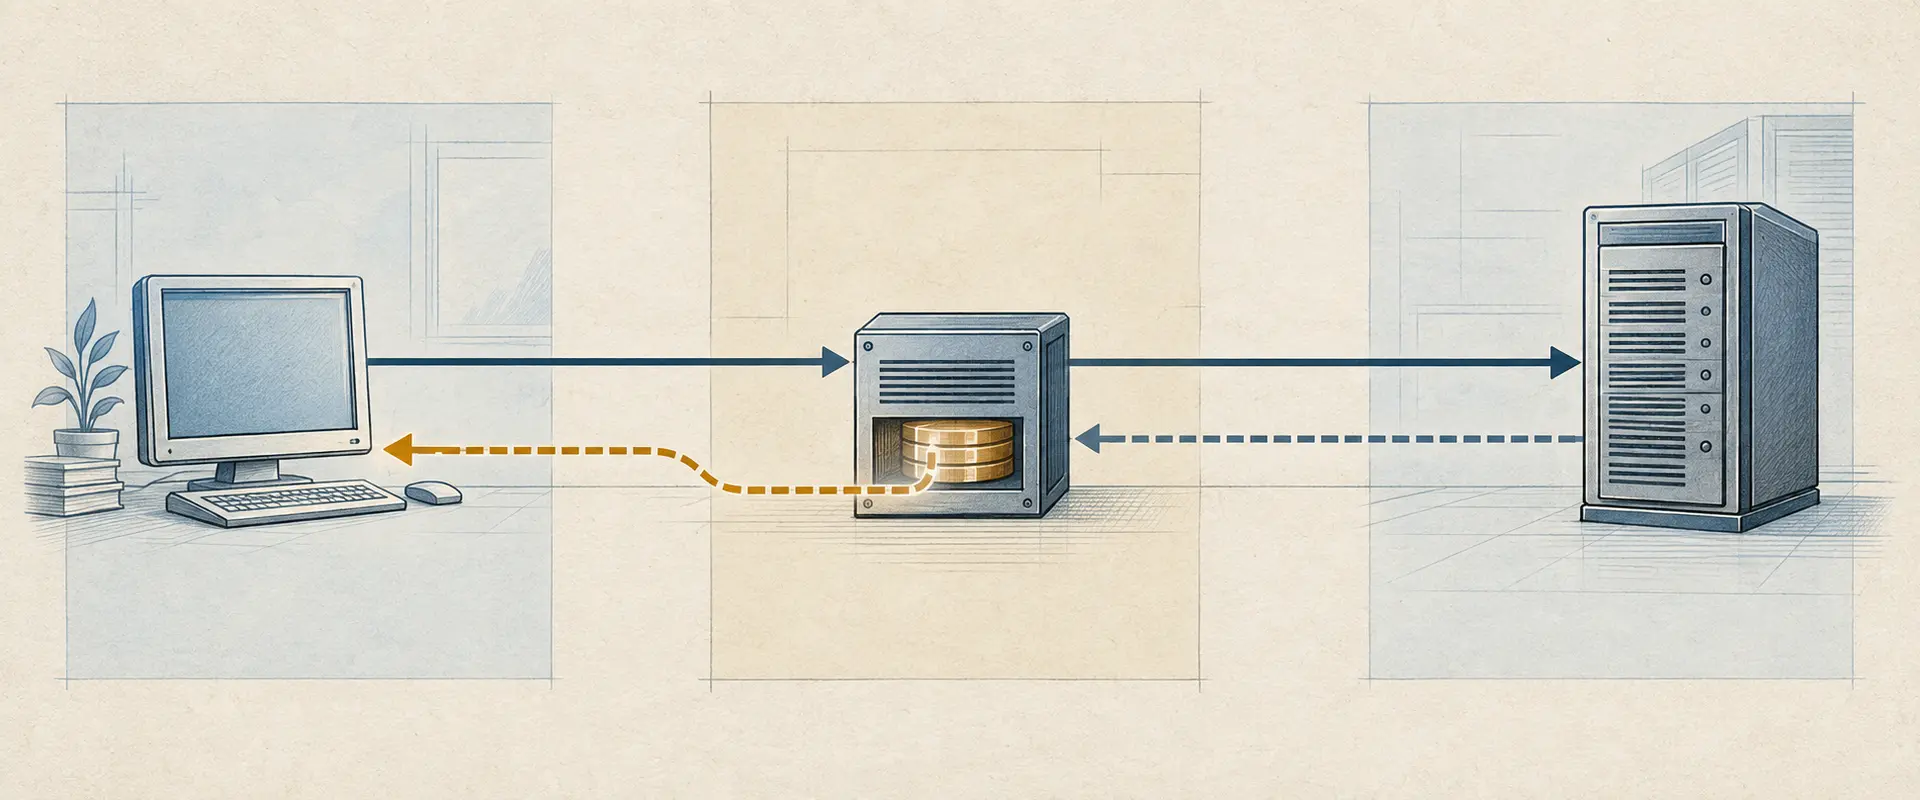
BCP 56 von Keith Moore machte eine weniger sichtbare Partei zum Teil des Entwurfs: das gesamte HTTP-Umfeld zwischen den beiden Anwendungsendpunkten. Eine Anfrage konnte eine Clientbibliothek, einen Proxy, einen Cache, eine Firewall, einen NAT, einen Webserver und schließlich Anwendungscode durchlaufen. Jede Komponente deutete bekannte Felder nach ihrer generischen Bedeutung. Weniger Aufwand in einem Baustein sorgte nicht dafür, dass alle anderen die spezielle Bedeutung der Anwendung verstanden.
Das Dokument verstand sich ausdrücklich als Rat und nicht als Konformitätsspezifikation; deshalb vermied es die großgeschriebenen normativen Schlüsselwörter aus RFC 2119. Es sagte also nicht, jede Anwendung müsse HTTP meiden. Vielmehr sollte die vollständige Kostenstruktur sichtbar werden. HTTP hatte bereits persistente Verbindungen, Bytebereiche, Inhaltsaushandlung und Caching angesammelt. Eine darüberliegende Anwendung konnte dadurch Funktionen erben, die sie nicht brauchte, und Arbeit darauf verwenden, sie einzuschränken.
Bei kleinen, häufigen Transaktionen konnten die TCP- und HTTP-Zusatzkosten ins Gewicht fallen; persistente Verbindungen konnten die Verbindungskosten dagegen über mehrere Austausche verteilen.
Ein vertrauter Statuscode konnte die falsche Geschichte erzählen
Schwierig wurde es, wenn HTTP-Erfolg und Anwendungsergebnis nicht dasselbe bedeuteten. Ein Proxy musste das neue Protokoll nicht verstehen, um den üblichen HTTP-Regeln zu folgen. Unter passenden Bedingungen konnte er eine erfolgreiche Antwort speichern und für eine ähnliche Anfrage erneut ausliefern. Ebenso konnte ein Vermittler den Text einer Fehlerantwort ersetzen oder ergänzen. Der Client erhielt dann eine formal gültige HTTP-Antwort, deren Anwendungsbedeutung veraltet, verdeckt oder verändert sein konnte.
RFC 3205 unterschied Fehler in HTTP-Anfragezeile und -Headern von Ergebnissen, die das Anwendungsprotokoll im Nachrichtenkörper ausdrückte. Wenn ein Protokoll für Ergebnisse des Körpers die allgemeinen Antworten 200 oder 500 verwendete, musste seine Spezifikation erklären, wie schädliches Caching verhindert wird und wie es mit veränderten Fehlerkörpern zurechtkommt. Konnte ein Protokoll das Caching oder die Veränderung solcher Antworten nicht vertragen, sollte es HTTP nicht als Unterbau wählen. Das Problem war nicht „HTTP-Statuscodes sind schlecht“, sondern dass zwei Schichten Erfolg und Fehler unterschiedlich definieren konnten.
Dieselbe Trennlinie galt für Methoden und Medientypen. Ein Inhaltstyp beschreibt, was für ein Objekt übertragen wird, legt aber nicht allein fest, welche Aktion der Empfänger ausführen soll. Die Aktion muss ausdrücklich benannt werden. Auch eine neue HTTP-Methode beantwortet noch nicht, ob ein eigenständiger Dienst einen eigenen Port oder ein eigenes URI-Schema braucht.
Wiederverwendung entschied auch über die Identität des Dienstes
Port 80 und http: hatten für Betreiber, Software und Nutzer bereits eine feste Bedeutung. RFC 3205 fragte, ob ein neuer Dienst getrennte Daten, eigenen Code, einen separaten Prozess oder besondere Anforderungen an die Verkehrskontrolle hatte; solche Unterschiede konnten einen eigenen Port rechtfertigen. Ein weit verbreiteter Dienst mit abweichender Einrichtung, Zugangsdaten oder Bereitstellung konnte auch ein eigenes URI-Schema benötigen. Das war keine Frage hübscher Benennung, sondern der betrieblichen Dienstidentität.
Auch Bibliotheken brachten Annahmen mit. Ein Client konnte eine Dienst-URL in eine HTTP-artige URL umwandeln, um eine HTTP-Bibliothek aufzurufen. Ein Proxy sah dann womöglich die vollständige absolute URL und behandelte sie wie eine gewöhnliche Webanfrage. Eine Bibliothek konnte HTTP/1.1 senden, obwohl die Anwendung noch festlegen musste, was diese Versionsangabe im eigenen Austausch bedeutete. Die Spezifikation – nicht die Hoffnung in wiederverwendeten Code – musste das Verhältnis zwischen Client, Server und Proxy beschreiben.
Wiederverwendung verlegte also einen Teil der Arbeit. Bestehender Code konnte die erste Implementierung beschleunigen, doch sein generisches Verhalten wurde damit Teil der Systemgrenze. Je mehr unabhängige Implementierungen es gab, desto eher konnte eine Abkürzung im Client mit einer Cache-Regel oder einer Serverannahme kollidieren. Das ist eine Deutung von RFC 3205s Entwurfsanalyse, keine Messung von Entwicklungskosten und kein Beleg dafür, dass ein bestimmtes Protokoll gescheitert wäre.
Der Nachfolger zeigt, dass das Thema bestehen blieb
2022 löste RFC 9205 RFC 3205 als BCP 56 ab. Nach zwei Jahrzehnten HTTP-Entwicklung behandelt sie HTTP-basierte APIs, die von getrennten Teams implementiert werden, die zeitversetzte Weiterentwicklung von Clients und Servern, Erweiterbarkeit, Caches, Zustand, Authentifizierung und das Nebeneinander mit Webbrowsern. Die Aktualisierung zeigt, dass das Thema eine neue Anleitung verdiente. Sie beweist weder allgemeine Übernahme noch, dass der Text von 2002 sämtliche spätere API-Praxis vorhergesehen hätte.
Die historische Lehre bleibt begrenzt und nützlich: Ein wiederverwendetes Protokoll beseitigt seine Grenzen nicht; es verlagert Arbeit in die Semantik gemeinsamer Software. Zwei Implementierungen können dieselbe HTTP-Bibliothek verwenden und trotzdem über die Bedeutung einer Antwort uneins sein. Interoperabilität verlangt präzise Angaben dazu, was die HTTP-Umgebung tun darf, was die Anwendung tun muss und welche Schicht für welches Ergebnis verantwortlich ist.
Die Architekturbegriffe für zwischengeschaltete Geräte stehen in RFC 3234. Der zeitgenössische HTTP/1.1-Kontext findet sich in RFC 2616; die Konvention für normative Schlüsselwörter, die RFC 3205 nicht nutzte, ist in RFC 2119 festgelegt. Die amtlichen Quellen sind RFC 3205, der RFC-Editor-Eintrag, der IETF-Datatracker-Eintrag, RFC 9205 und deren RFC-Editor-Eintrag.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten