摘要
- MITRE 2002 年进展报告记载,CVE 在 1999 年 9 月以 321 条记录公开推出,其定位是现有安全工具与数据库之间的逻辑桥梁。
- MITRE 作者 1999 年的原始设计论文估算,N 个漏洞数据库两两对接需要约 N² 种映射;借一个共同索引则每个数据库只需建立一次对应关系。严重度、局部配置和工具检测质量不属于这个索引。
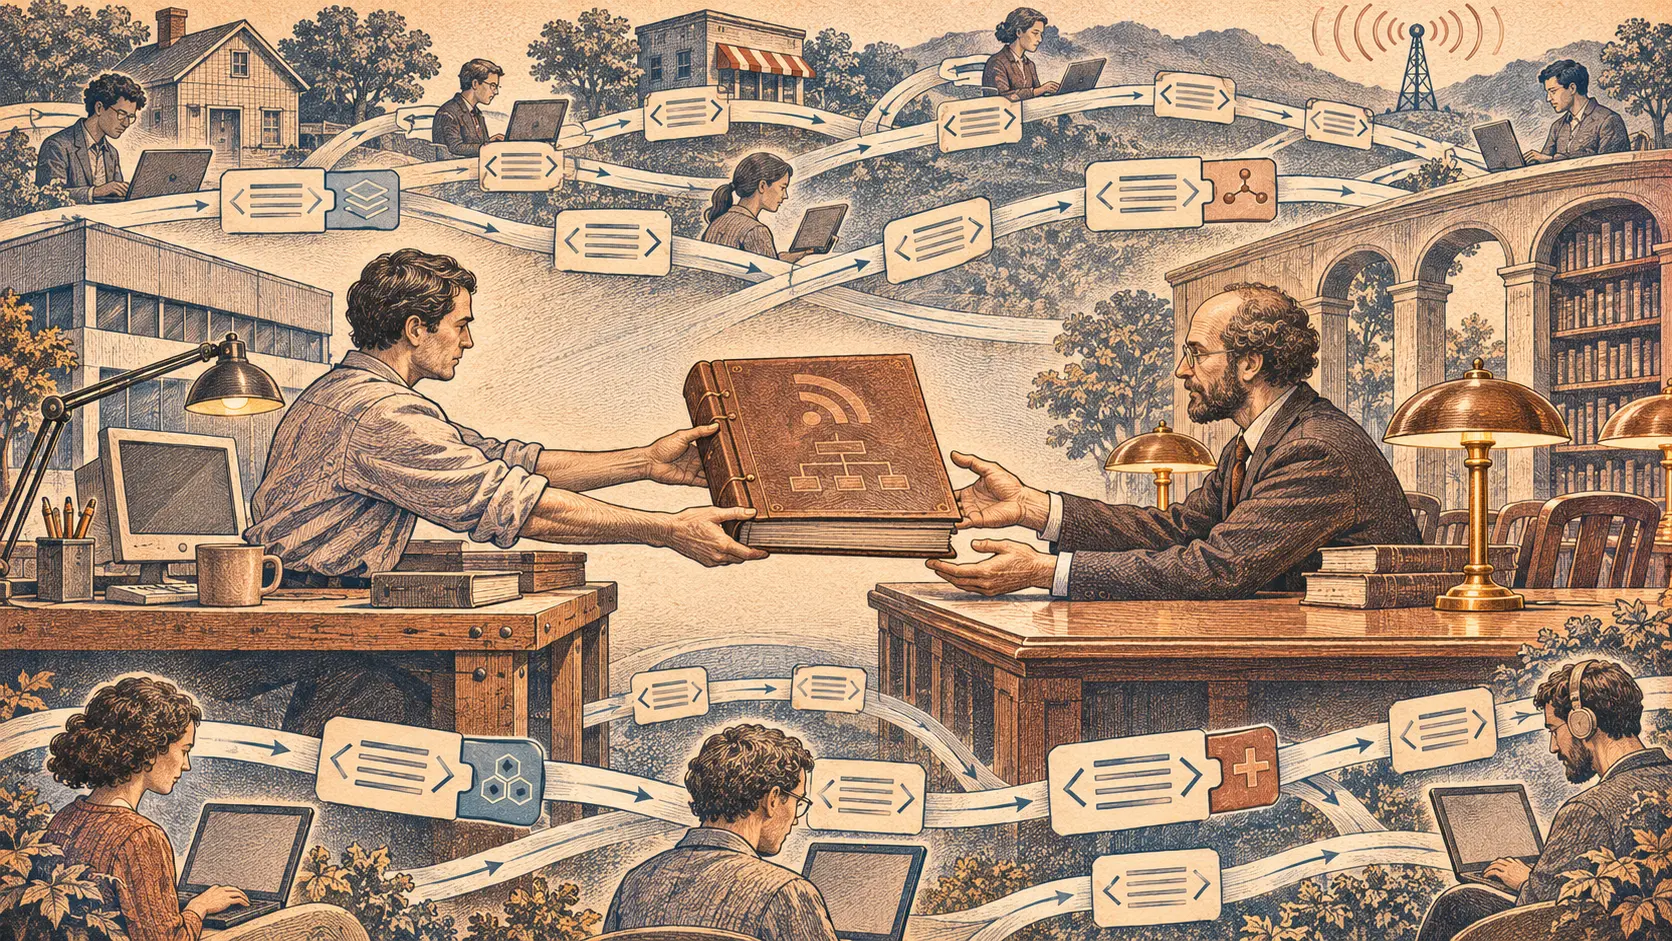
大家都有数据库,却叫不出同一个名字
一家扫描器报出一个缺陷,软件厂商的公告可能用另一个名称,第三家工具又有自己的分类。分析人员先得弄清这些描述是否指向同一问题,才谈得上评估风险。MITRE 1999 年论文把这种对表困难写得很直白:不同工具的资料难以比较,检测结果难以关联,公告也难以接到实际机器上的发现。增加记录数量不能解决名称不通的问题。
作者选择的办法很瘦:每个条目给一个唯一名称,再用足够短而明确的描述将它与别的问题区分开。每家数据库保留自己的内容与判断,只把记录映射到公共名称。若所有数据库彼此直接翻译,连接成本随来源数大约按 N² 增长;若都接到一个目录,则接入次数约为 N。这是协调成本的计算,不是漏洞总量的公式。
这套设计还主动避开“统一漏洞分类法”的宏愿。论文称 CVE 是索引、对照表,不是替所有产品决定类别、严重度或处置方式的总数据库。不同工具服务不同工作,保留自己的视角。公共层越薄,跨竞争产品传递一个明确名字就越容易。
编号没有写明危险有多大
CVE 的前缀、年份和序号看起来庄重,但原论文明确说:序号不表示漏洞被发现的先后,也不编码严重程度。机器是否安装了受影响版本、组件是否可达、检测工具是否正确,都无法从编号推出。作者还把局部配置、安全政策和实际风险列为公共命名解决不了的问题。
名字虽简单,准入并不自动化。1999 年的设计描述了草案、编辑委员会和候选编号 CAN。一个候选可以先有临时名字,再由委员会判断是否收入正式的 CVE 清单。成员可以认为提案与已有条目重复,也可以要求合并、拆分、改写或补充证据。真正难的是决定“这是不是同一个问题”。给这个问题达成共同边界,不等于替某台服务器验收补丁。
MITRE 的 2002 年回顾记录了 1999 年 9 月的首发清单与网站。它强调 CVE 是逻辑桥梁,不是要取代已有安全产品。预期的链条是:工具、公告和厂商更新页面引用同一编号,用户才能把发现与修复说明接在一起。至于哪一版软件在运行、更新是否适用、安装后服务是否正常,仍需操作者自己证明。
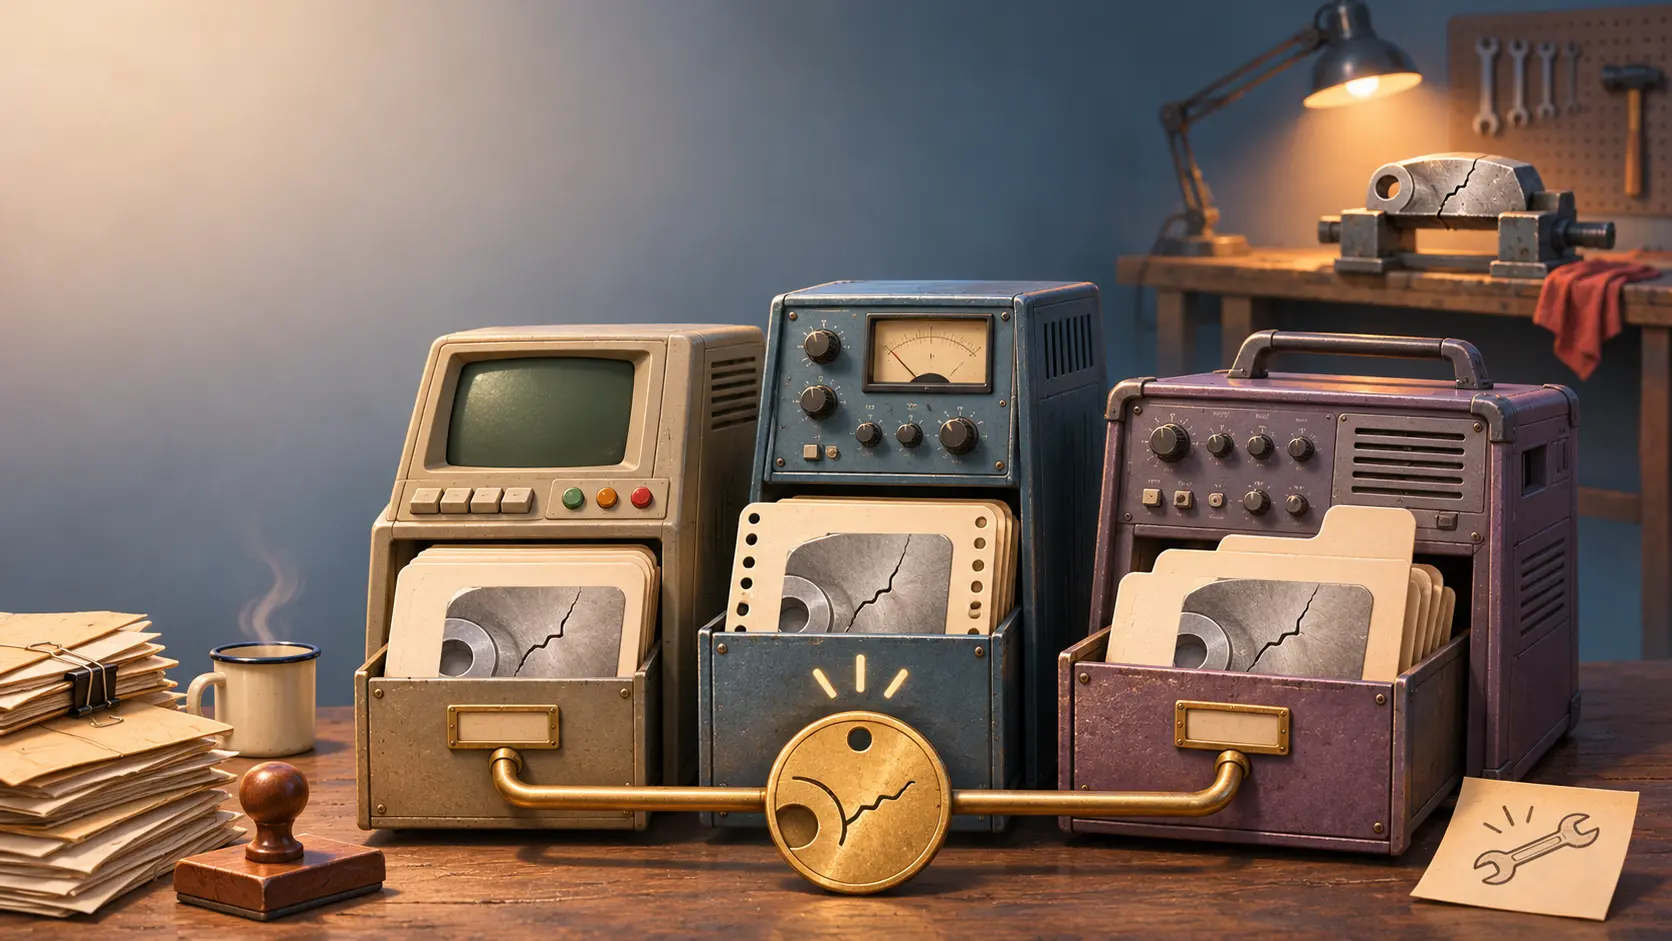
首发 321 条是公共清单的规模,不是全球漏洞普查,更不是修补完成的数量。CVE 给三张不同的诊断单找到同一处裂缝。拧紧螺丝的工具还要另找。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限战略圈层会员
战略圈层
所有读者均可浏览。加入并登录后可解锁档案简报。
加入战略圈层仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance