摘要
- 2005 年 10 月的 RFC 4180记录了常见 CSV 格式,并登记
text/csv媒体类型。它是一份信息性 RFC,承认各程序实现不同,并让媒体类型用可选参数说明首行是不是表头。 - 2014 年 1 月的 RFC 7111为 CSV 定义
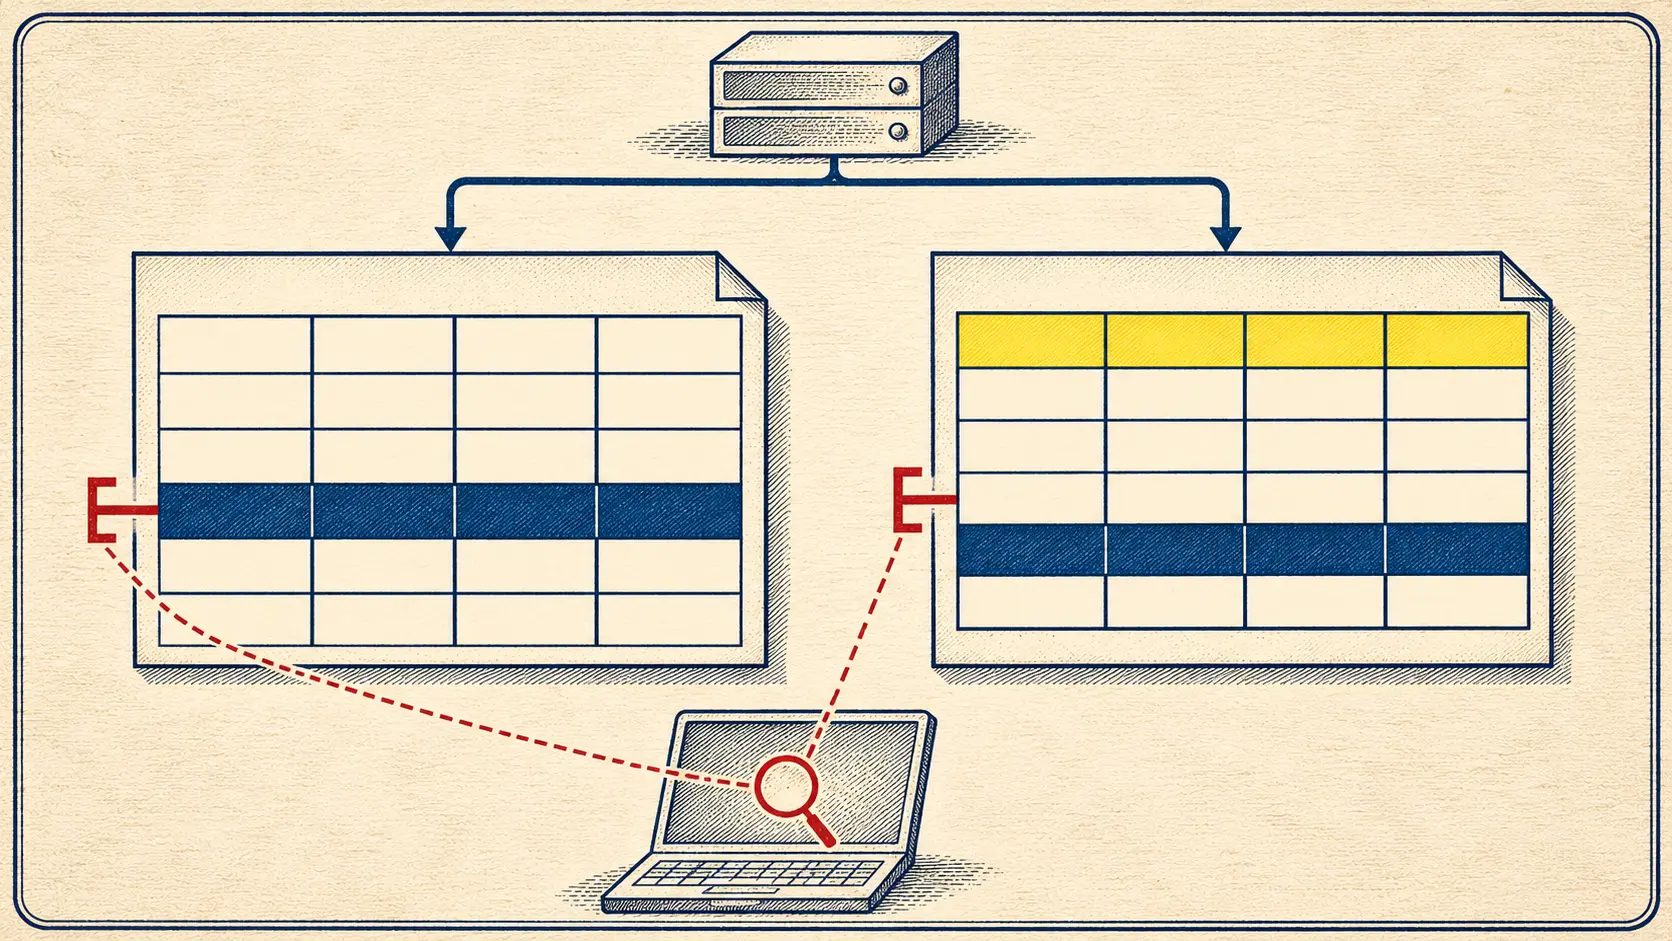
#row=4、#col=2、#cell=4,1等片段标识,分别按行、列、单元格位置选择内容。行列从一开始计数。不支持这套语法的客户端仍可取得完整文件。 - 位置不是记录身份。在第四行前插入一行后,同一个
#row=4会选中新的第四行。服务器无法可靠判断一次文件请求是否带有片段,因此也不能替读者核实旧链接原本指向的事实。
给数据表中的一句话写地址
假设一个机构把决策清单发布成 CSV。研究者要引用其中第四行的决定。只给整份文件的链接,读者还得下载、打开、寻找。给网址加上 #row=4,看起来就像替那条决定配了一个门牌:点击后直接看被引用的一行。
这种写法来自 2014 年 1 月发布的 RFC 7111。文件为 text/csv 资源定义 URI 片段:row 选行,col 选列,cell 选两者交点。标准举的 data.csv#row=4 例子指向文件的第四行。样例第一行是列名,因此第四行其实是第三条数据。只按数据记录计数的人,起步就会偏一格。
再往前看,CSV 本身并不是从一份严整规格中出生的。2005 年 10 月的 RFC 4180为它登记 text/csv,并记录当时常见的逗号、引号、换行和表头用法。文件开篇承认:CSV 在电子表格之间流通已久,却一直没有一份统一的正式描述。RFC 的身份是信息性文件,且明说各实现之间有差异。它给已有习惯立了可供参照的说明,没有把全世界的 CSV 一夜改造成同一种文件。
表头问题看似琐碎,实际决定脚注落在哪里。text/csv 可以用 header=present 或 header=absent 表示首行是否为列名;不写参数时,读取程序自行判断。而 RFC 7111 按文件里的行从一开始数。口头说“第四条数据”,如果上面有表头,实际就是文件的第五行。一个看起来极其精确的片段,离不开出版者对文件结构的交代。
行号认识座位,不认识坐在上面的人
2014 年的语法并不只有单行选取。#col=2 指向第二列,#cell=4,1 指向第四行第一列。横线可以圈出范围,星号代表最后一行或最后一列,分号还能选择互不相邻的多段内容。读者因此能在别人公开的 CSV 中点出一片区域,出版者无需给每一格另建网页。
但这些片段写下的都是坐标。#row=4 不带记录编号,不带原始值的哈希,不带文件版本的日期。客户端拿到当下的文件后数到第四行,便完成任务。它并不知道写下链接的人数月前在第四行看到什么。
设想第四行原本是一项批准决定。发布者发现漏了一条较早的记录,便在表格上方补入一行。原来被引用的批准决定挪到第五行;旧的 #row=4 仍符合语法,第四行也确实存在。一个支持片段的客户端会很认真地选中它——只是那里现在写着另一件事。检查网址是否能打开,会得到“正常”;检查证据是否仍支持文章,答案可能已经变了。
删掉前面的行会产生反方向的位移。重新排序能一次移动多条记录。在某列前插入新列,也会改变 #cell= 中列号对应的字段。风险直接来自 RFC 7111 的位置计数规则,不需要假设客户端程序出错。软件严格按规格执行,反而可能把读者稳稳送到错误的事实前。
要证明某个现实案例真的发生了漂移,仍需拿出带日期的旧文件和新文件,找出同一条记录在两版中的位置。现有原始标准说明的是机制,并未列出这样一宗具体事故。这个证据缺口指向明确的核查办法:保存当初所引的文件版本,再看现在同一网址交付了什么。
服务器不知道你指着哪一行
片段的权力边界早在 2005 年 1 月的 RFC 3986 中已有说明。URI 中 # 后面的内容是一种由客户端处理的间接引用。获取主要资源前,片段会与其余网址分开;它的意义取决于最终收到的媒体类型,再由用户的软件解释。RFC 7111 只是把这套方式用到 text/csv 文件上。
所以服务器收到的并非“请给我第四行”。它交付整份 CSV,随后客户端才选行。RFC 7111 直说:服务器没有可靠办法知道请求者使用了哪个 CSV 片段。两个人用同一个可见链接打开文件,一个客户端懂 #row=4,就突出第四行;另一个不懂,仍能取得文件,却只显示或下载整张表。
这给引用者留了自由。文件发布者不必同意为每一行增设接口,其他人也能指向文件内部的一段。服务器的访问日志却只能证实文件被取走,无法证实第四行曾被展示、阅读或核对。片段留在读者端,精确引用的最后一步也留在读者端。
RFC 7111 为错误位置规定了处理方法:语法错了就忽略,不能替作者猜;单独选中的行超过文件末尾就忽略;范围越过末尾则缩到实际大小。这些规则能处理不存在的行,却无法判断一个存在的第四行是否仍是原作者想引的那条。链接保持有效,恰恰是这类失真的难处。
文件的安全讨论还提醒,不同客户端对片段和整份 CSV 的展示不一致,可能让人产生误解。一个软件把被引用的行亮出来,另一个软件铺开全表。2014 年的文件描述了支持者应怎样解释片段,没有列出各浏览器在什么版本开始实现。若要补上部署史,需要有日期的实现记录。
链接没坏,证据可能已经搬家
CSV 适合在网上流通,一个原因是发布成本低:导出一个文件就能供别人读取。RFC 4180 给它一个通用媒体类型;RFC 7111 让别人能在文件内部选中一处。两者合起来减少了出版者和引用者的工作,也把长期可核查性留成了下一道题。
临时指路时,“当前第四行”也许足够。一篇需要多年后仍能复核的研究文章,则要知道旧文件长什么样,或者用一个独立、稳定的记录编号指向原始事实。保存带日期的版本、公布记录键、给重要记录稳定地址,都比复制 #row=4 麻烦。麻烦换来的是表格排序改变之后,证据仍有身份。
RFC 7111 是独立提交的信息性 RFC;更新 text/csv 登记所需的 IESG 批准已取得。它把“选中一个位置”写得清楚,但没有替数据出版者冻结那个位置上的内容。行号像门牌;门牌没换,并不能保证住户没搬。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限战略圈层会员
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance