要約
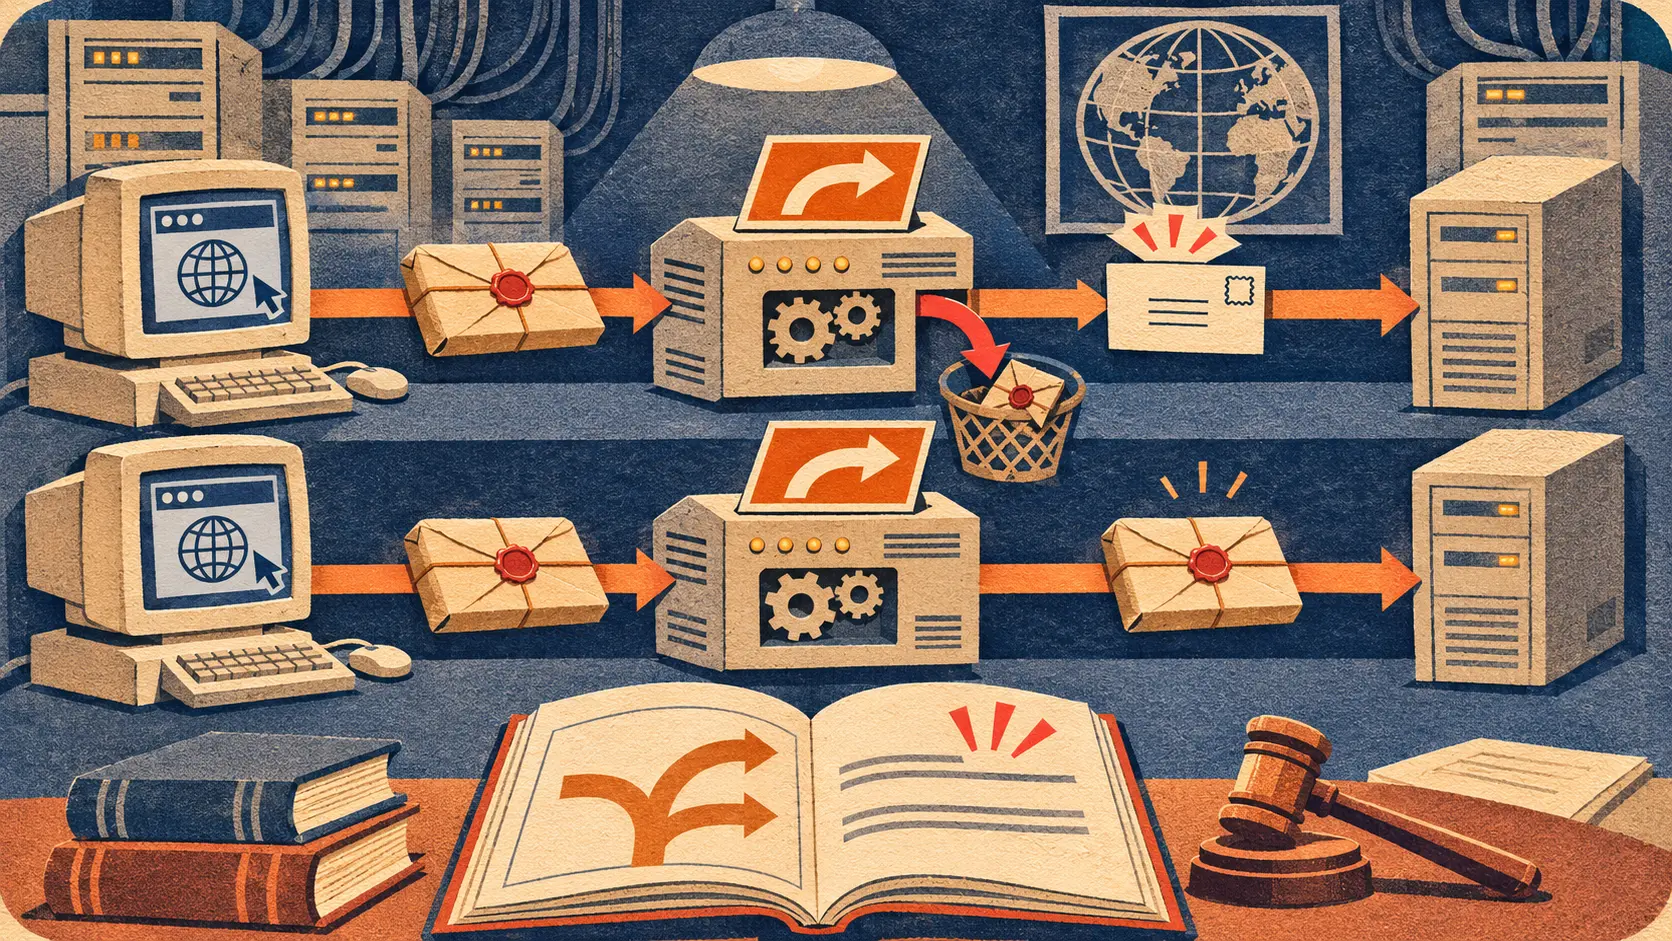
- 2005年10月のRFC 4180は、広く使われていたCSVの一般的な形式を記述し、
text/csvを登録した。情報提供のためのRFCであり、実装差を認め、先頭行が見出しかどうかは任意のメディアタイプ・パラメーターで示せるようにした。 - 2014年1月のRFC 7111は
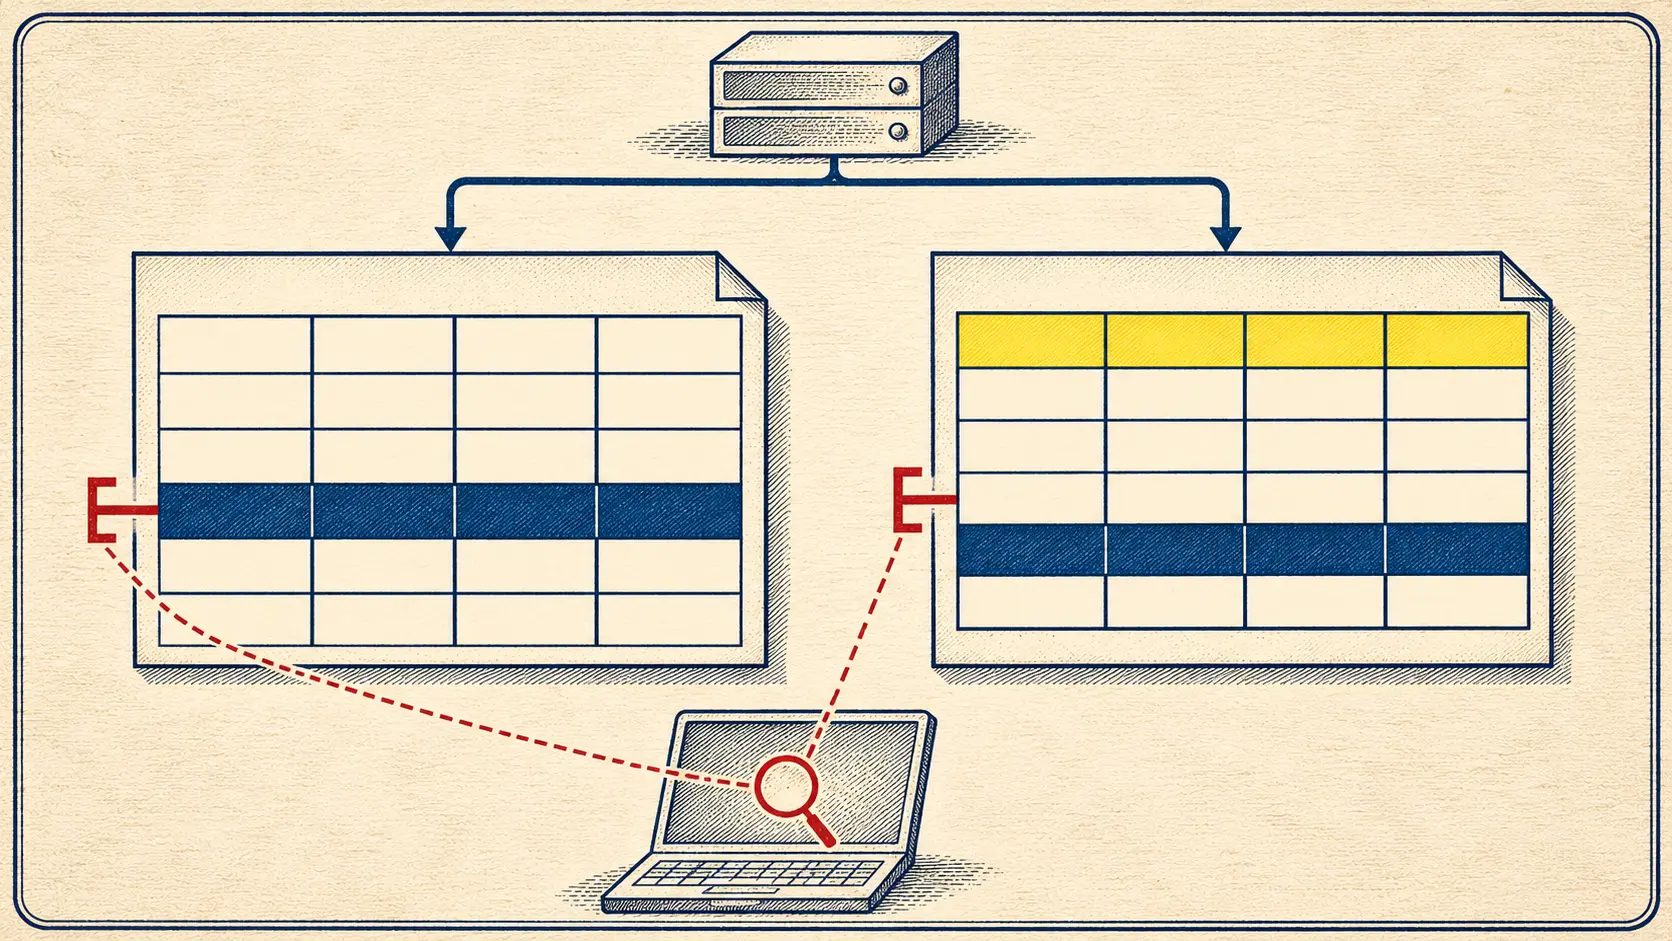
text/csvに対し、#row=4、#col=2、#cell=4,1で行・列・セルを位置から選ぶフラグメントを定義した。行と列は一から数える。対応しないクライアントもファイル全体は取得する。 - 位置の指定は記録の識別ではない。四行目の前に一行追加すると、同じ
#row=4が新しい四行目を選ぶ。サーバーにはリクエストにフラグメントが付いていたかを確実に知る方法がない。
データの一行に住所を付ける
公開されたCSVの中に、ある決定を記した行がある。記事の筆者はその一行を示したい。ファイルのURLだけを脚注に入れると、読者は表を開いて数えなくてはならない。末尾に#row=4が付いたリンクなら、四行目まで案内してくれそうだ。扱いやすく、いかにも厳密な参照に見える。
その仕組みを定めたのが2014年1月のRFC 7111である。CSVのURIに付くフラグメントとして、行を選ぶrow、列を選ぶcol、交点を選ぶcellを用意した。同文書の例にあるdata.csv#row=4は、ファイルの四行目を指す。例の一行目は列名なので、四行目はデータとしては三件目だ。「四件目」と考えてリンクを作るだけで、指示は一行ずれる。
CSVをウェブ上で扱う土台は、それ以前に整えられていた。2005年10月のRFC 4180はtext/csvというメディアタイプを登録し、コンマ、引用符、改行、見出し行について一般的な形式を説明した。冒頭には、表計算ソフトの間で長く使われているにもかかわらず共通の正式な説明がなかった、とある。既に走っているファイル交換を文書にしたのであって、違う実装を一斉に作り直したわけではない。
見出し行の有無はheader=presentまたはheader=absentという任意のパラメーターで伝えられる。指定されなければ、読む側のソフトウェアが判断する。RFC 7111が数えるのはファイルに現れた行そのものだ。記事に書く「四番目のデータ」とリンクの「四行目」を同じものとして扱う前に、ファイルの先頭に何が置かれているか確認する必要がある。
行番号は席を覚えても、座る記録は覚えない
2014年の仕様は、一行の指定だけにとどまらない。#col=2なら二列目、#cell=4,1なら四行目の一列目。ハイフンで範囲を示し、アスタリスクで最終行や最終列を指定できる。セミコロンを使えば離れた部分を複数選べる。データを公開する側が一セルごとにページを作らなくても、読む側がファイルの一部分を指せる。
ただし、その座標には記録の名前が入っていない。#row=4には、元の行の識別子も、期待した値のハッシュも、引用時点の版も含まれない。対応するクライアントは今届いたファイルを一行目から数え、四行目を選ぶ。数か月前にリンクを書いた人がそこに何を見たかまでは分からない。
たとえば、四行目が承認の決定だったとする。公開者が時系列を整えるため、その上に抜けていた一件を挿入する。承認の記録は五行目へ移る。旧リンクは依然として正しい形をしているし、四行目も存在する。クライアントがそこを鮮やかに強調すればするほど、読者には「参照できた」と見える。だが記事が根拠にした決定は、その下にいる。
上の行を削れば逆方向に動き、並べ替えれば多数の記録が一度に移る。列を挿入すればセルへのリンクも別の項目を指し得る。これはソフトウェアの誤動作を仮定した話ではない。番号で選ぶという仕様を忠実に実行した結果だ。リンクが壊れずに中身だけを取り違える点に、この仕組みの怖さがある。
実際の引用で取り違えが起きたと断定するには、日付のある旧版と新版を並べ、同じ記録の位置を確かめる必要がある。ここで使う原文書は仕組みを示している。特定の事件や利用率を報告してはいない。検証に要るものは明確だ。筆者が見た版のファイルを残し、現在配信されるファイルと比較する。
サーバーは表を渡す。指すのは読者だ
この役割分担はCSV固有の奇策ではない。2005年1月のRFC 3986によると、URIの#以降はクライアント側で解釈する間接参照だ。主な資源を取得する前にフラグメントは切り離され、取得したメディアタイプに応じて利用者のプログラムが意味を決める。RFC 7111はこの原則をtext/csvに適用した。
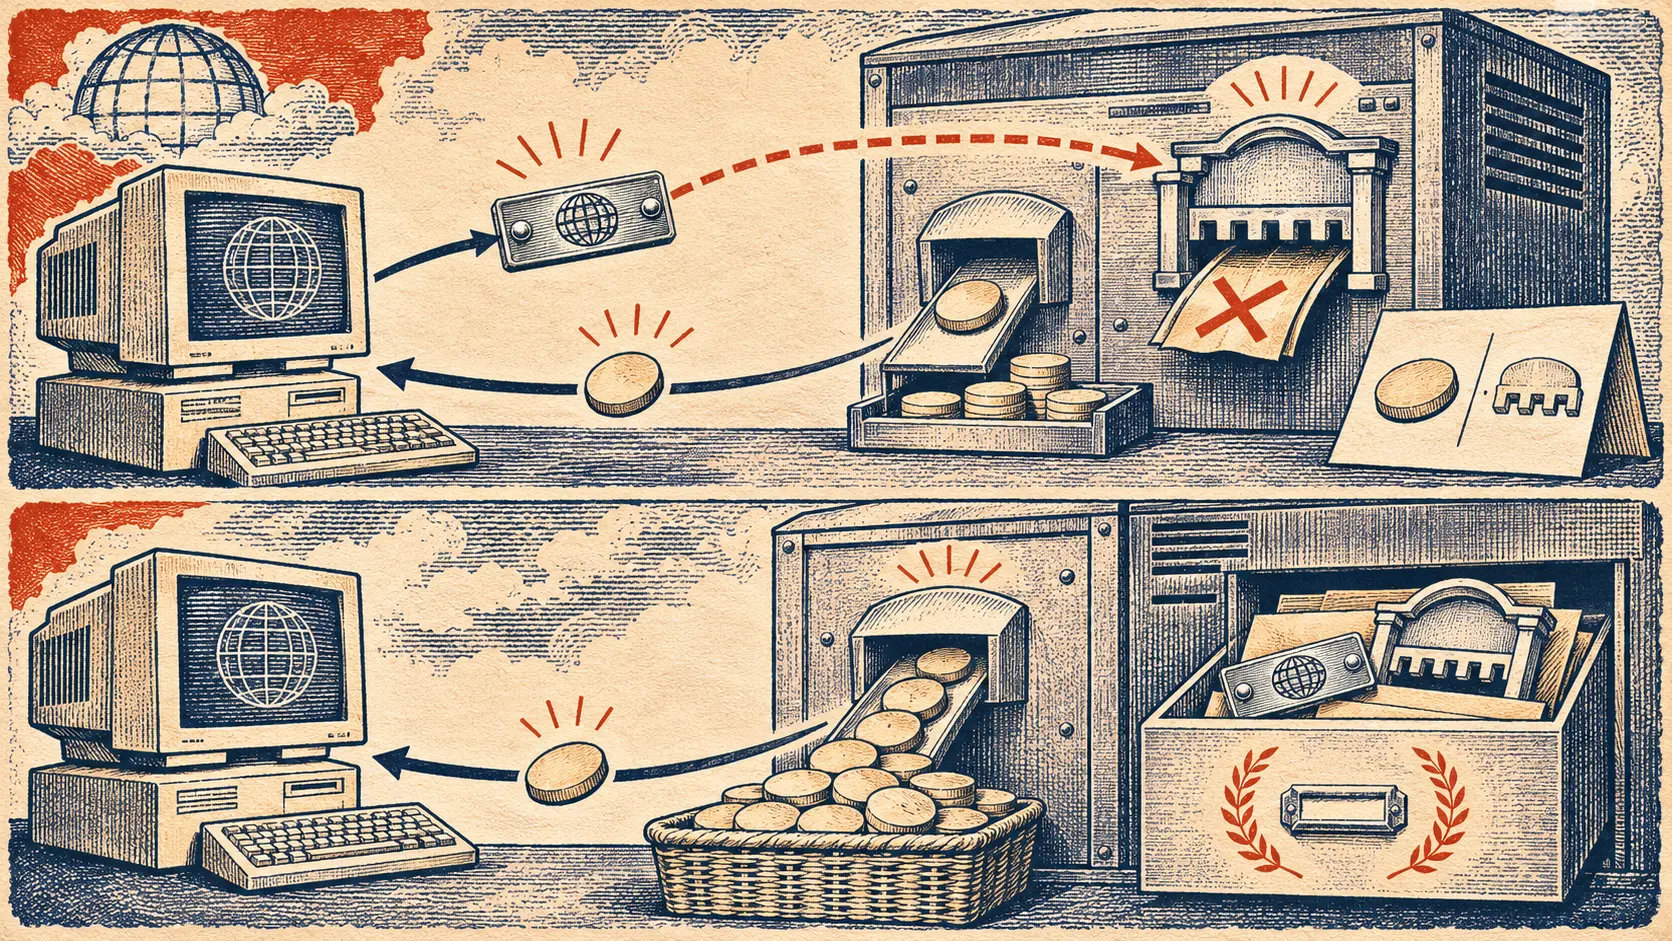
サーバーへの要求は「四行目を送れ」ではない。サーバーはCSVを丸ごと渡し、受け取ったクライアントが行を選ぶ。RFC 7111は、要求したクライアントがフラグメントを使っていたかどうかをサーバーが確実に判断する方法はないと明記する。アクセス記録に残るのはファイルの取得であり、読者がどの行に注目したかではない。
対応状況によって見え方も変わる。フラグメントを理解するソフトは選ばれた行を示せる。理解しないソフトも同じCSVを取得できるが、ファイル全体への参照として扱う。仕様はこれを段階的な普及の問題として説明する。同じリンクでも、利用者の画面に現れる対象は一行とは限らない。
この仕組みには大事な自由がある。ファイルを所有しない筆者でも、その一部に読者を向けられる。公開者に専用APIを作ってもらう必要はない。一方、サーバーがファイルを正常に返した記録は、その行が表示された証拠にはならない。引用の最後の一歩は読者側のプログラムに委ねられている。
構文の誤りや範囲外の指定についてはRFC 7111に処理規則がある。壊れた構文は推測で直さず無視する。存在しない単独の行は無視し、末尾を越える範囲は実際の長さまで縮める。これらは不可能な座標に対する規則だ。四行目が存在し、ただし昔とは違う事実を載せている場合には働かない。
同文書の安全面の記述も、選択部分だけを見せるソフトとファイル全体を見せるソフトの差が誤解を招き得ると指摘する。仕様は対応クライアントの動作を記すが、いつどのブラウザー版が機能を採用したかは列挙していない。その時系列には日付付きの実装資料が要る。
URLだけが長生きする
CSVが広まった理由の一つは、安く作って渡せることだ。RFC 4180はそのファイルにインターネット上で通用するメディアタイプを与えた。RFC 7111は、中の一部分を引用できるようにした。公開者にとっても書き手にとっても、作業の少ない組み合わせである。だが、住所が続くことと、同じ証拠がそこに居続けることは別々に管理しなければならない。
一時的な案内なら「今の四行目」で十分だろう。後年の検証に耐える主張なら、参照した版を保存するか、行とは独立した記録IDを公表する方がよい。特定の記録に安定したURLを用意する方法もある。どれも#row=4を貼るより手間がかかる。その手間によって、表が並べ替えられた後も何を根拠にしたかが残る。
RFC 7111は独立投稿の情報提供RFCで、text/csvの登録変更には必要なIESGの承認を得ている。規則が与えたのは位置を選ぶ方法だ。そこに置かれる情報を固定する権限は、依然としてファイルの公開者にある。行番号は住所になったが、記録の身分証にはならなかった。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
ストラテジックサークル限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加