Summary
- RFC 1691은 디지털 책을 낱장 파일, 그 순서를 복원하는 구조, 저자·제목·문서 번호로 찾는 데이터베이스 기록으로 설명했다.
- 접근 권한은 주로 자료 묶음 단위로 정하되 파일 하나까지 검사할 수 있게 설계했다. 이용자는 문서나 구성 요소를 열려고 할 때 결과를 통지받도록 했다.
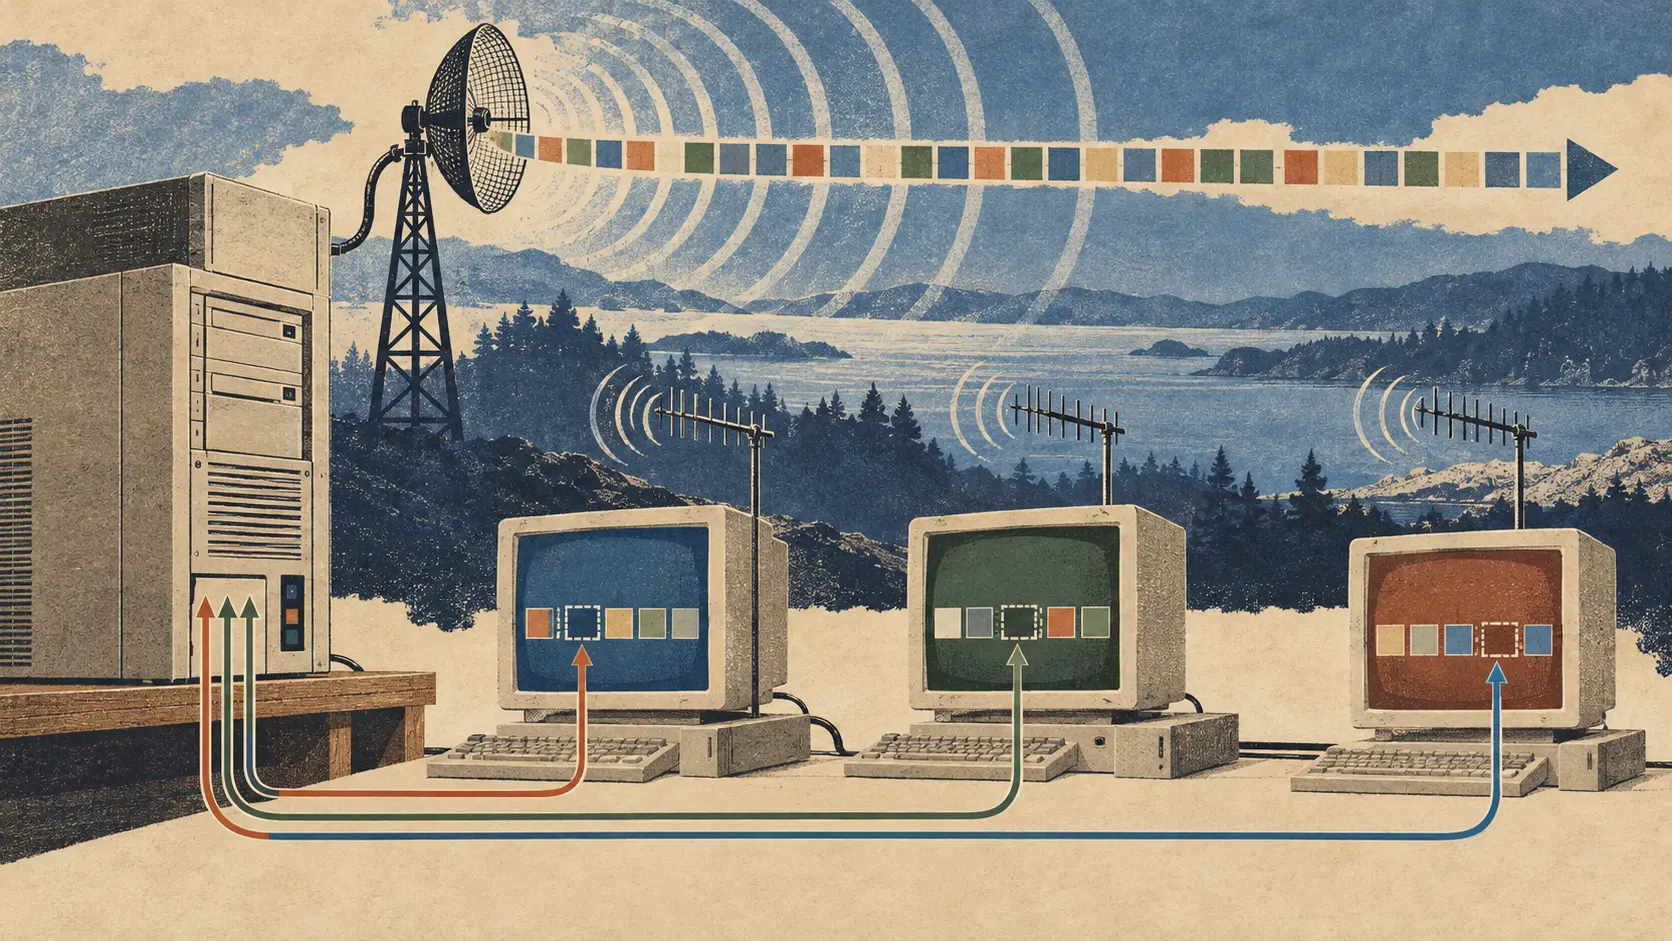
책을 스캔하는 순간 종이 제본이 해체된다. 컴퓨터는 이미지 백 장을 저장할 수 있지만 그 이미지가 어느 장의 어느 순서인지 저절로 알지 못한다. Cornell University와 Xerox Corporation은 1989년부터 자료 보존을 위한 디지털 시제품을 만들었다. Xerox는 CLASS 저장·제작 시스템을, Cornell은 네트워크 열람과 인쇄 요청 기능을 맡았다. William Turner의 1994년 RFC 1691은 흩어진 이미지를 다시 '책'으로 만드는 방법을 기록했다.
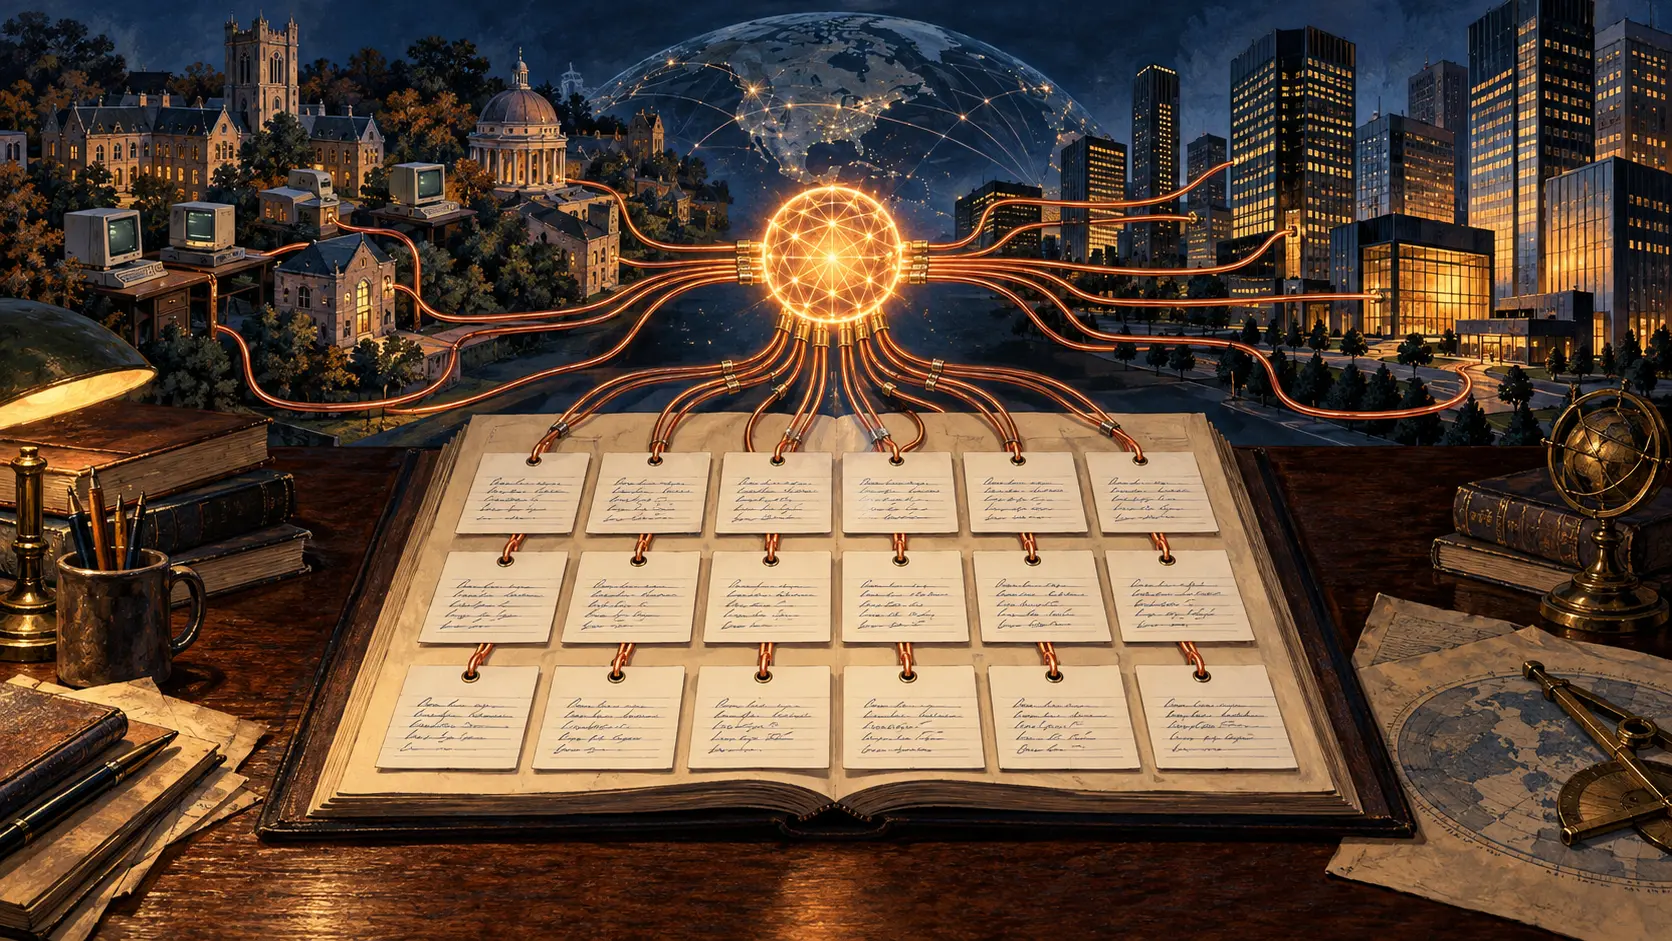
설계에는 세 층이 있었다. 논리 구조는 페이지 순서와 목차 같은 읽기 경로를 기억한다. 물리 참조는 그 경로의 각 지점을 실제 파일에 연결한다. 데이터 파일에는 이미지나 ASCII 텍스트가 들어간다. 별도의 관계형 SQL 데이터베이스는 저자, 제목, 문서 ID로 소장 자료를 검색했다. 검색은 책의 존재를 알려주지만 페이지 파일을 전달하는 일까지 끝내지는 않았다.
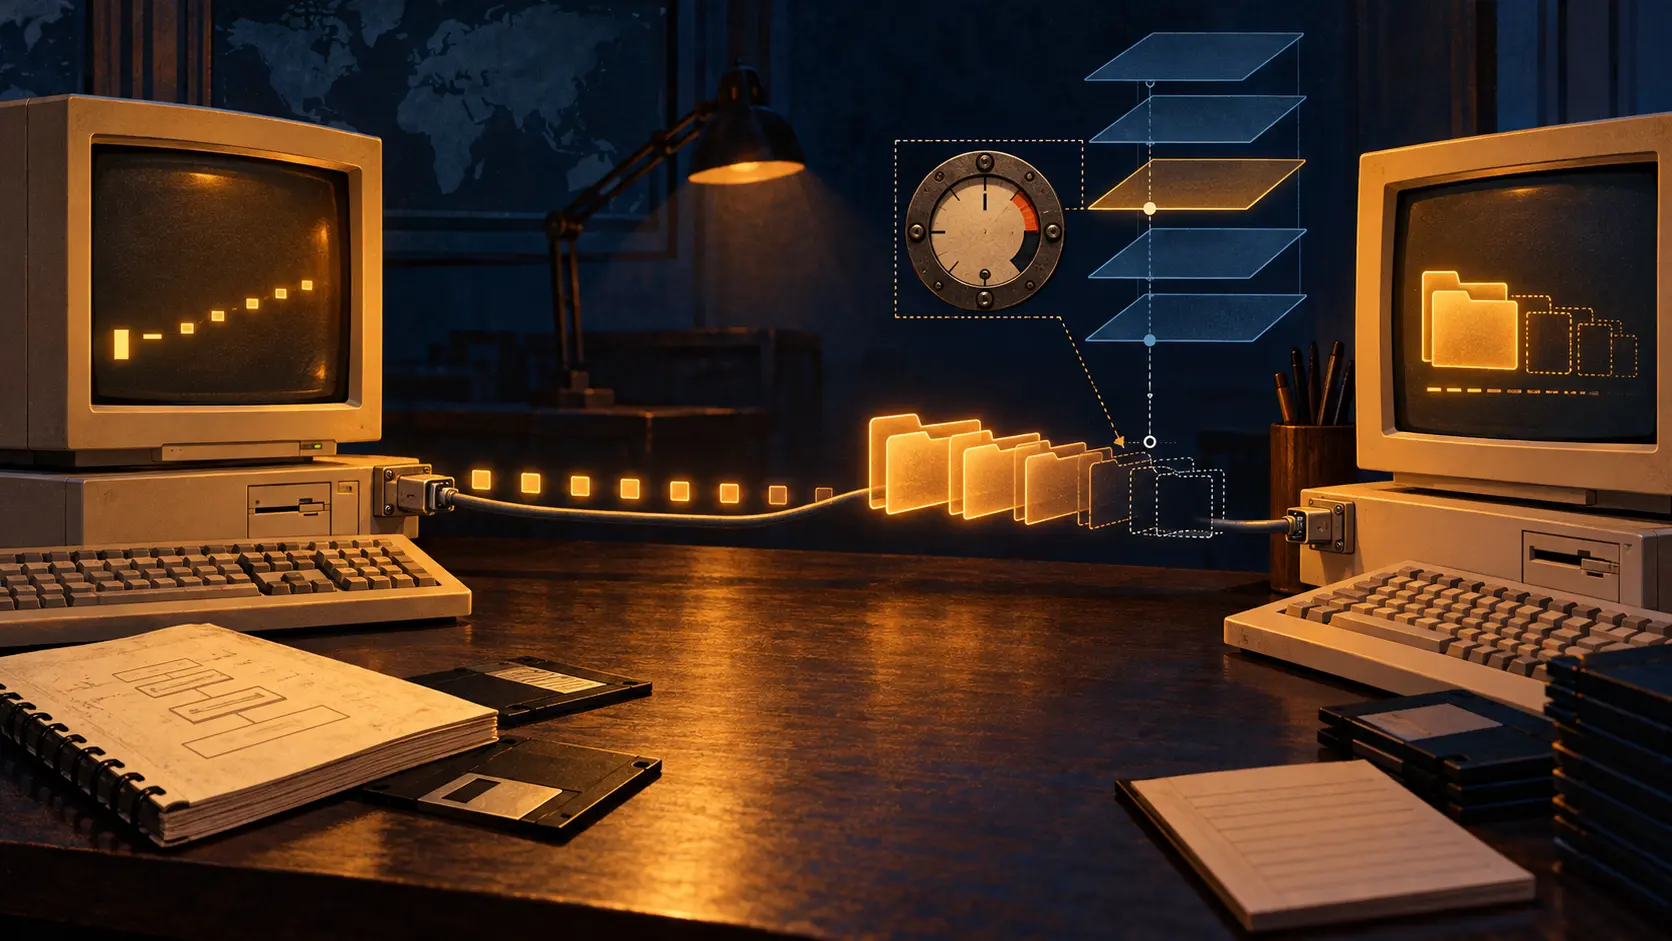
파일 이름도 독서 순서를 좌우했다. 1.TIF, 2.TIF, 10.TIF를 문자열로 정렬하면 열 번째 페이지가 두 번째보다 먼저 온다. RFC가 0001.TIF처럼 앞에 0을 채우라고 한 이유는 FTP나 Gopher로 목록을 보더라도 페이지가 뒤섞이지 않게 하려는 것이었다. 작은 미리보기와 인쇄용 고해상도 이미지도 같은 페이지의 서로 다른 표현으로 연결했다.
저장 장치의 배치는 고정하지 않았다. 도서관, 자료 묶음, 문서, 파일 형식, 파일 참조 번호를 합친 식별값을 프로그램이 UNIX 경로로 바꿨다. 한 예에서는 파일 형식을 디렉터리의 윗단에 놓아 작은 이미지를 빠른 디스크에, 정밀한 이미지를 느리고 저렴한 저장 장치에 둘 수 있었다. 그 구조라면 FTP나 Gopher에서 작은 이미지를 보여주면서 큰 파일은 제한하는 선택도 가능했다.
마지막 선택은 권한이었다. 설계는 주로 자료 묶음 단위로 접근을 판단하되, 필요하면 파일 하나까지 내려가도록 했다. 이용자에게는 문서나 페이지를 열 때 알렸다. 따라서 올바른 검색 결과가 잠긴 페이지로 이어질 수 있었다. RFC Editor의 공식 기록은 이 문서를 Informational로 분류한다. 문서의 보안 절은 권한 통제의 실제 성능을 평가하지 않았다. 설계가 증명하는 것은 문이 어디에 놓였는지다.
목록을 풍부하게 만드는 일과 독자에게 책장을 건네는 일은 다르다. 코넬은 그 차이를 1994년 설계에 새겨 두었다. 도서관의 실질적인 약속은 검색 결과가 아니라 요청한 페이지가 열리는 순간에 검증된다.
Sources
회원 브리핑
프로필 심층 컨텍스트
올바른 멤버십 등급으로 로그인하면 전체 브리핑과 출처 노트를 볼 수 있습니다.
Strategic Circle 전용
Strategic Circle
모든 독자에게 공개됩니다. 가입 후 로그인하면 프로필 브리핑를 열람할 수 있습니다.
Strategic Circle 가입하기Leadership Alliance 전용
Leadership Alliance
자격을 갖춘 IP 자산 소유자 및 운영진을 위한 콘텐츠입니다. 로그인하면 Leadership Alliance 브리핑을 열람할 수 있습니다.
Leadership Alliance 가입하기