Résumé
- RFC 2068, publié en janvier 1997, définissait un champ d'en-tête
Linkpour décrire une relation entre ressources, généralement celle demandée et une autre. Plusieurs liens pouvaient accompagner une même entité, avec un type de relation comparable à celui de l'élémentLINKen HTML. - RFC 5988, publié en octobre 2010, explique que RFC 2616, paru en juin 1999, avait retiré ce champ faute d'expérience de mise en œuvre. L'absence a laissé son statut incertain, alors que certains agents utilisateurs l'ont ensuite utilisé et que d'autres besoins sont apparus.
- RFC 5988 a redéfini le champ autour d'un lien typé indépendant du format du document. RFC 8288, publié en octobre 2017, lui a succédé en conservant
Linkcomme façon de transporter une relation dans les en-têtes HTTP.
Le lien voyage dans la réponse
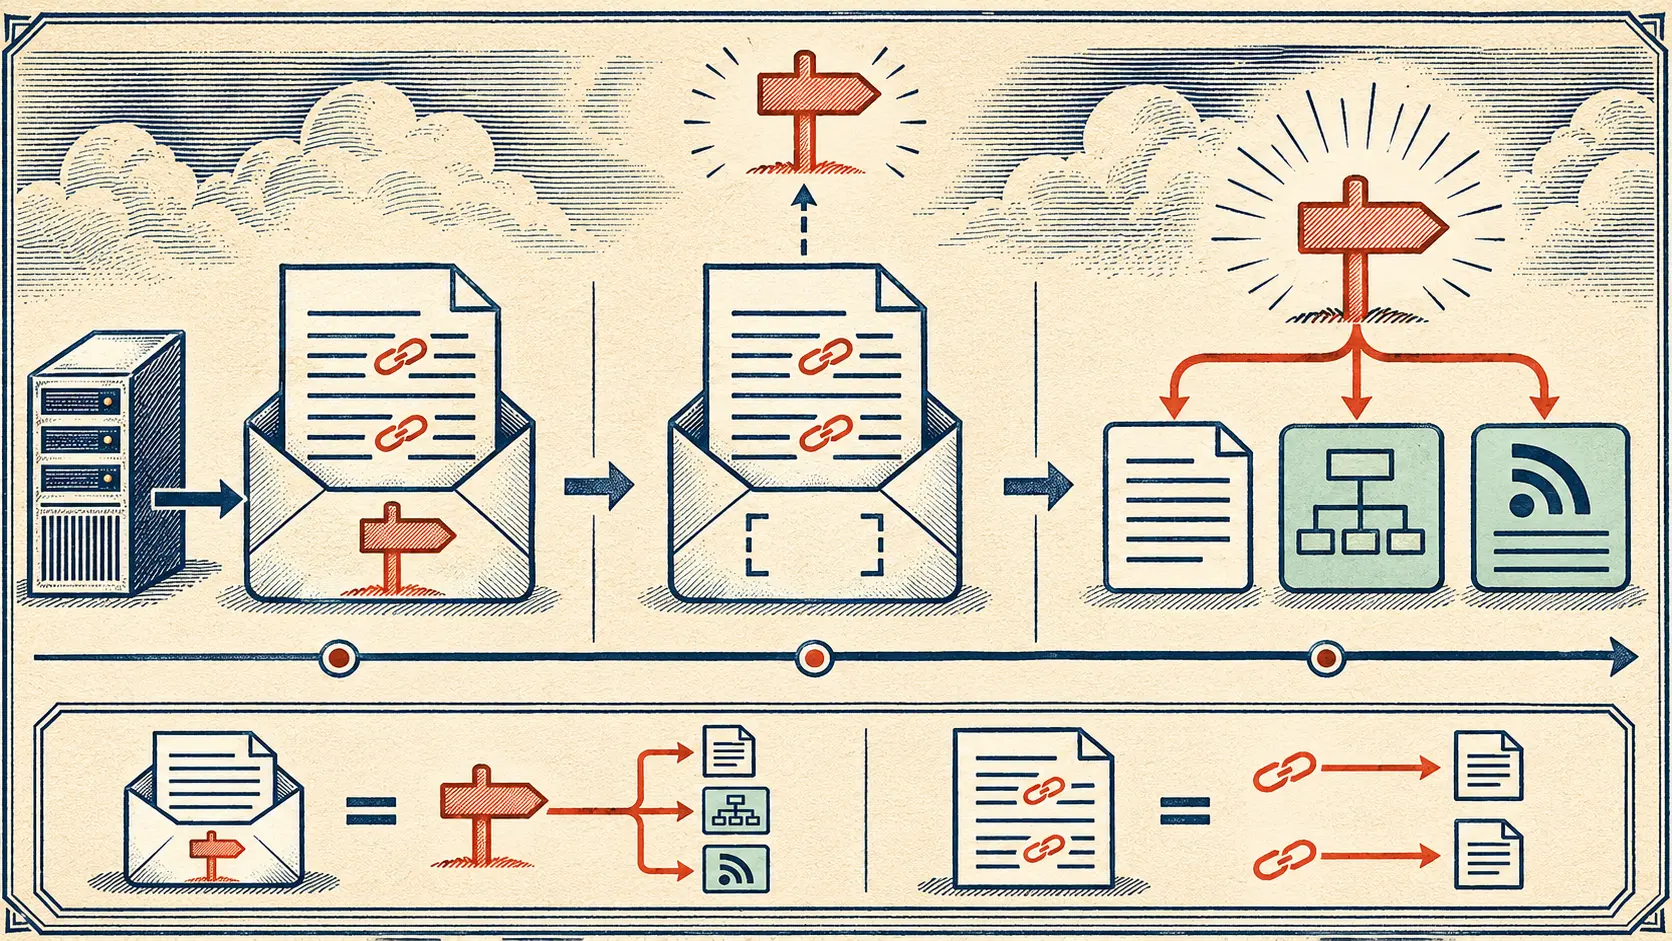
Un lien inscrit dans une page HTML est visible dans le document. Un navigateur peut lire l'élément LINK ou un lien dans le contenu et choisir ce qu'il fera de cette relation. Mais une ressource sur le Web peut aussi être livrée sous un autre format. Si l'information sur ses relations n'existe que dans le corps HTML, un lecteur d'une autre représentation peut ne jamais la recevoir. L'en-tête HTTP offre un emplacement avant même l'analyse du corps.
Le standard HTTP/1.1 de janvier 1997, RFC 2068, proposait précisément cela. Sa section 19.6.2.4 définissait Link comme un champ permettant de décrire la relation entre deux ressources, d'ordinaire la ressource demandée et une autre. Une entité pouvait porter plusieurs valeurs. Des paramètres précisaient la relation (rel), un intitulé destiné aux humains (title) ou un autre point d'ancrage (anchor). Le document comparait explicitement le champ à l'élément LINK du HTML.
Cette place dans la réponse change ce que peut voir un client. Une page HTML donne ses liens sous une forme que comprend un lecteur HTML. Un champ HTTP accompagne aussi une réponse dont le contenu n'est pas du HTML. Le client capable de lire ce champ obtient le lien typé avant de traiter le format. Cela lui permet de connaître la relation; le choix de récupérer la cible ou d'utiliser cette relation reste une décision de son application.
RFC 2068 rangeait le champ parmi les fonctions supplémentaires. Il décrivait à proximité des méthodes de requête LINK et UNLINK, destinées à établir ou retirer des relations. Les méthodes et le champ sont deux mécanismes distincts. Le retour ultérieur de l'en-tête ne constitue pas un retour de ces méthodes. Le mot « lien » ne suffit pas à fusionner leurs histoires.
La révision de 1999 laisse un emplacement vide
En juin 1999, RFC 2616 a remplacé RFC 2068 sans conserver la définition du champ Link. Le motif n'a pas besoin d'être deviné : RFC 5988, publié plus tard, rapporte que le retrait venait du manque d'expérience de mise en œuvre. Les rédacteurs de la grande révision HTTP/1.1 n'avaient pas encore assez de pratique sur laquelle appuyer ce mécanisme général.
Le constat concerne la place du champ dans une norme. Il ne fournit pas un recensement des serveurs et navigateurs de 1999. Une liste datée des implémentations et des réponses conservées établirait leur comportement réel. La raison donnée par RFC 5988 suffit cependant à révéler le pari des rédacteurs : une fonction plausible, déjà publiée, pouvait sortir de la prochaine édition si sa vie dans le logiciel n'était pas assez démontrée.
L'omission avait une autre conséquence. RFC 5988 dit qu'elle a rendu le statut de Link incertain. Certains envisageaient donc de créer des en-têtes propres à chaque application plutôt que de reprendre un nom dont la position dans HTTP était floue. La multiplication de petits champs spécialisés aurait dispersé une question commune : comment une ressource peut-elle annoncer une relation lorsque sa représentation change de format ?
Le texte de 2010 relève également qu'après le retrait certains agents utilisateurs avaient implémenté le champ, notamment pour les feuilles de style, et que d'autres usages étaient apparus. Il parle de certains agents, pas de tous. Cette observation explique pourquoi le sujet est revenu avec de nouveaux exemples, sans transformer une mention de déploiement en chiffre de marché inventé.
Le retour ne remet pas le lien en prison dans HTML
RFC 5988, en octobre 2010, a redéfini Link avec une syntaxe actualisée qui restait compatible avec l'ancienne. Surtout, il a formulé la relation à un niveau plus général. Un lien typé possède un contexte, un type de relation, une cible et éventuellement des attributs de cible. On peut exprimer cette relation dans du HTML, dans Atom ou dans un en-tête HTTP. Son sens ne dépend plus d'une unique manière de l'écrire.
La raison pratique est facile à imaginer : une même ressource peut avoir plusieurs représentations. Si sa relation n'est cachée que dans une version HTML, le client qui reçoit une autre version perd cette information. Un en-tête peut la porter à côté du corps, quel que soit le format du corps. Le HTML peut continuer à exprimer ses propres liens. Le standard ne décrète pas une règle universelle qui obligerait chaque application à privilégier l'en-tête plutôt que le contenu; il définit ce que les formes ont en commun.
RFC 5988 a aussi élargi le registre des types de relations issu d'Atom en y ajoutant des relations connues du HTML. Un nom de relation enregistré décrit le rapport entre deux ressources. Il ne garantit pas que la cible répondra ni que chaque logiciel agira sur cette relation. Une application peut comprendre « feuille de style », une autre peut s'intéresser à une licence ou à une version alternative. Le registre donne un vocabulaire commun; le logiciel exerce le choix.
En octobre 2017, RFC 8288 a remplacé RFC 5988 tout en gardant l'ossature : contexte, type de relation, cible, attributs facultatifs. Link restait une forme HTTP parmi d'autres formes de liens. Le document distingue par exemple le navigateur qui cherche une feuille de style dans HTML, éventuellement dans l'en-tête, d'une application Atom qui utilise d'autres relations. Le type de relation explique comment des ressources sont associées; il ne spécifie pas le format qui reviendra si l'on demande la cible.
Il serait facile de raconter 2010 comme le simple retour d'une phrase perdue en 1999. La différence est plus profonde. En 1997, le champ reprenait la forme d'un lien HTML dans HTTP. Les textes de 2010 et de 2017 expliquent une relation qui peut traverser plusieurs représentations et disposent d'un registre pour ses types. Le mécanisme a retrouvé sa place avec des limites mieux écrites.
Ce que le standard a appris en attendant
La chronologie paraît capricieuse si l'on confond publication et usage. Une proposition pouvait être écrite en 1997, perdre sa place en 1999 faute de pratique suffisante, puis retrouver un standard propre en 2010 quand de nouveaux besoins et quelques usages étaient identifiés. Le document de 2017 a poursuivi le travail. À chaque étape, le texte changeait le statut du champ; les logiciels en circulation donnaient plus ou moins de poids à cette décision.
L'enjeu dépasse un nom d'en-tête. Une relation inscrite seulement dans le corps HTML appartient à une représentation particulière. Une relation transportée avec la réponse HTTP peut rester visible quand le corps adopte une autre forme. Cela donne à l'éditeur et au client un terrain commun pour les liens typés sans imposer le HTML à toutes les ressources.
Il manque une preuve précise pour dresser une courbe de déploiement : des versions datées d'agents utilisateurs et de serveurs, ou des traces de réponses conservées. Les RFC établissent déjà l'arc institutionnel. Le champ a été défini, écarté pour manque d'expérience, puis réintroduit parce que les relations entre ressources continuaient à demander un lieu indépendant de la page.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé au Cercle stratégique
Cercle stratégique
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre le Cercle stratégiqueRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance