Resumen
- RFC 2068, de enero de 1997, definió el campo
Linken una respuesta HTTP para describir relaciones entre recursos, por lo general entre el solicitado y otro. Permitía varios enlaces y tomaba como referencia la semántica del elementoLINKde HTML. - RFC 5988, de octubre de 2010, documentó que el campo salió de RFC 2616, de junio de 1999, porque entonces faltaba experiencia de implementación. La omisión dejó dudoso su estatus pese a usos posteriores en algunos agentes y nuevos casos de aplicación.
- RFC 5988 devolvió
Linkcon un modelo de relaciones tipadas independiente del formato de una página. RFC 8288, de octubre de 2017, reemplazó aquel documento y mantuvo el campo HTTP como una de las formas de expresar esas relaciones.
Un enlace fuera del documento
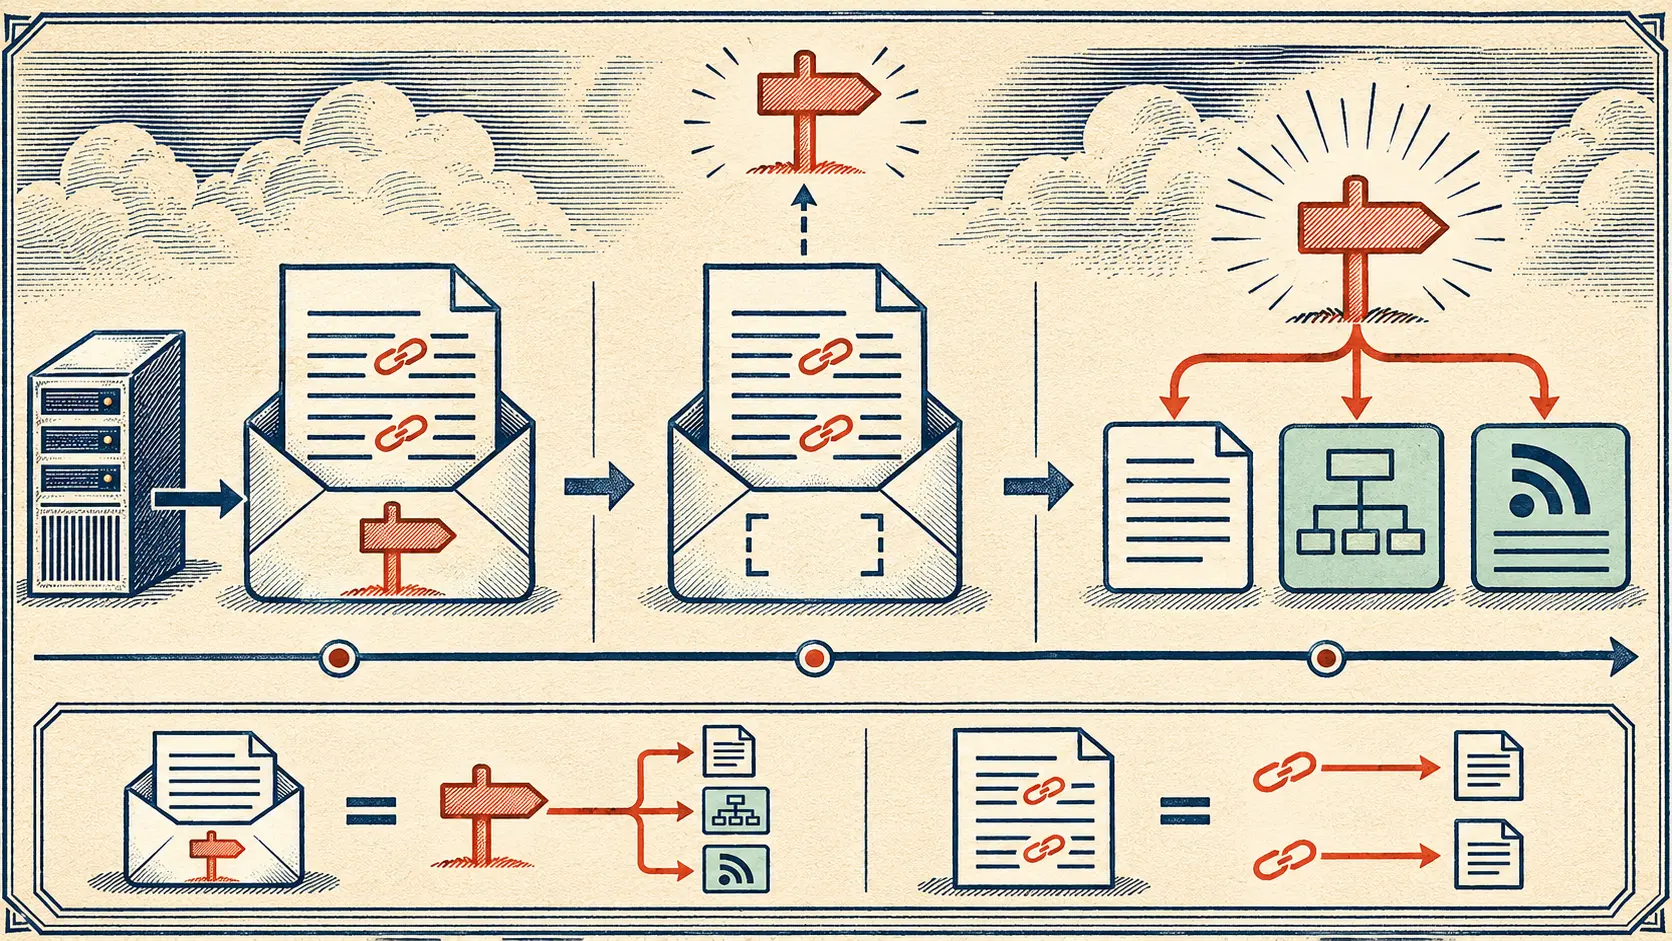
Un enlace en una página HTML vive dentro del contenido. El navegador interpreta la marca, reconoce una relación y decide si hace algo con ella. Esa disposición funciona mientras el documento que se entrega sea HTML. En una respuesta con otro formato, la misma información puede no aparecer en el cuerpo. Situar la relación en la cabecera HTTP la pone al alcance de un cliente antes de que este interprete la representación recibida.
Eso propuso RFC 2068, publicado en enero de 1997. Su apartado 19.6.2.4 describió un campo Link para unir conceptualmente dos recursos, normalmente el pedido y otro. Una entidad podía llevar varios valores. Los parámetros indicaban la relación (rel), un título legible (title) o un punto de origen diferente (anchor). El texto comparaba el campo con el elemento LINK de HTML: la idea de señalar un vecino salía de la página y viajaba en el sobre de la respuesta.
La diferencia tiene consecuencias para quien lee. Un recurso puede presentarse como HTML, texto o datos estructurados. Un programa que reconoce la cabecera puede descubrir la relación sin exigir que el cuerpo se disfrace de página. El campo identifica un vínculo tipado; la aplicación decide si consulta su destino, lo muestra o lo ignora. Nada en el nombre de la relación transporta por sí mismo el contenido del recurso señalado.
RFC 2068 colocó el campo entre las funciones adicionales. Cerca aparecían los métodos de petición LINK y UNLINK, diseñados para establecer y retirar relaciones. Son mecanismos distintos del campo en una respuesta. La historia de la cabecera que volvió en 2010 no es la historia de la vuelta de aquellos métodos.
La edición de 1999 deja un hueco
RFC 2616, publicado en junio de 1999, sustituyó a RFC 2068 sin conservar la definición de Link. La razón aparece explícita en el documento posterior: RFC 5988 dice que se retiró por falta de experiencia de implementación. Los editores de HTTP/1.1 disponían de una idea escrita, pero de poca práctica con la cual defender su permanencia en la nueva base.
Eso describe la decisión editorial del estándar. Para contar cuántos servidores o navegadores enviaron el campo en 1999 harían falta lanzamientos fechados y respuestas HTTP conservadas. La prueba normativa basta para una conclusión más precisa: publicar una función no le garantiza plaza en la siguiente revisión si su comportamiento en el mundo real sigue poco documentado.
La retirada también sembró incertidumbre. RFC 5988 observa que algunas personas consideraban crear cabeceras específicas para cada aplicación en vez de reutilizar un campo Link de estatus ambiguo. El problema común podía dividirse en muchas grafías particulares. ¿Cómo expresa un recurso una relación con otro si el cliente recibe un formato distinto de HTML? El vacío en HTTP dejaba a cada aplicación margen para responder a su manera.
El documento de 2010 registra que algunos agentes de usuario implementaron el campo después, por ejemplo para hojas de estilo, y que aparecieron otros casos de uso. Su alcance es limitado: habla de algunos agentes, no de toda la población de software. Pero muestra que el asunto regresó a la mesa con experiencia adicional y una necesidad más visible.
La segunda vida del enlace no depende de HTML
RFC 5988, publicado en octubre de 2010, volvió a especificar Link con una sintaxis actualizada y compatible con la anterior. También separó la relación de la forma en que se escribe. Un enlace tipado tiene un contexto, un tipo de relación, un destino y posibles atributos del destino. Esos elementos pueden viajar en HTML, Atom o una cabecera HTTP. La relación no tiene que pertenecer exclusivamente a una representación.
Una misma dirección puede servir varias formas del recurso. Si la relación vive solo en el HTML, quien recibe otra forma pierde esa pista. Una cabecera puede acompañar la respuesta en cualquiera de los formatos. A la inversa, el enlace dentro del HTML sigue siendo útil para su lector. El estándar daba un modelo compartido y dejaba a las aplicaciones definir qué relaciones atendían y en qué soporte las buscaban.
La especificación de 2010 extendió el registro de tipos de relación nacido en Atom para incluir relaciones usadas en HTML. Registrar un tipo de relación permite nombrar qué significa el vínculo. No obliga a un cliente a visitar el destino, ni asegura que ese destino responda. Una aplicación puede atender a una hoja de estilo y otra a una licencia o una versión alternativa. Comparten vocabulario; no comparten necesariamente la acción.
RFC 8288, de octubre de 2017, reemplazó a RFC 5988 y conservó el modelo de contexto, relación, destino y atributos opcionales. Link siguió como una forma de transmitirlo en HTTP. Su ejemplo distingue la aplicación de navegación web, que busca stylesheet en HTML y opcionalmente en la cabecera, de una aplicación Atom que usa otras relaciones. El tipo de relación dice cómo se conectan recursos; el tipo de medio dice en qué formato viene la representación del destino. Son preguntas distintas.
Por eso el retorno de 2010 fue más que deshacer un borrado de 1999. El texto de 1997 había sacado de HTML la forma de un enlace. Los textos posteriores dieron a los enlaces una explicación común que alcanza varios formatos y un registro para sus significados. El campo volvió con una arquitectura más definida.
La norma siguió unas huellas que antes faltaban
La secuencia pierde rareza cuando se separa el papel del software. En 1997 la idea era suficientemente concreta para describirla. En 1999 la experiencia práctica resultaba insuficiente para retenerla. En 2010 el nuevo documento podía señalar ciertos usos y necesidades para escribir otra norma; en 2017 el modelo continuó bajo una revisión. Cada paso alteró la posición formal del campo. Lo que hacían los programas le daba peso a la decisión.
Hay algo en juego además de una línea de cabecera. Una relación encerrada en HTML solo acompaña esa representación. En HTTP puede viajar con una respuesta cuyo cuerpo tenga otro formato. Eso ofrece a editores y lectores un lugar común para describir conexiones tipadas sin convertir todos los recursos en páginas.
La prueba que falta para una historia detallada de adopción son versiones fechadas de clientes y servidores o capturas de respuestas. La cadena de RFC ya establece el cambio institucional: una función escrita y retirada volvió cuando relacionar recursos fuera del cuerpo HTML pasó a ser una necesidad suficientemente concreta.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para el Círculo Estratégico
Círculo Estratégico
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete al Círculo EstratégicoSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance