Résumé
- Les serveurs de collecte, introduits avec le client 5.0 en 2004, pouvaient accepter les résultats destinés à un serveur de travail indisponible.
- Le récit d'une panne en juin 2009 révèle le coût de cette organisation : entretien, capacité et équipes occupées à faire cohabiter ancien et nouveau systèmes.
Le 16 juin 2009, la science participative avait rendez-vous avec un disque de secours. Un serveur GPU de Folding@home avait subi une panne sévère et ne retrouvait plus sa partition racine. Deux autres avaient cédé sous la charge, avant d'être remis en route. Dans son compte rendu, Vijay Pande décrivait une équipe déjà très sollicitée par la mise en place d'une nouvelle infrastructure.
La scène administrative derrière le grand projet devenait visible : recevoir des résultats est un métier. On peut inviter la planète à calculer ; il faut ensuite tenir le guichet.
Folding@home avait commencé en octobre 2000 dans le laboratoire de Pande à Stanford University, d'après sa chronologie officielle. Des volontaires installaient un programme, laissaient leur ordinateur exécuter des tâches de simulation moléculaire et renvoyaient le résultat. Le propriétaire gardait la main sur sa machine, ses horaires et sa participation.
Le colis trouve un autre destinataire
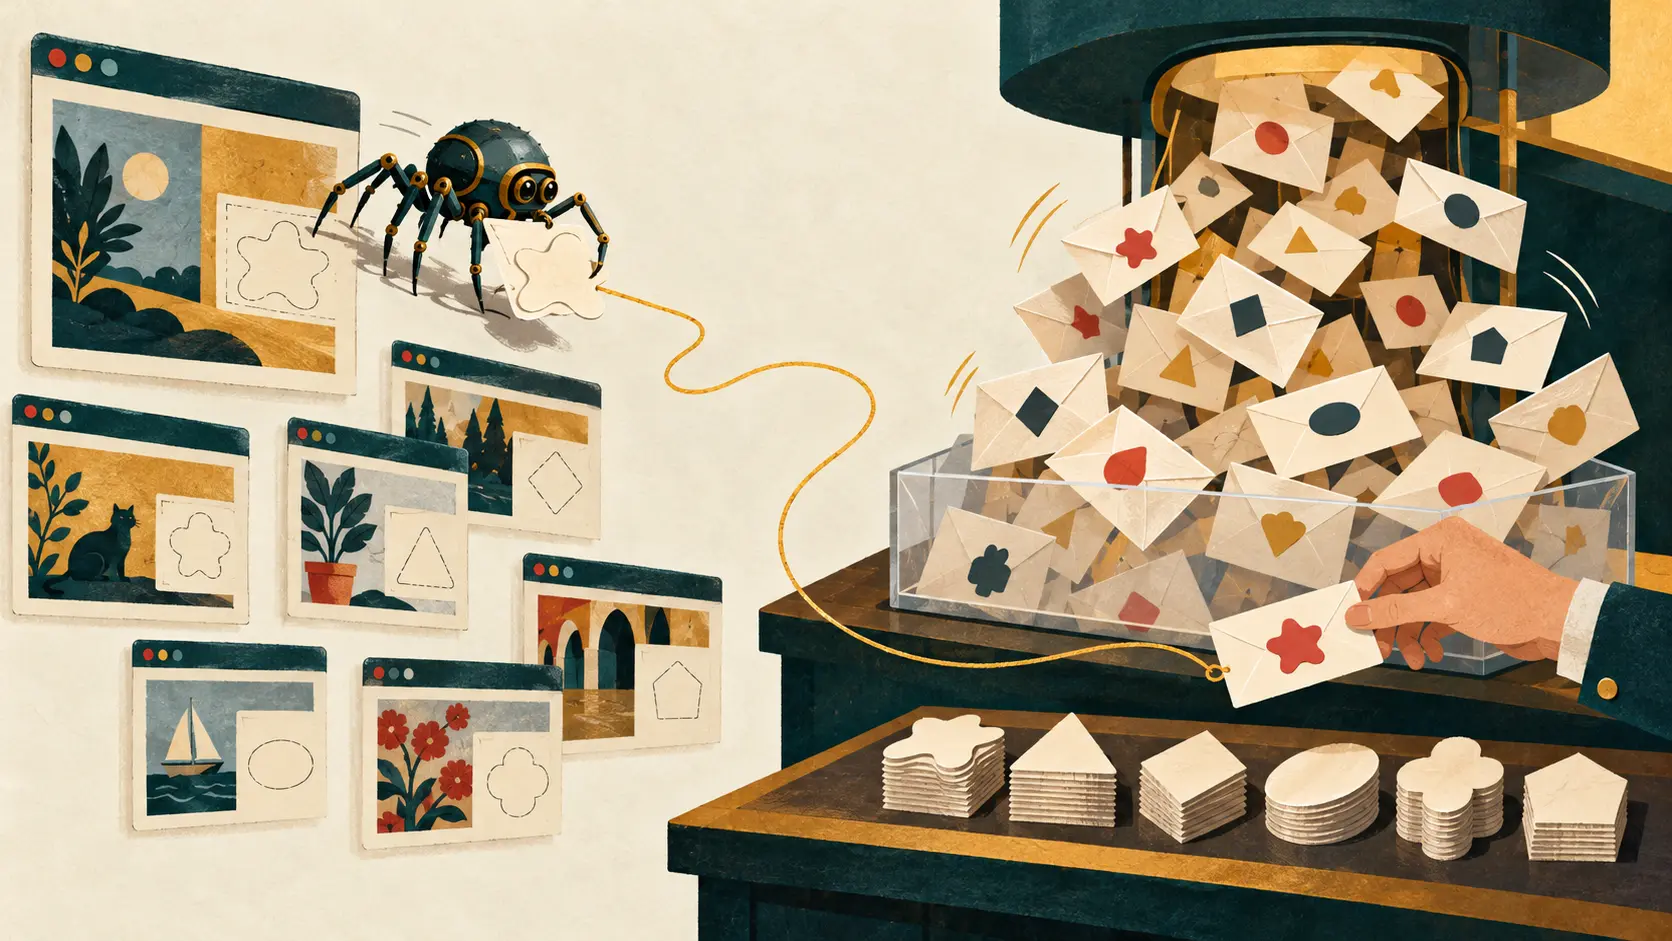
Dans la description du système publiée en 2009, les auteurs expliquent une modification de 2004 : la version 5.0 du client avait introduit les serveurs de collecte.
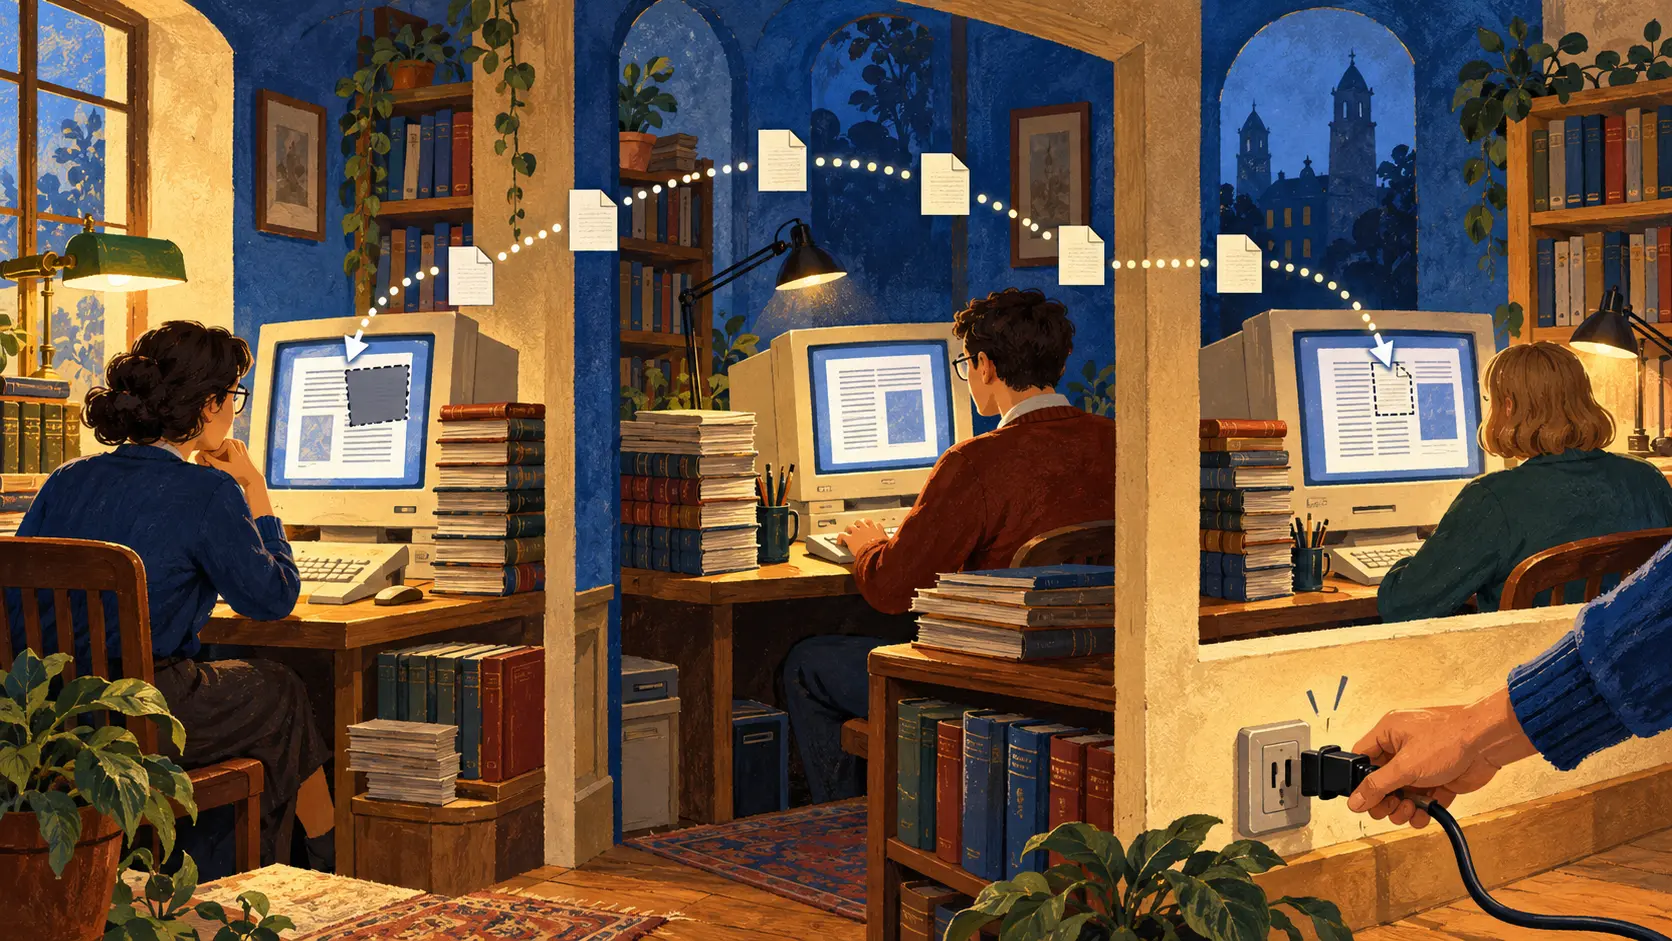
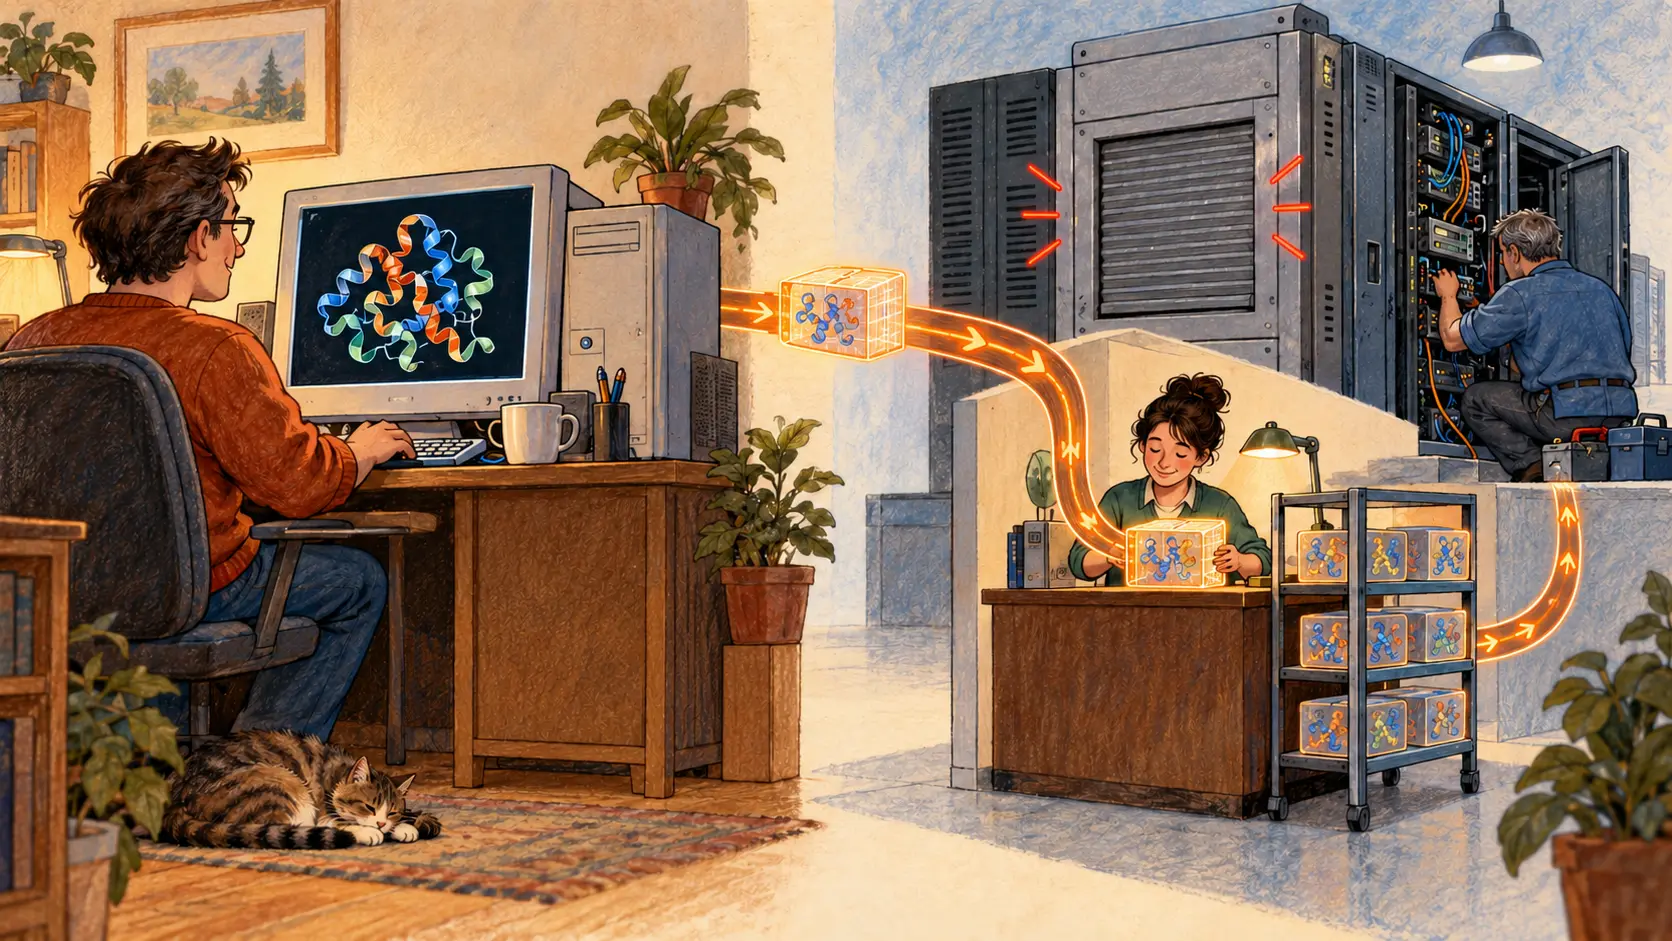
Le chemin normal ramenait un résultat au serveur de travail qui avait distribué la tâche. Si celui-ci devenait inaccessible, un serveur de collecte désigné pouvait prendre le relais. Il confrontait le retour aux enregistrements des tâches émises, acceptait le travail correspondant et lui attribuait son crédit. Le résultat serait transmis au serveur d'origine après son retour.
Le client pouvait alors demander une autre tâche à un serveur de travail disponible. L'attente changeait de camp. Le projet conservait le résultat en transit, tandis que le bénévole pouvait continuer à contribuer.
Ce détour protégeait aussi le redémarrage. Sans lui, les clients en attente risquaient de se précipiter ensemble sur la machine remise en service. Réparer un serveur pour lui offrir immédiatement une nouvelle indigestion constitue un programme de permanence assez peu séduisant.
Un don qu'on peut voir arriver
Les auteurs parlent aussi de connexions facturées au volume, de modems et de réglages limitant l'usage du processeur. Ils décrivent les points des participants et des équipes, ainsi que l'aide apportée dans les forums. Ces petites contraintes donnent sa taille humaine au réseau : une contribution vient d'une machine occupée, d'une connexion payée, d'une personne qui peut décider de partir.
La comptabilité des contributions rendait cette dépense visible. La réception permettait aux chercheurs d'en tirer parti. Entre l'invitation généreuse et le résultat utile s'intercalait donc un ensemble de tâches bien concrètes.
Le billet de juin 2009 montre leur fragilité en service. Pande attendait du nouveau système des serveurs de collecte plus fonctionnels et des serveurs de travail moins sujets aux redémarrages sous forte charge. Le déploiement commençait, et les pannes le ralentissaient.
Le constat final du document d'architecture est révélateur : le traitement, le stockage et l'exploitation des résultats limitaient désormais l'ajout de clients. La collecte avait son propre budget, ses propres ennuis et son propre personnel. Même la générosité distribuée finit par avoir besoin de quelqu'un à la réception.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance