Resumen
- La versión 5.0 del cliente incorporó servidores de recogida en 2004 para recibir resultados cuando el servidor de origen era inaccesible.
- El proyecto debía verificar, acreditar y reenviar cada entrega; las averías y la renovación de infraestructura de 2009 pusieron esa labor a la vista.
El voluntario podía prestar su ordenador a la ciencia y cumplir con su parte. La máquina recibía una tarea, calculaba y preparaba el resultado. Después quedaba una gestión poco épica: encontrar un servidor que lo recogiera.
Folding@home, nacido en octubre de 2000 en el laboratorio de Vijay Pande en Stanford University según su cronología, conectó esa aportación doméstica con la simulación molecular. El ordenador seguía siendo del participante. También lo eran la conexión, las preferencias de uso y la decisión de continuar.
El sistema necesitaba cuidar el trayecto de vuelta. Un cálculo terminado que no llega a sus investigadores todavía tiene una puerta por cruzar.
Entrega en una segunda ventanilla
El artículo técnico de 2009 fecha en 2004 una respuesta concreta: los servidores de recogida, incorporados con la versión 5.0 del cliente.
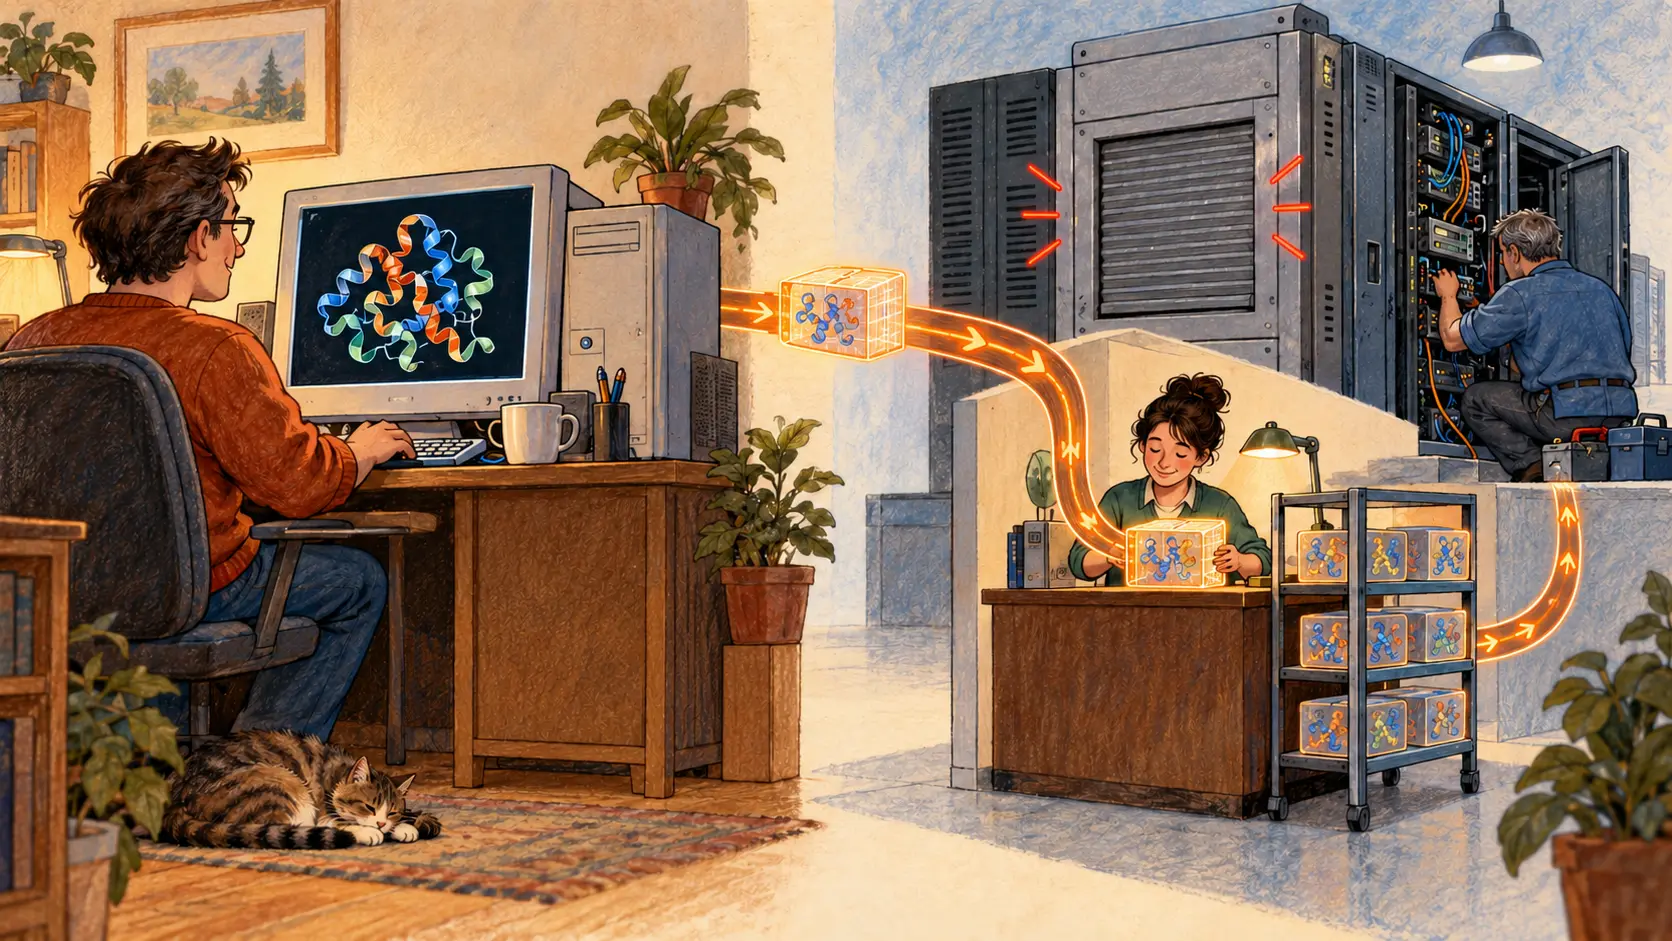
Normalmente, el resultado volvía al servidor de trabajo que había enviado la tarea. Cuando ese destino no respondía, el cliente podía recurrir a un servidor de recogida designado. Este comprobaba que el trabajo figurara entre las tareas emitidas, aceptaba la entrega y la acreditaba. El resultado se remitiría al servidor original cuando regresara.
Así, el cliente podía solicitar otra tarea a un servidor de trabajo activo. El proyecto se hacía cargo del paquete pendiente y el voluntario podía seguir. La recepción dejaba de depender de que una máquina concreta estuviera disponible en ese instante.
Había otra ventaja: al recuperarse, el servidor original encontraría menos clientes esperando para devolver trabajo. Una multitud de peticiones acumuladas podía tumbarlo otra vez. Ser reparado y recibir inmediatamente otra avalancha es una bienvenida de dudoso gusto.
La trastienda sale en el parte
El 16 de junio de 2009, Pande contó una jornada bastante menos elegante que un diagrama. Un servidor GPU había sufrido una avería grave y no encontraba su partición raíz. Otros dos habían caído por la carga, aunque ya estaban de nuevo en marcha. El equipo mantenía la infraestructura antigua mientras implantaba la nueva y andaba justo de personal.
Entre los beneficios esperados de la renovación estaban unos servidores de recogida más funcionales y menos reinicios de los servidores de trabajo bajo cargas fuertes. Las averías estaban retrasando el despliegue. La ventanilla alternativa también necesitaba mantenimiento.
El documento de arquitectura aporta la otra mitad humana del problema: participantes con conexiones cobradas por volumen, usuarios de módem y ajustes para limitar el uso del procesador. Añade los puntos de usuarios y equipos, y la ayuda de voluntarios en los foros. Contribuir tenía costes y merecía una confirmación visible.
En sus conclusiones, los autores situaban el límite para incorporar más clientes en el sistema que recibía, almacenaba y procesaba los resultados. El entusiasmo podía atraer más ordenadores. La ciencia seguía necesitando que alguien recogiera los deberes.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance