
Résumé
- L’EDPB estime qu’une approche dégagée par la Cour de justice pour les moteurs de recherche pourrait concerner les données sensibles résiduelles du scraping pour l’IA, mais seulement si quatre conditions sont réunies dans le cas considéré.
- Le projet lie cette possibilité limitée à des contrôles avant et après la collecte, pendant le développement du modèle et après son déploiement. Les commentaires sont ouverts jusqu’au 30 octobre 2026.
Une page accessible au public peut contenir des données personnelles qu’un développeur d’IA ne cherchait pas à collecter. Que faire si un vaste scraping fait remonter des informations sur la santé, les opinions politiques, l’origine ethnique ou l’orientation sexuelle d’une personne ? Le Comité européen de la protection des données (EDPB) aborde la question dans son projet de lignes directrices 03/2026 sur le scraping destiné au développement de l’IA générative. La consultation se termine le 30 octobre à 23 h 59 CET. Le texte reste un projet soumis aux commentaires ; il ne constitue ni une règle définitive ni une nouvelle dérogation au RGPD.
Le point de départ est la différence entre un traitement voulu et une collecte résiduelle. Si une organisation cherche délibérément à extraire des catégories particulières de données personnelles, l’article 9, paragraphe 2, du RGPD exige une dérogation spécifique, en plus d’une base juridique au titre de l’article 6. Le projet examine séparément les données qui apparaissent malgré des mesures destinées à empêcher leur collecte. L’EDPB estime que certains éléments du raisonnement de la Cour de justice dans l’arrêt de 2019 GC et autres c. CNIL (C‑136/17) pourraient être pertinents. Cet arrêt concernait le référencement et le déréférencement par un moteur de recherche, pas l’entraînement de modèles d’IA générative. Le projet ne transforme donc pas l’arrêt en autorisation générale pour les développeurs de modèles.
Quatre conditions doivent être examinées au cas par cas. Le traitement doit présenter des similitudes pertinentes avec l’activité d’un moteur de recherche ; les données doivent être fortuites et résiduelles, et non traitées intentionnellement ; il doit être difficile ou impossible pour le responsable de traitement de déterminer si ces données sont présentes et d’en empêcher la collecte ; enfin, il doit prendre, dans les limites de ses responsabilités, pouvoirs et capacités, des mesures pour empêcher leur diffusion.
Si les faits ne répondent pas à ces critères, le raisonnement relatif aux moteurs de recherche ne peut pas servir de voie générale pour contourner l’article 9.
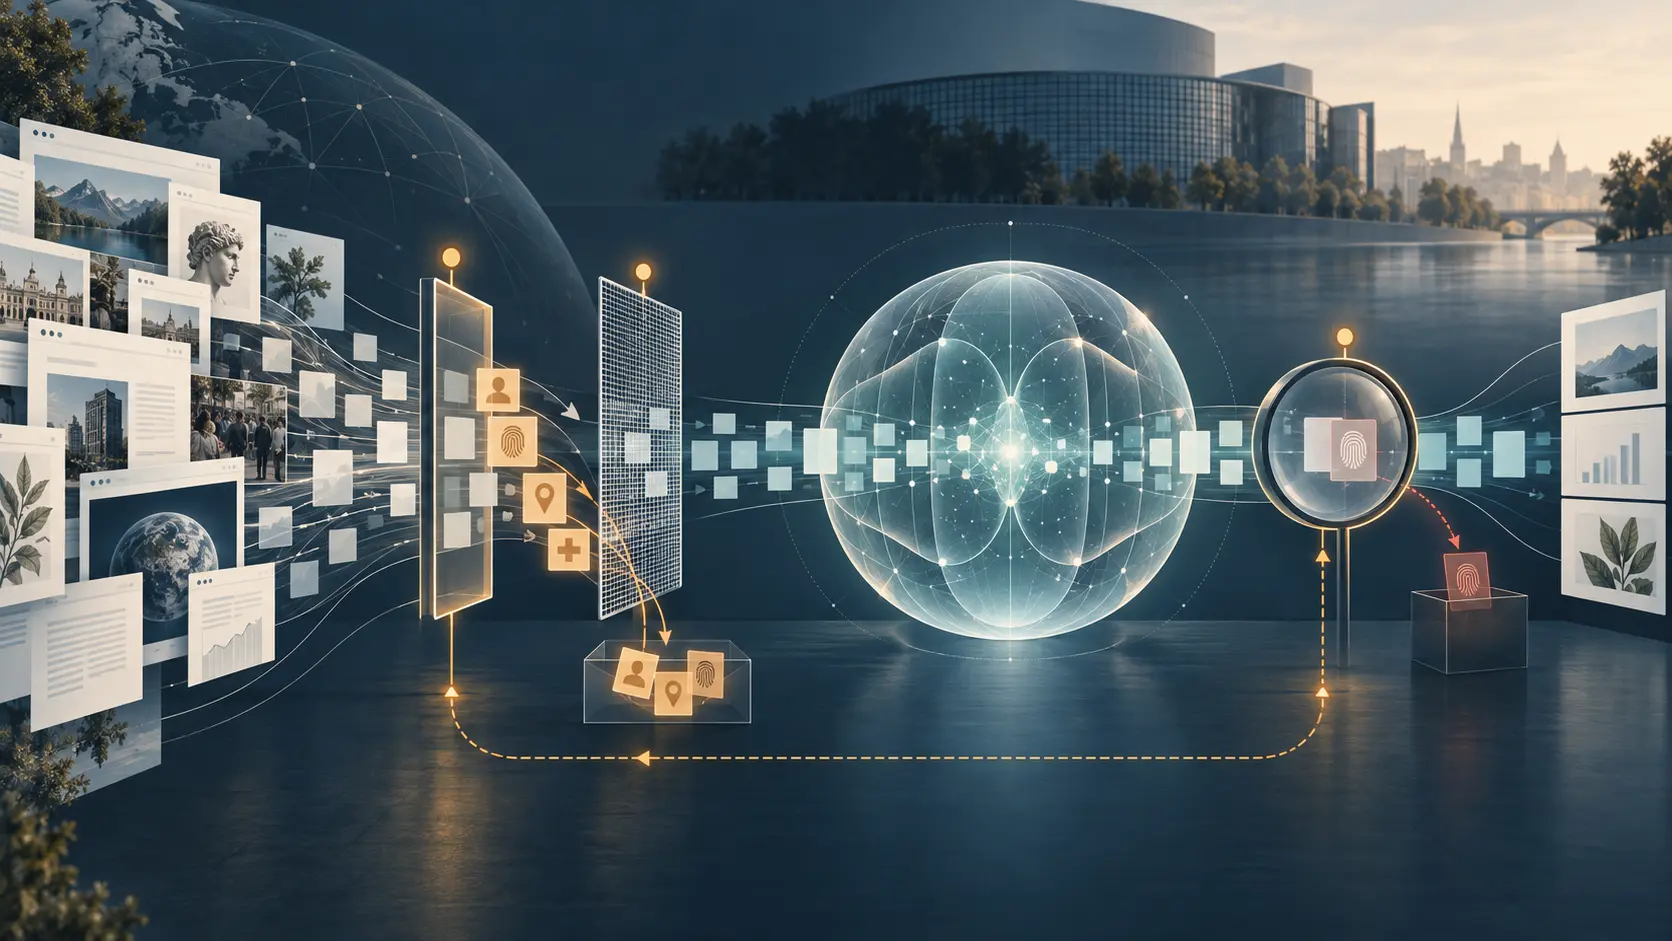
Le dispositif donne un sens opérationnel au mot « fortuit ». Avant la collecte, le responsable devrait définir des critères précis, appliquer des filtres et exclure les sites dont la structure contient régulièrement des données sensibles ; le projet cite notamment les sites principalement utilisés par des mineurs. Après la collecte, les données résiduelles devraient être supprimées immédiatement ou dès leur identification. Une demande d’une personne devrait entraîner la suppression lorsqu’elle indique de façon plausible que les données relèvent de l’interdiction de l’article 9.
Pendant le développement du modèle, il faudrait tester les risques d’extraction et d’attaque contre la vie privée, puis filtrer les sorties qui révéleraient ces données. Après le déploiement, le fournisseur du système d’IA devrait suivre en continu ses réponses, renforcer les filtres ou limiter certaines invites si des informations sensibles apparaissent, et envisager le désapprentissage du modèle — ou une méthode d’effet équivalent — si les progrès techniques le permettent.
L’EDPB attend aussi du responsable qu’il puisse démontrer la pertinence des quatre conditions et l’efficacité de ses mesures. Des vérifications régulières devraient couvrir le développement comme l’utilisation du modèle ; des mesures inefficaces appellent des contrôles nouveaux ou différents. L’obligation de rendre compte devient ainsi une trace opérationnelle : critères de collecte, exclusions de sources, suppressions, tests du modèle, incidents de sortie et mesures correctives doivent former un ensemble cohérent. Qualifier simplement la collecte de « fortuite » ne suffit pas.
Cette analyse des catégories particulières est distincte de celle de l’intérêt légitime. Le fait qu’une page soit publique ne vaut pas consentement à une collecte pour une finalité donnée, et l’absence de règle robots.txt ne constitue pas un consentement au sens du RGPD. Les restrictions d’un site peuvent toutefois compter dans l’évaluation des attentes raisonnables au sein du test de mise en balance de l’intérêt légitime. Elles modifient les faits à apprécier ; elles ne remplacent ni la base juridique ni les exigences de l’article 9.
L’effet pratique du projet est de déplacer la question en amont. Si les données sensibles sont difficiles à détecter parce que la collecte est indiscriminée, cette difficulté ne prouve pas, à elle seule, que leur traitement est résiduel. La voie proposée demande si le responsable a pris des mesures réalistes pour éviter la collecte, s’il pouvait repérer et retirer ce qui a échappé aux filtres, et s’il pouvait empêcher le modèle de le reproduire. La consultation permet de contester la clarté de ces attentes avant la finalisation du texte par l’EDPB.
Sources
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance